Kimi K3.1 Pro : prix API, banc d'essai et cas d'usage
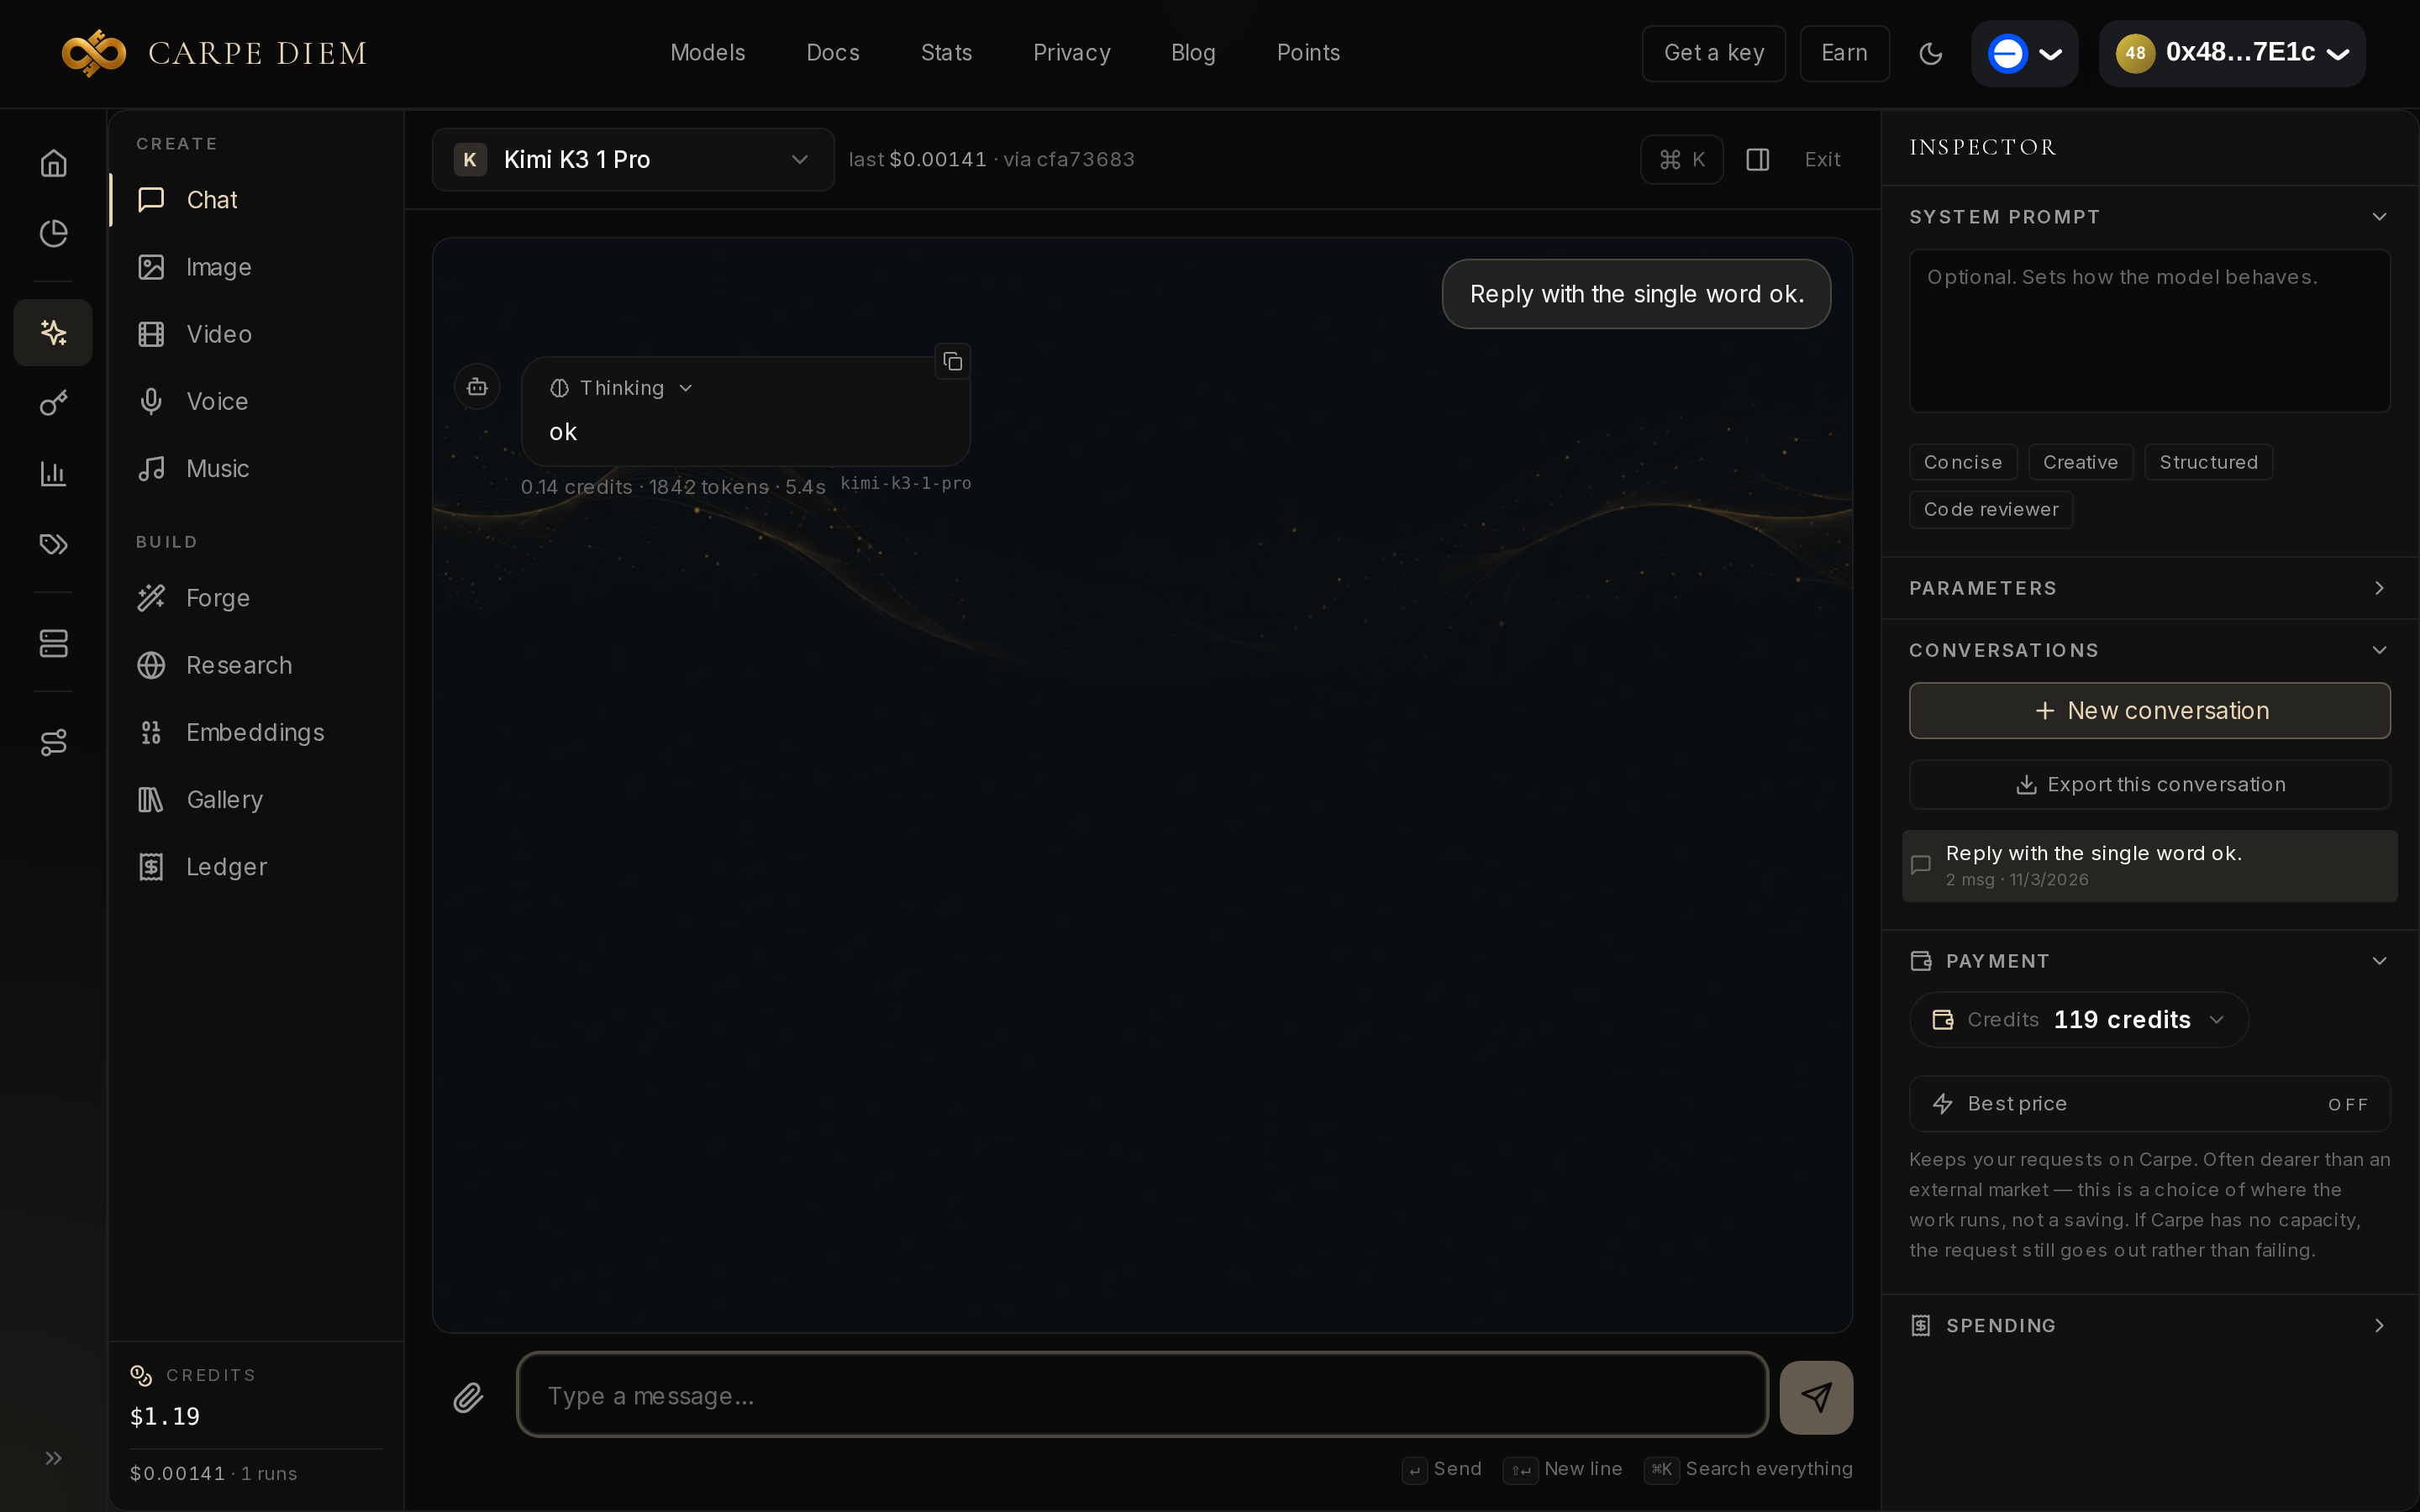
Kimi K3.1 Pro, le modèle que Moonshot AI a présenté le 23 octobre, est disponible sur Carpe Diem sous l'identifiant kimi-k3-1-pro. Au moment de notre essai, le 3 novembre, il coûtait 2,11 $ le million de tokens en entrée et 10,56 $ en sortie, contre 3,75 $ et 18,75 $ chez Venice. Il a réussi le calcul, le JSON et l'aiguille dans un texte long. Il se justifie surtout si votre pile est déjà construite autour de Kimi.
Kimi K3.1 Pro en bref
Moonshot présente K3.1 Pro comme le premier modèle de sa série K3.1, une version post-entraînée de Kimi K3, multimodale, avec un million de tokens de contexte, orientée code long, création 3D et recherche financière. L'annonce officielle promet aussi les poids complets pour le 4 novembre ; nous n'avons pas vérifié leur publication.
Le catalogue lui attribue la vision, le raisonnement, l'appel de fonctions, les sorties structurées, la recherche web et plusieurs images par requête. Il est classé anonymized : Venice transmet vos requêtes à Moonshot, qui en voit le contenu mais pas l'expéditeur. Si vos prompts doivent rester sur un modèle private, choisissez-en un autre.
Prix : 12,67 $ pour mille requêtes moyennes
Mille requêtes de 1 000 tokens en entrée et autant en sortie reviennent à 12,67 $ sur Carpe Diem, contre 22,50 $ en direct chez Venice. Le prix suit la capacité disponible dans la journée : vérifiez-le sur /models avant de budgéter un gros volume.
| Entrée / M | Sortie / M | 1 000 requêtes (1k / 1k) | Confidentialité | |
|---|---|---|---|---|
| Kimi K3.1 Pro (Carpe Diem) | 2,1114 $ | 10,5572 $ | 12,67 $ | anonymized |
| Kimi K3.1 Pro (Venice) | 3,7500 $ | 18,7500 $ | 22,50 $ | n/a |
| GPT-6.1 Terra | 0,5634 $ | 2,8172 $ | 3,38 $ | anonymized |
| Mercury 3 | 0,0563 $ | 0,1972 $ | 0,25 $ | anonymized |
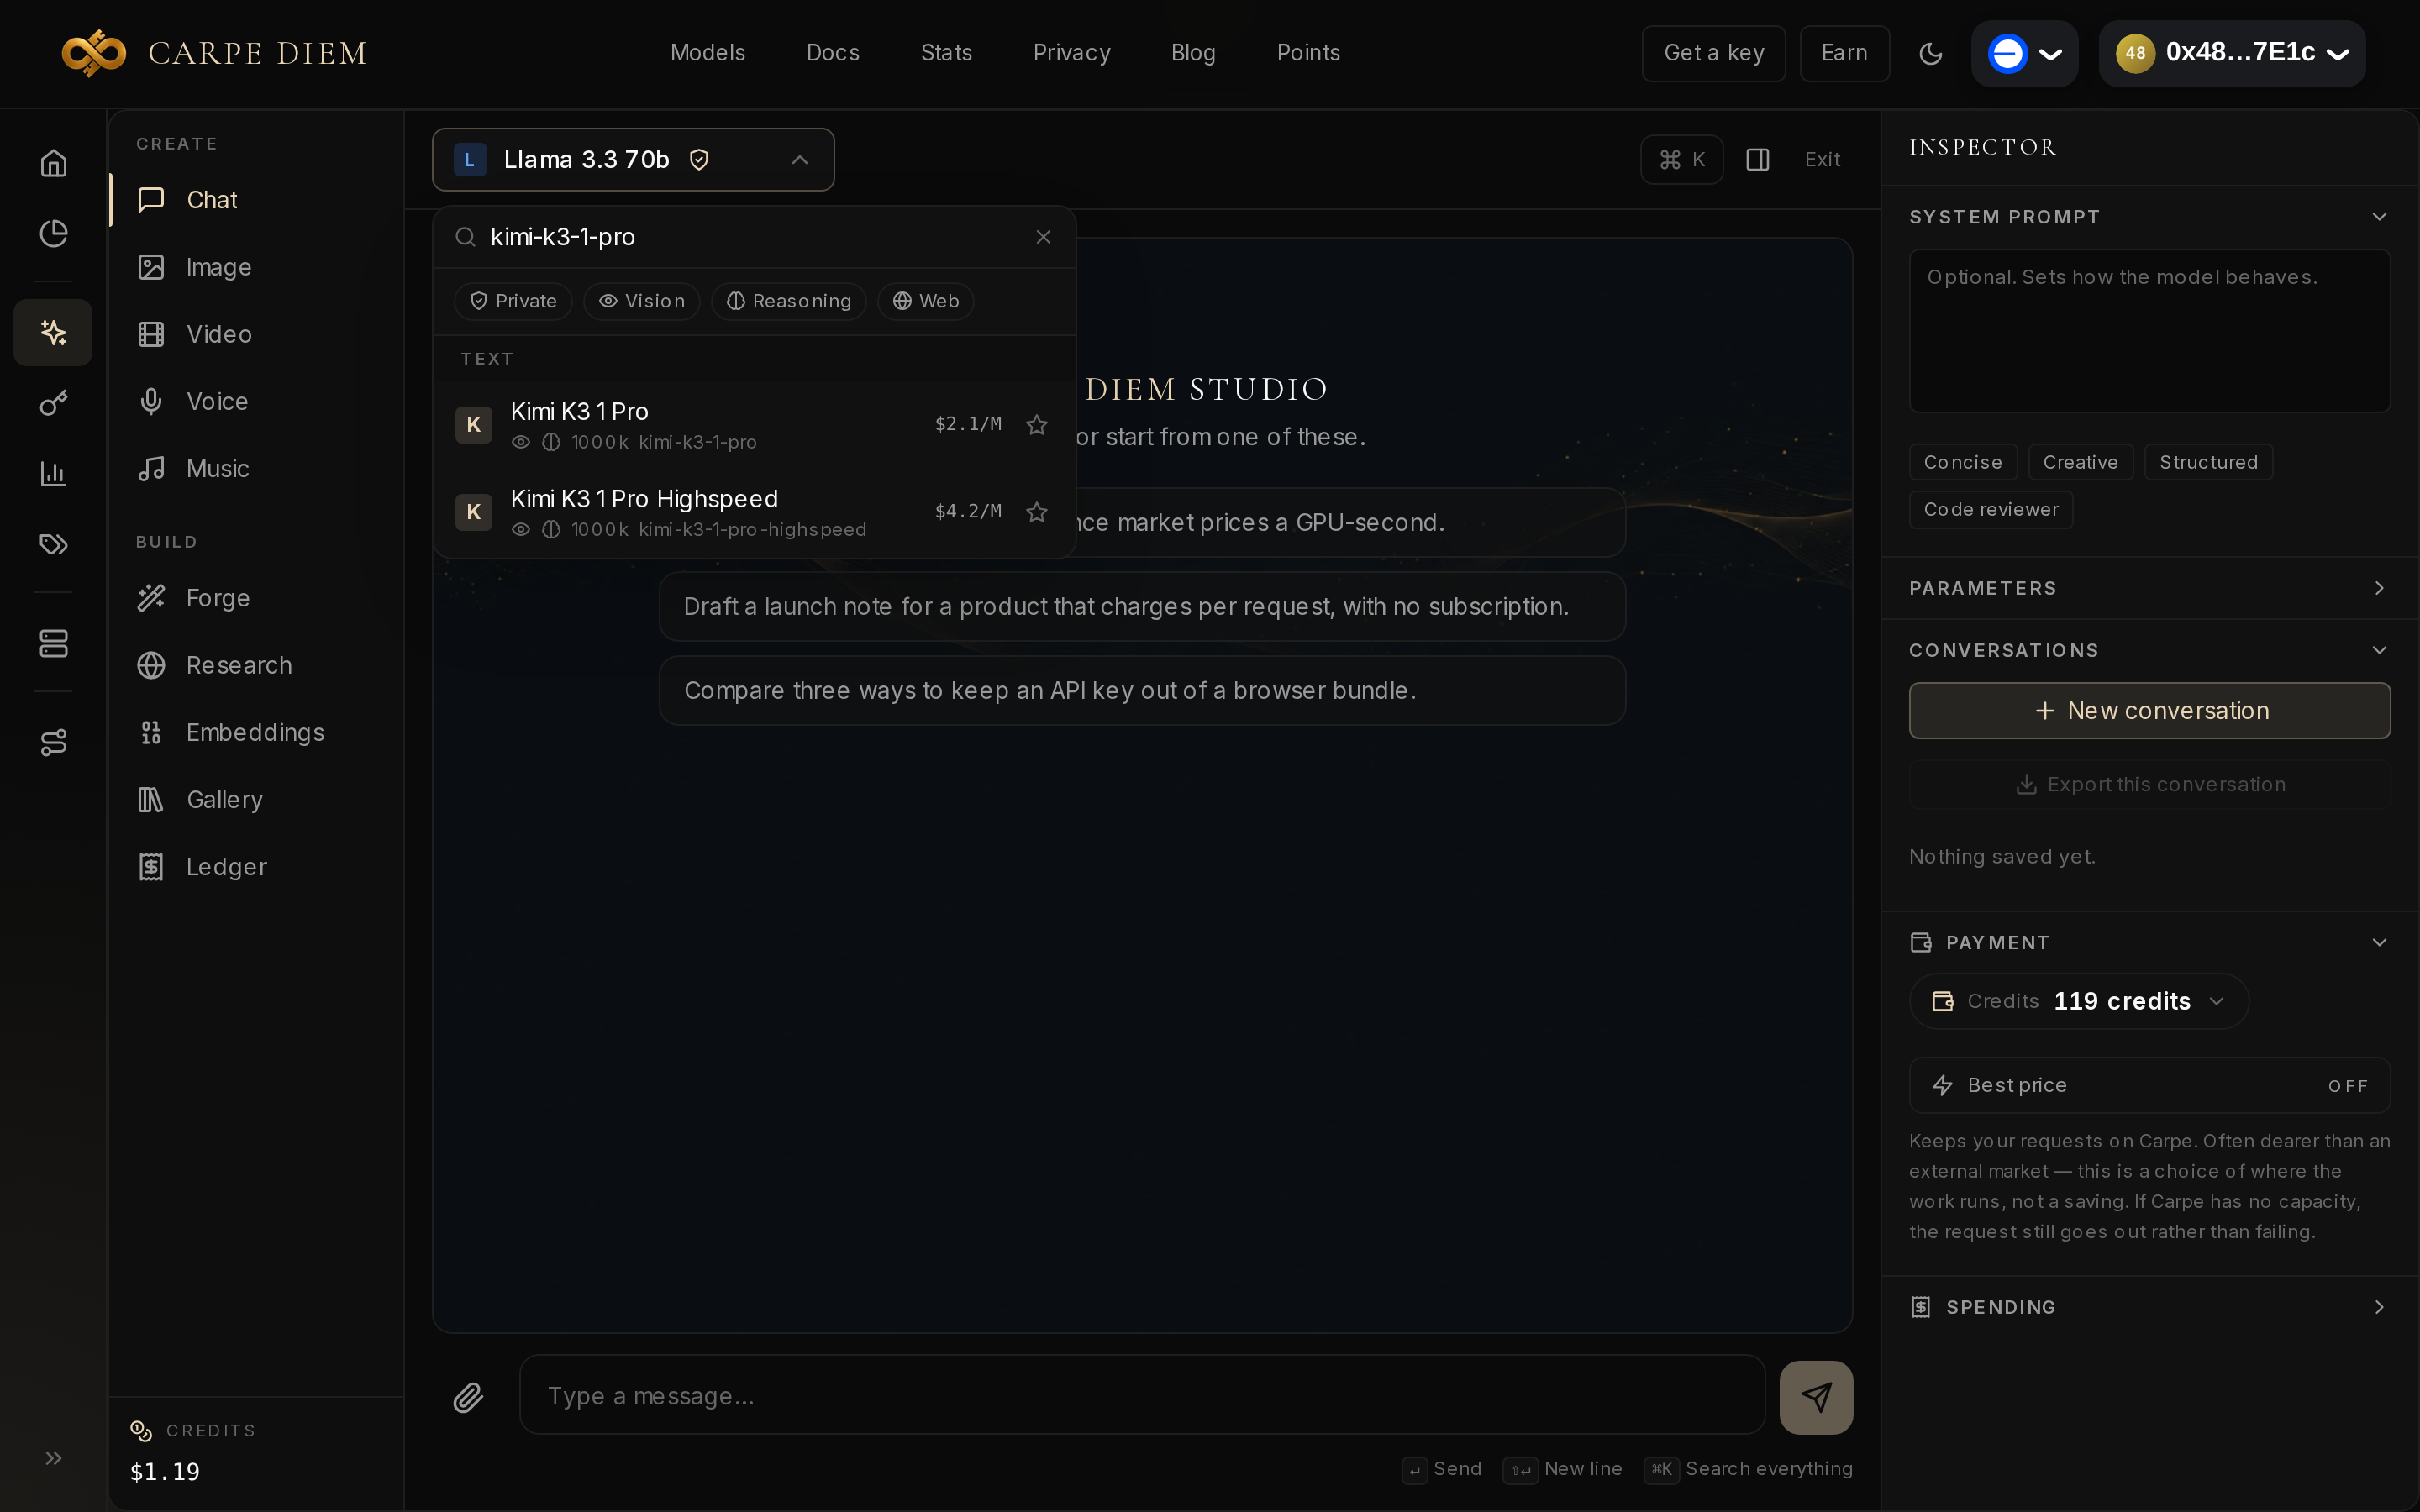
La grille de Moonshot liste ce modèle à 2 $ et 10 $ le million. La variante Highspeed, que nous n'avons pas mesurée, s'affichait à environ le double dans le sélecteur du Hub.
Pour des appels courts et nombreux, ajoutez venice_parameters.include_venice_system_prompt: false : sans ce champ, Venice ajoute son propre prompt système, environ 1 700 tokens facturés à chaque appel.
Banc d'essai : JSON conforme en 4,8 s, calcul en 24,9 s
Le banc complet a coûté environ 0,03 $. Kimi a trouvé le seuil de rentabilité (40 000 requêtes) en 24,9 s, rendu un JSON conforme au schéma en 4,8 s et retrouvé la référence 7319-KESTREL cachée dans un texte d'environ 2 500 mots. Le français, 114 mots sur le rôle d'un routeur de modèles, est correct à la lecture. Moonshot indique que le modèle raisonne toujours ; nous n'avons pas varié reasoning_effort.
| Épreuve | Résultat | Durée |
|---|---|---|
| Raisonnement (seuil de rentabilité) | juste, 40000 | 24,9 s |
| Extraction JSON | conforme | 4,8 s |
| Aiguille dans ~2 500 mots | trouvée | 8,1 s |
| Rédaction en français | correcte, sans faute | 21,6 s |
Code JavaScript (compressRanges) |
6/6 hors harnais | 12,1 s |
Le harnais de l'épreuve de code n'a pas retrouvé son fichier de tests et a affiché 0/6. Le modèle avait pourtant renvoyé une fonction compressRanges complète : extraite et exécutée à part, elle passe les 6 cas.
Kimi, GPT-6.1 Terra ou Mercury 3 ?
Pour extraire du JSON ou faire un calcul court, nous prendrions Mercury 3 : il réussit le même genre d'épreuves pour une fraction du prix, environ quarante fois moins cher en entrée.
GPT-6.1 Terra reste lui aussi moins cher que Kimi, avec la vision et le même statut anonymized. Kimi a du sens dans trois cas : vous voulez précisément le modèle Moonshot pour du code agent, vous avez besoin de son million de tokens de contexte, ou votre pile est déjà branchée sur Kimi.
Premier appel avec une clé Carpe Diem
Créez une clé cdm_ dans le tableau de bord, puis exportez CARPE_API_KEY=cdm_your_key_here et OPENAI_BASE_URL=https://carpe-diem.xyz/api/operator/v1. L'extrait n'installe rien : urllib suffit.
import json
import os
import urllib.request

url = os.environ["OPENAI_BASE_URL"].rstrip("/") + "/chat/completions"
req = urllib.request.Request(
    url,
    data=json.dumps(
        {
            "model": "kimi-k3-1-pro",
            "messages": [{"role": "user", "content": "Reply with the single word ok."}],
            "venice_parameters": {"include_venice_system_prompt": False},
        }
    ).encode(),
    headers={
        "Authorization": "Bearer " + os.environ["CARPE_API_KEY"],
        "Content-Type": "application/json",
    },
    method="POST",
)
with urllib.request.urlopen(req, timeout=90) as resp:
    headers = dict(resp.headers)
    body = json.loads(resp.read().decode())

print(body["choices"][0]["message"]["content"])
usage = body.get("usage") or {}
print("prompt_tokens", usage.get("prompt_tokens"))
print("completion_tokens", usage.get("completion_tokens"))
print("x-carpe-cost-usdc-micro", headers.get("X-Carpe-Cost-Usdc-Micro") or headers.get("x-carpe-cost-usdc-micro"))
print("model", body.get("model"))
ok
prompt_tokens 92
completion_tokens 61
x-carpe-cost-usdc-micro 839
model kimi-k3-1-pro
Méthode : essai du 3 novembre 2026, une exécution par épreuve, texte court seulement. Le premier token, la vision, les outils, reasoning_effort, la fenêtre d'un million de tokens et Highspeed n'ont pas été testés.
Le Hub est décrit dans l'article Create Hub ; l'API, dans le SDK Python. Créez une clé, lancez l'extrait, ou ouvrez kimi-k3-1-pro dans le Create Hub.