Kimi K3.1 Pro: preço de API, banco de ensaio e quando usar
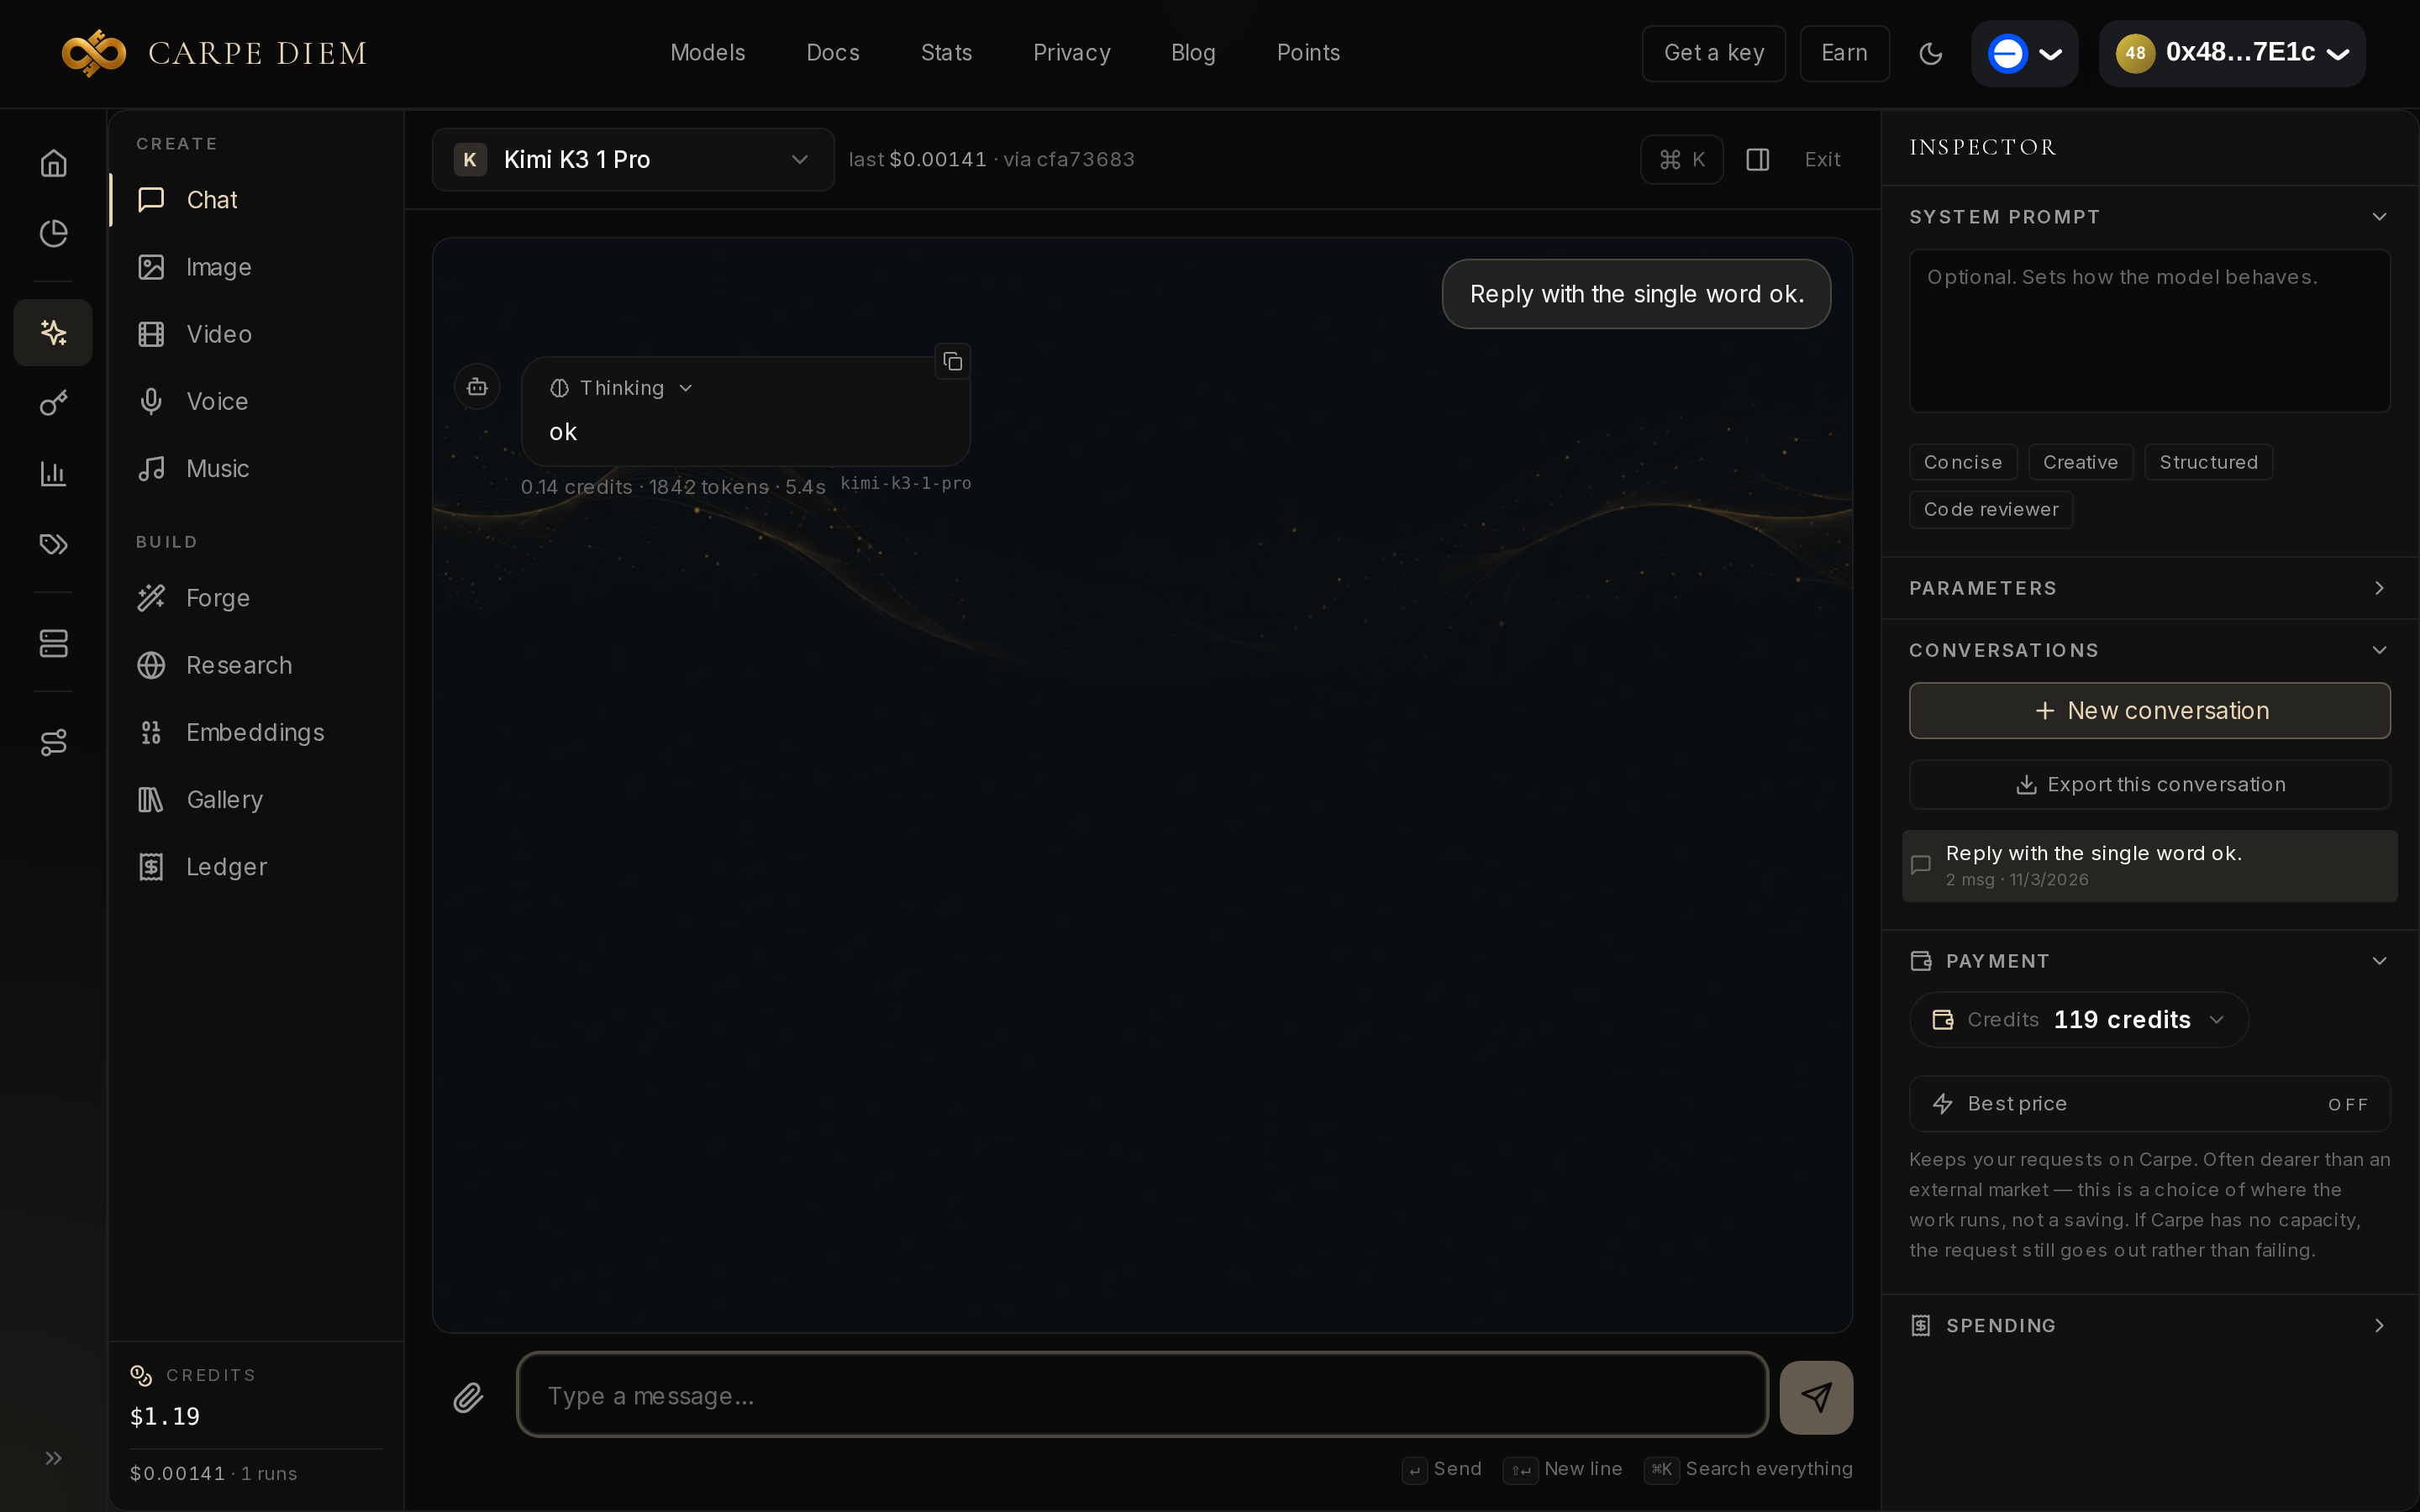
Kimi K3.1 Pro, o modelo que a Moonshot AI apresentou a 23 de outubro, está disponível na Carpe Diem com o identificador kimi-k3-1-pro. No momento do nosso ensaio, a 3 de novembro, custava 2,11 $ o milhão de tokens de entrada e 10,56 $ o de saída, contra 3,75 $ e 18,75 $ na Venice. Acertou o cálculo, o JSON e a agulha num texto longo. Justifica-se sobretudo se a sua stack já está construída em torno do Kimi.
Kimi K3.1 Pro em poucas palavras
A Moonshot apresenta o K3.1 Pro como o primeiro modelo da série K3.1, uma versão pós-treinada do Kimi K3, multimodal, com um milhão de tokens de contexto, orientada para código longo, criação 3D e pesquisa financeira. O anúncio oficial promete também os pesos completos para 4 de novembro; não verificámos a publicação.
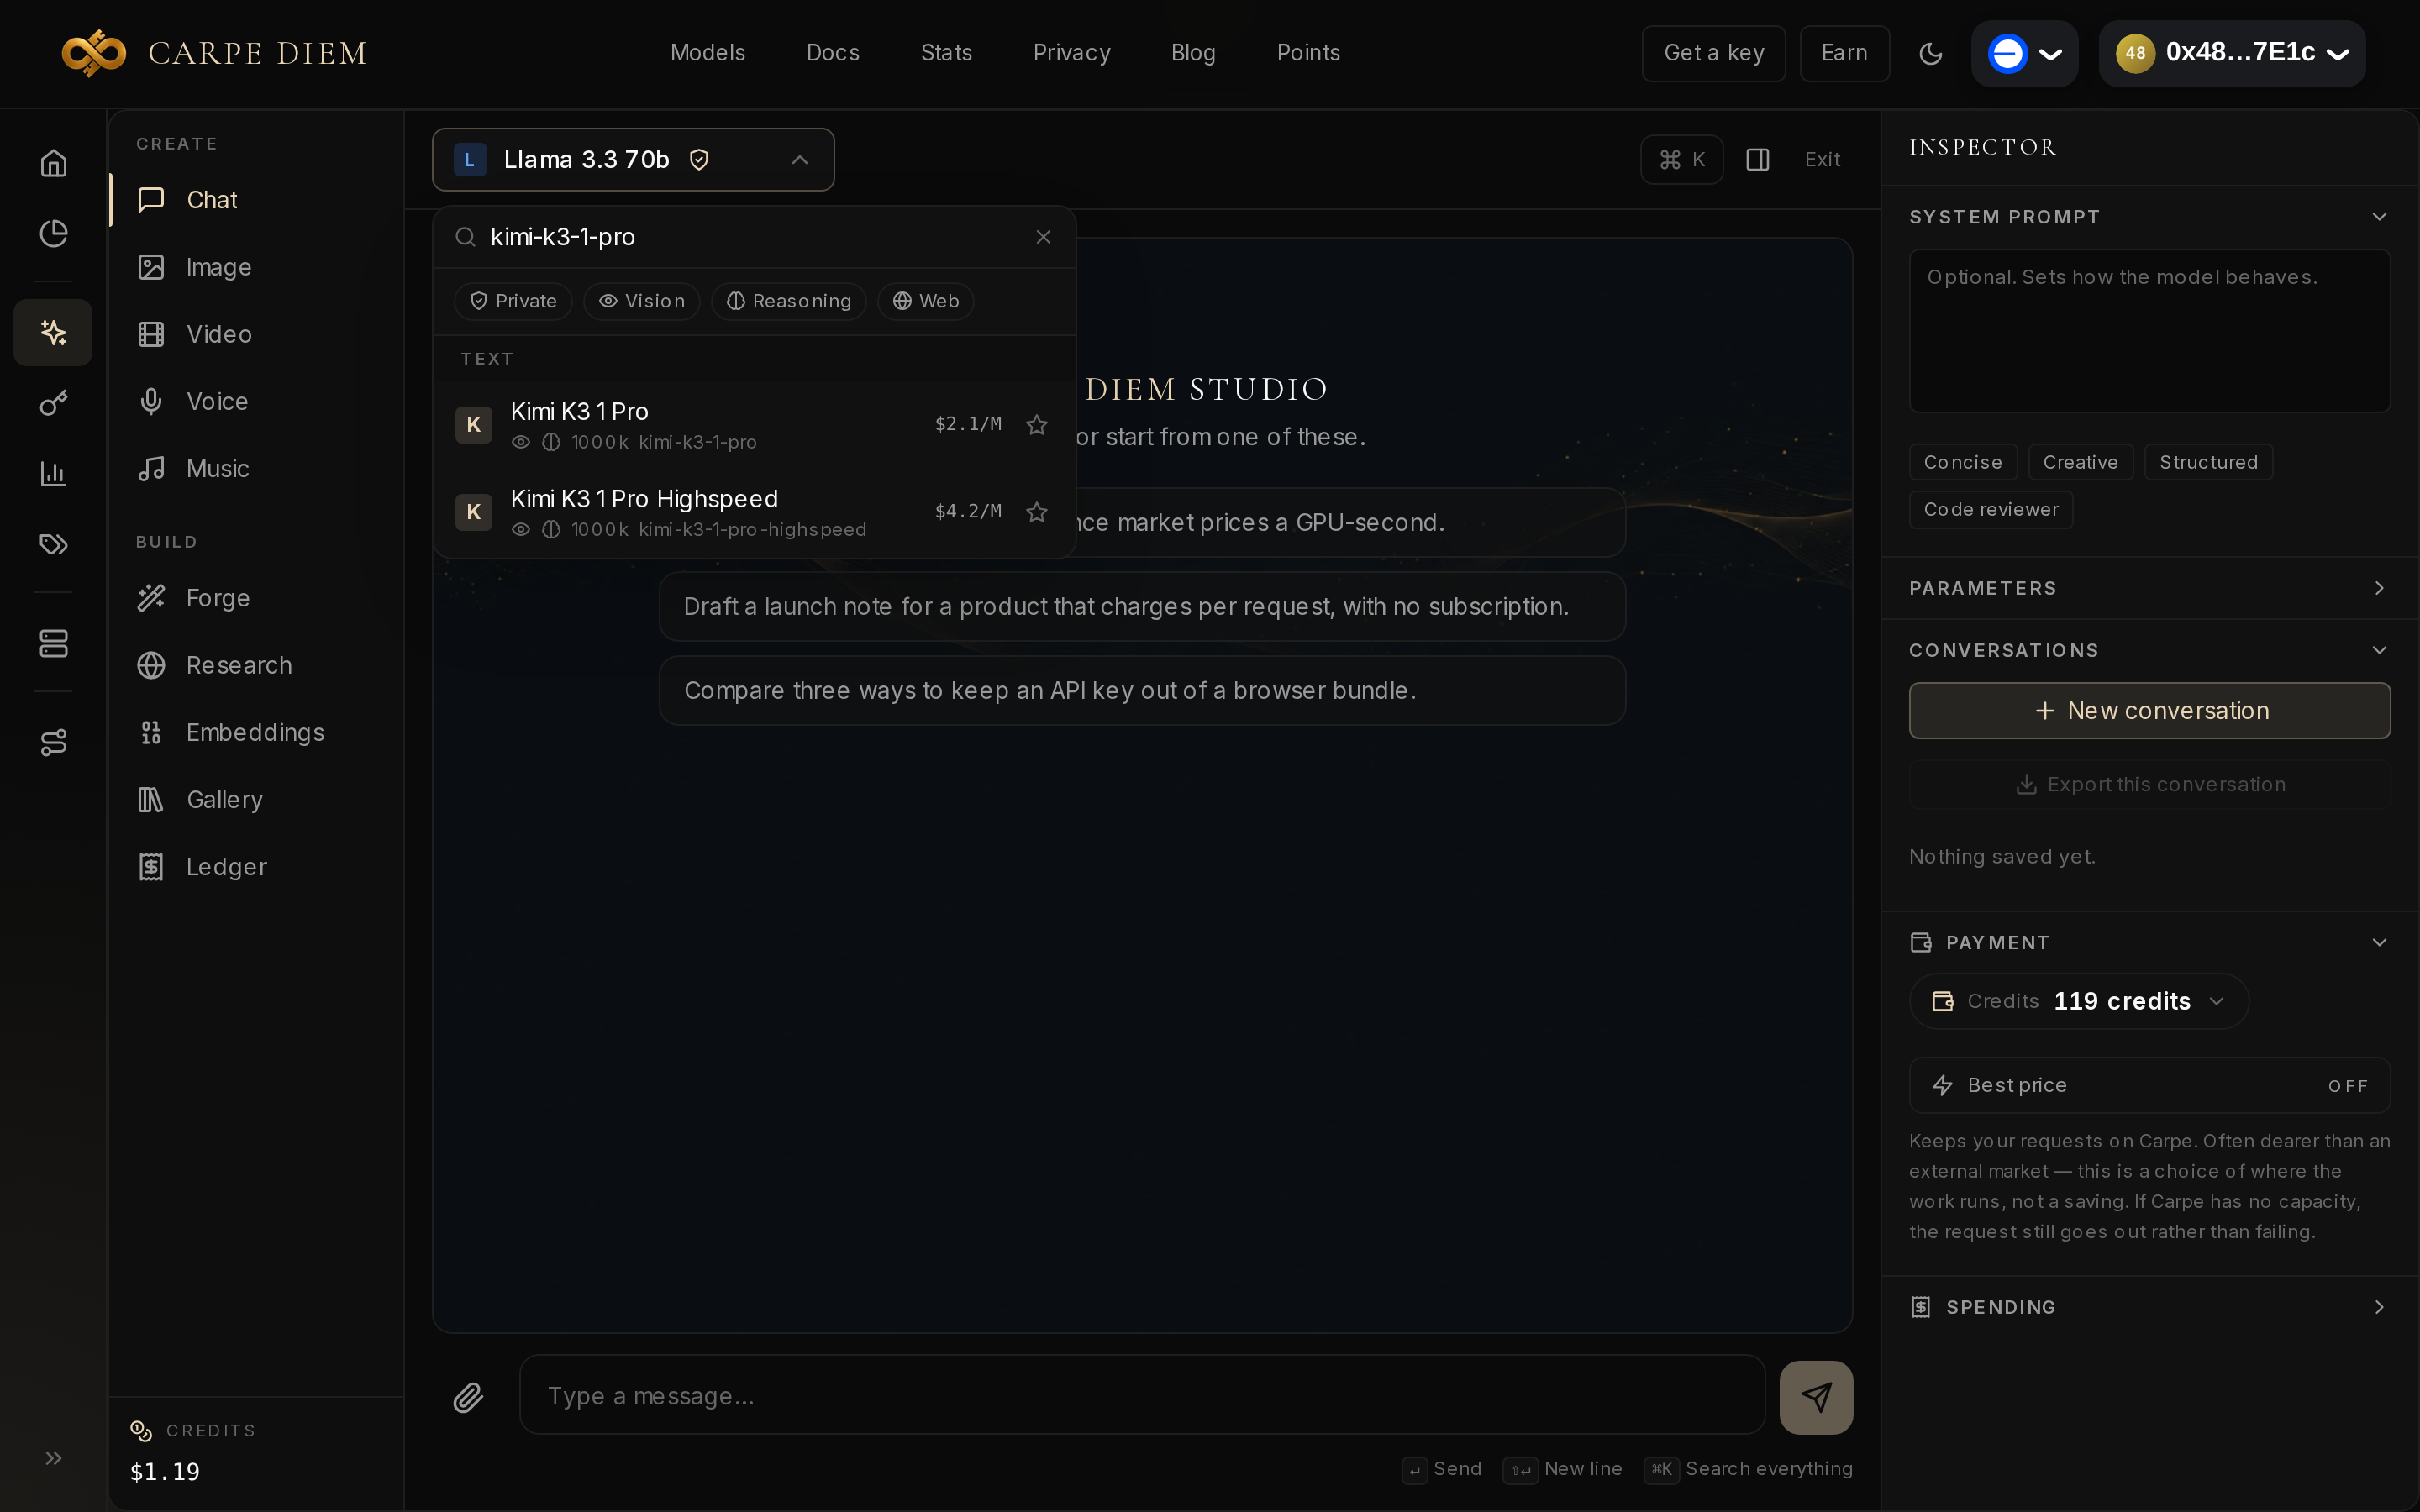
O catálogo atribui-lhe visão, raciocínio, chamada de funções, saídas estruturadas, pesquisa web e várias imagens por pedido. Está classificado anonymized: a Venice transmite os seus pedidos à Moonshot, que vê o conteúdo mas não o remetente. Se os seus prompts tiverem de ficar num modelo private, escolha outro.
Preço: 12,67 $ por mil pedidos médios
Mil pedidos de 1 000 tokens de entrada e outros tantos de saída ficam em 12,67 $ na Carpe Diem, contra 22,50 $ diretamente na Venice. O preço segue a capacidade disponível no dia: confirme em /models antes de orçamentar um volume grande.
| Entrada / M | Saída / M | 1 000 pedidos (1k / 1k) | Confidencialidade | |
|---|---|---|---|---|
| Kimi K3.1 Pro (Carpe Diem) | 2,1114 $ | 10,5572 $ | 12,67 $ | anonymized |
| Kimi K3.1 Pro (Venice) | 3,7500 $ | 18,7500 $ | 22,50 $ | n/a |
| GPT-6.1 Terra | 0,5634 $ | 2,8172 $ | 3,38 $ | anonymized |
| Mercury 3 | 0,0563 $ | 0,1972 $ | 0,25 $ | anonymized |
A tabela da Moonshot lista este modelo a 2 $ e 10 $ o milhão. A variante Highspeed, que não medimos, aparecia a cerca do dobro no seletor do Hub.
Para chamadas curtas e numerosas, acrescente venice_parameters.include_venice_system_prompt: false: sem esse campo, a Venice acrescenta o próprio prompt de sistema, cerca de 1 700 tokens faturados em cada chamada.
Banco de ensaio: JSON conforme em 4,8 s, cálculo em 24,9 s
O banco de ensaio completo custou cerca de 0,03 $. O Kimi encontrou o limiar de rentabilidade (40 000 pedidos) em 24,9 s, devolveu um JSON conforme ao esquema em 4,8 s e recuperou a referência 7319-KESTREL escondida num texto de cerca de 2 500 palavras. O francês, 114 palavras sobre o papel de um encaminhador de modelos, está correto à leitura. A Moonshot indica que o modelo raciocina sempre; não variámos reasoning_effort.
| Prova | Resultado | Duração |
|---|---|---|
| Raciocínio (limiar de rentabilidade) | certo, 40000 | 24,9 s |
| Extração JSON | conforme | 4,8 s |
| Agulha em ~2 500 palavras | encontrada | 8,1 s |
| Redação em francês | correta, sem erro | 21,6 s |
Código JavaScript (compressRanges) |
6/6 fora do harness | 12,1 s |
O harness da prova de código não encontrou o ficheiro de testes e mostrou 0/6. O modelo tinha mesmo assim enviado uma função compressRanges completa: extraída e executada à parte, passa os 6 casos.
Kimi, GPT-6.1 Terra ou Mercury 3?
Para extrair JSON ou fazer um cálculo curto, escolheríamos o Mercury 3: passa o mesmo tipo de provas por uma fração do preço, cerca de quarenta vezes mais barato na entrada.
O GPT-6.1 Terra também continua mais barato do que o Kimi, com visão e o mesmo estado anonymized. O Kimi faz sentido em três casos: quer precisamente o modelo Moonshot para código de agente, precisa do milhão de tokens de contexto, ou a sua stack já está ligada ao Kimi.
Primeira chamada com uma chave Carpe Diem
Crie uma chave cdm_ no painel e exporte CARPE_API_KEY=cdm_your_key_here e OPENAI_BASE_URL=https://carpe-diem.xyz/api/operator/v1. O excerto não instala nada: o urllib chega.
import json
import os
import urllib.request

url = os.environ["OPENAI_BASE_URL"].rstrip("/") + "/chat/completions"
req = urllib.request.Request(
    url,
    data=json.dumps(
        {
            "model": "kimi-k3-1-pro",
            "messages": [{"role": "user", "content": "Reply with the single word ok."}],
            "venice_parameters": {"include_venice_system_prompt": False},
        }
    ).encode(),
    headers={
        "Authorization": "Bearer " + os.environ["CARPE_API_KEY"],
        "Content-Type": "application/json",
    },
    method="POST",
)
with urllib.request.urlopen(req, timeout=90) as resp:
    headers = dict(resp.headers)
    body = json.loads(resp.read().decode())

print(body["choices"][0]["message"]["content"])
usage = body.get("usage") or {}
print("prompt_tokens", usage.get("prompt_tokens"))
print("completion_tokens", usage.get("completion_tokens"))
print("x-carpe-cost-usdc-micro", headers.get("X-Carpe-Cost-Usdc-Micro") or headers.get("x-carpe-cost-usdc-micro"))
print("model", body.get("model"))
ok
prompt_tokens 92
completion_tokens 61
x-carpe-cost-usdc-micro 839
model kimi-k3-1-pro
Procedimento: ensaio de 3 de novembro de 2026, uma execução por prova, só texto curto. O primeiro token, a visão, as ferramentas, reasoning_effort, a janela de um milhão de tokens e o Highspeed não foram ensaiados.
O Hub está descrito no artigo Create Hub; a API, no SDK Python. Crie uma chave, execute o excerto, ou abra kimi-k3-1-pro no Create Hub.