Mercury 3, LLM à diffusion : 54 % sous Venice sur Carpe Diem
Inception a publié Mercury 3 le 19 octobre 2026. Le lendemain, l'identifiant mercury-3 était dans le catalogue Carpe Diem. C'est un LLM à diffusion : les tokens sont raffinés en parallèle, pas un par un. Notre banc d'essai a validé le raisonnement, l'extraction JSON et une aiguille dans 2 500 mots. Sur les épreuves notées, nous avons mesuré 78 à 387 tokens/s de bout en bout, latence comprise. Ce n'est pas comparable aux 1 068 tokens/s de décodage pur annoncés par Inception.
Illustration générée avec seedream-v5-lite sur Carpe Diem.
Ce que fait Mercury 3 et ce qu'on a testé
Mercury 3 est un modèle texte d'Inception Labs, sans image ni audio en entrée, avec 1 000 000 tokens de contexte. L'appel reste un chat/completions classique : le raffinement parallèle se passe côté serveur, pas dans le corps de la requête. Le catalogue lui attribue raisonnement, effort de raisonnement, appels de fonction, schéma de réponse et recherche web. Nous avons vu le raisonnement et un JSON conforme ; nous n'avons pas testé les appels de fonction ni la recherche web.
La confidentialité est anonymized : Venice, fournisseur amont de l'inférence, transmet le contenu au fabricant sans y coller votre identité, contrairement à un modèle private comme Llama 3.3 70B. Voir le détail sur la page confidentialité.
0,0464 $ / 0,1625 $ le million, 54 % sous Venice
Carpe Diem revend l'inférence Mercury 3 via Venice, d'où la comparaison avec le tarif public Venice.
| Entrée / M tokens | Sortie / M tokens | |
|---|---|---|
| Carpe Diem | 0,0464 $ | 0,1625 $ |
| Venice | 0,1000 $ | 0,3500 $ |
Inception publie 0,20 $ / 0,70 $ en liste et, au lancement, 0,10 $ / 0,35 $ (50 % de moins). Venice affiche ce tarif de lancement. Les prix Carpe Diem du tableau sont ceux du banc du 20 octobre 2026 ; le catalogue peut bouger. Au tarif de ce banc, 1 000 tokens d'entrée et 1 000 de sortie coûtent 0,00021 $ ; chez Venice, 0,00045 $. Mille requêtes de ce gabarit : 0,21 $ contre 0,45 $.
Llama 3.3 70B, proposé par défaut dans Chat, est à 0,3032 $ / 1,2127 $ le million, pour 128 000 tokens de contexte et une inférence private. MiniMax M3.1 Flash (minimax-m3-1-flash) est à 0,0812 $ / 0,3248 $ le million, avec vision. Nous ne l'avons pas passé au banc. Les deux restent plus chers à l'entrée et à la sortie que Mercury 3.
Nos mesures du 20 octobre 2026
Le banc a débité 0,00053 $ au total. Les tokens/s du tableau sont les tokens de sortie divisés par la durée totale de l'appel, latence réseau comprise : sur 83 tokens de sortie, 78 tokens/s disent surtout que l'appel a duré 1,1 s, pas que le décodage est lent. Nous n'avons pas mesuré le temps jusqu'au premier token.
| Épreuve | Résultat | Durée | Tokens/s | Coût |
|---|---|---|---|---|
| Raisonnement (réponse unique) | OK, 40000 | 2,4 s | 387 | 0,00018 $ |
| Extraction JSON | conforme | 1,1 s | 78 | 0,00004 $ |
| Aiguille (~2 500 mots) | trouvée | 1,5 s | 132 | 0,00008 $ |
| Rédaction en français | non noté (jugé à la lecture) | 1,6 s | 228 | 0,00008 $ |
Sur le raisonnement, nous demandions le seuil où un forfait à 12 $ plus 0,40 $ les mille requêtes devient strictement moins cher que 0,70 $ les mille. Avec r en milliers de requêtes par mois, le modèle a posé 12 + 0,40r < 0,70r, puis r > 40, et a répondu 40000, le chiffre attendu. Cet appel a facturé 944 tokens de sortie pour quelques lignes visibles.
Pour le JSON, la sortie contenait vendor, amount_usdc 42.50, date 2026-03-03 et les deux lignes d'articles, sans champ en trop.
Côté français, le texte tutoie le lecteur et reste générique. Le code n'a pas été noté.
Quand Mercury 3 vaut le coup
Nous le prendrions pour de l'extraction JSON à bas coût : un essai unique a été conforme en 1,1 s, débité 0,00004 $. Validez sur vos propres documents avant de passer en volume. Le raisonnement court (seuil tarifaire) est tombé juste en 2,4 s.
À éviter si vous avez besoin d'un modèle private ou d'image en entrée. Llama 3.3 70B reste l'option par défaut du studio Chat, avec 128 000 tokens de contexte.
Tester Mercury 3 dans le Hub ou par l'API
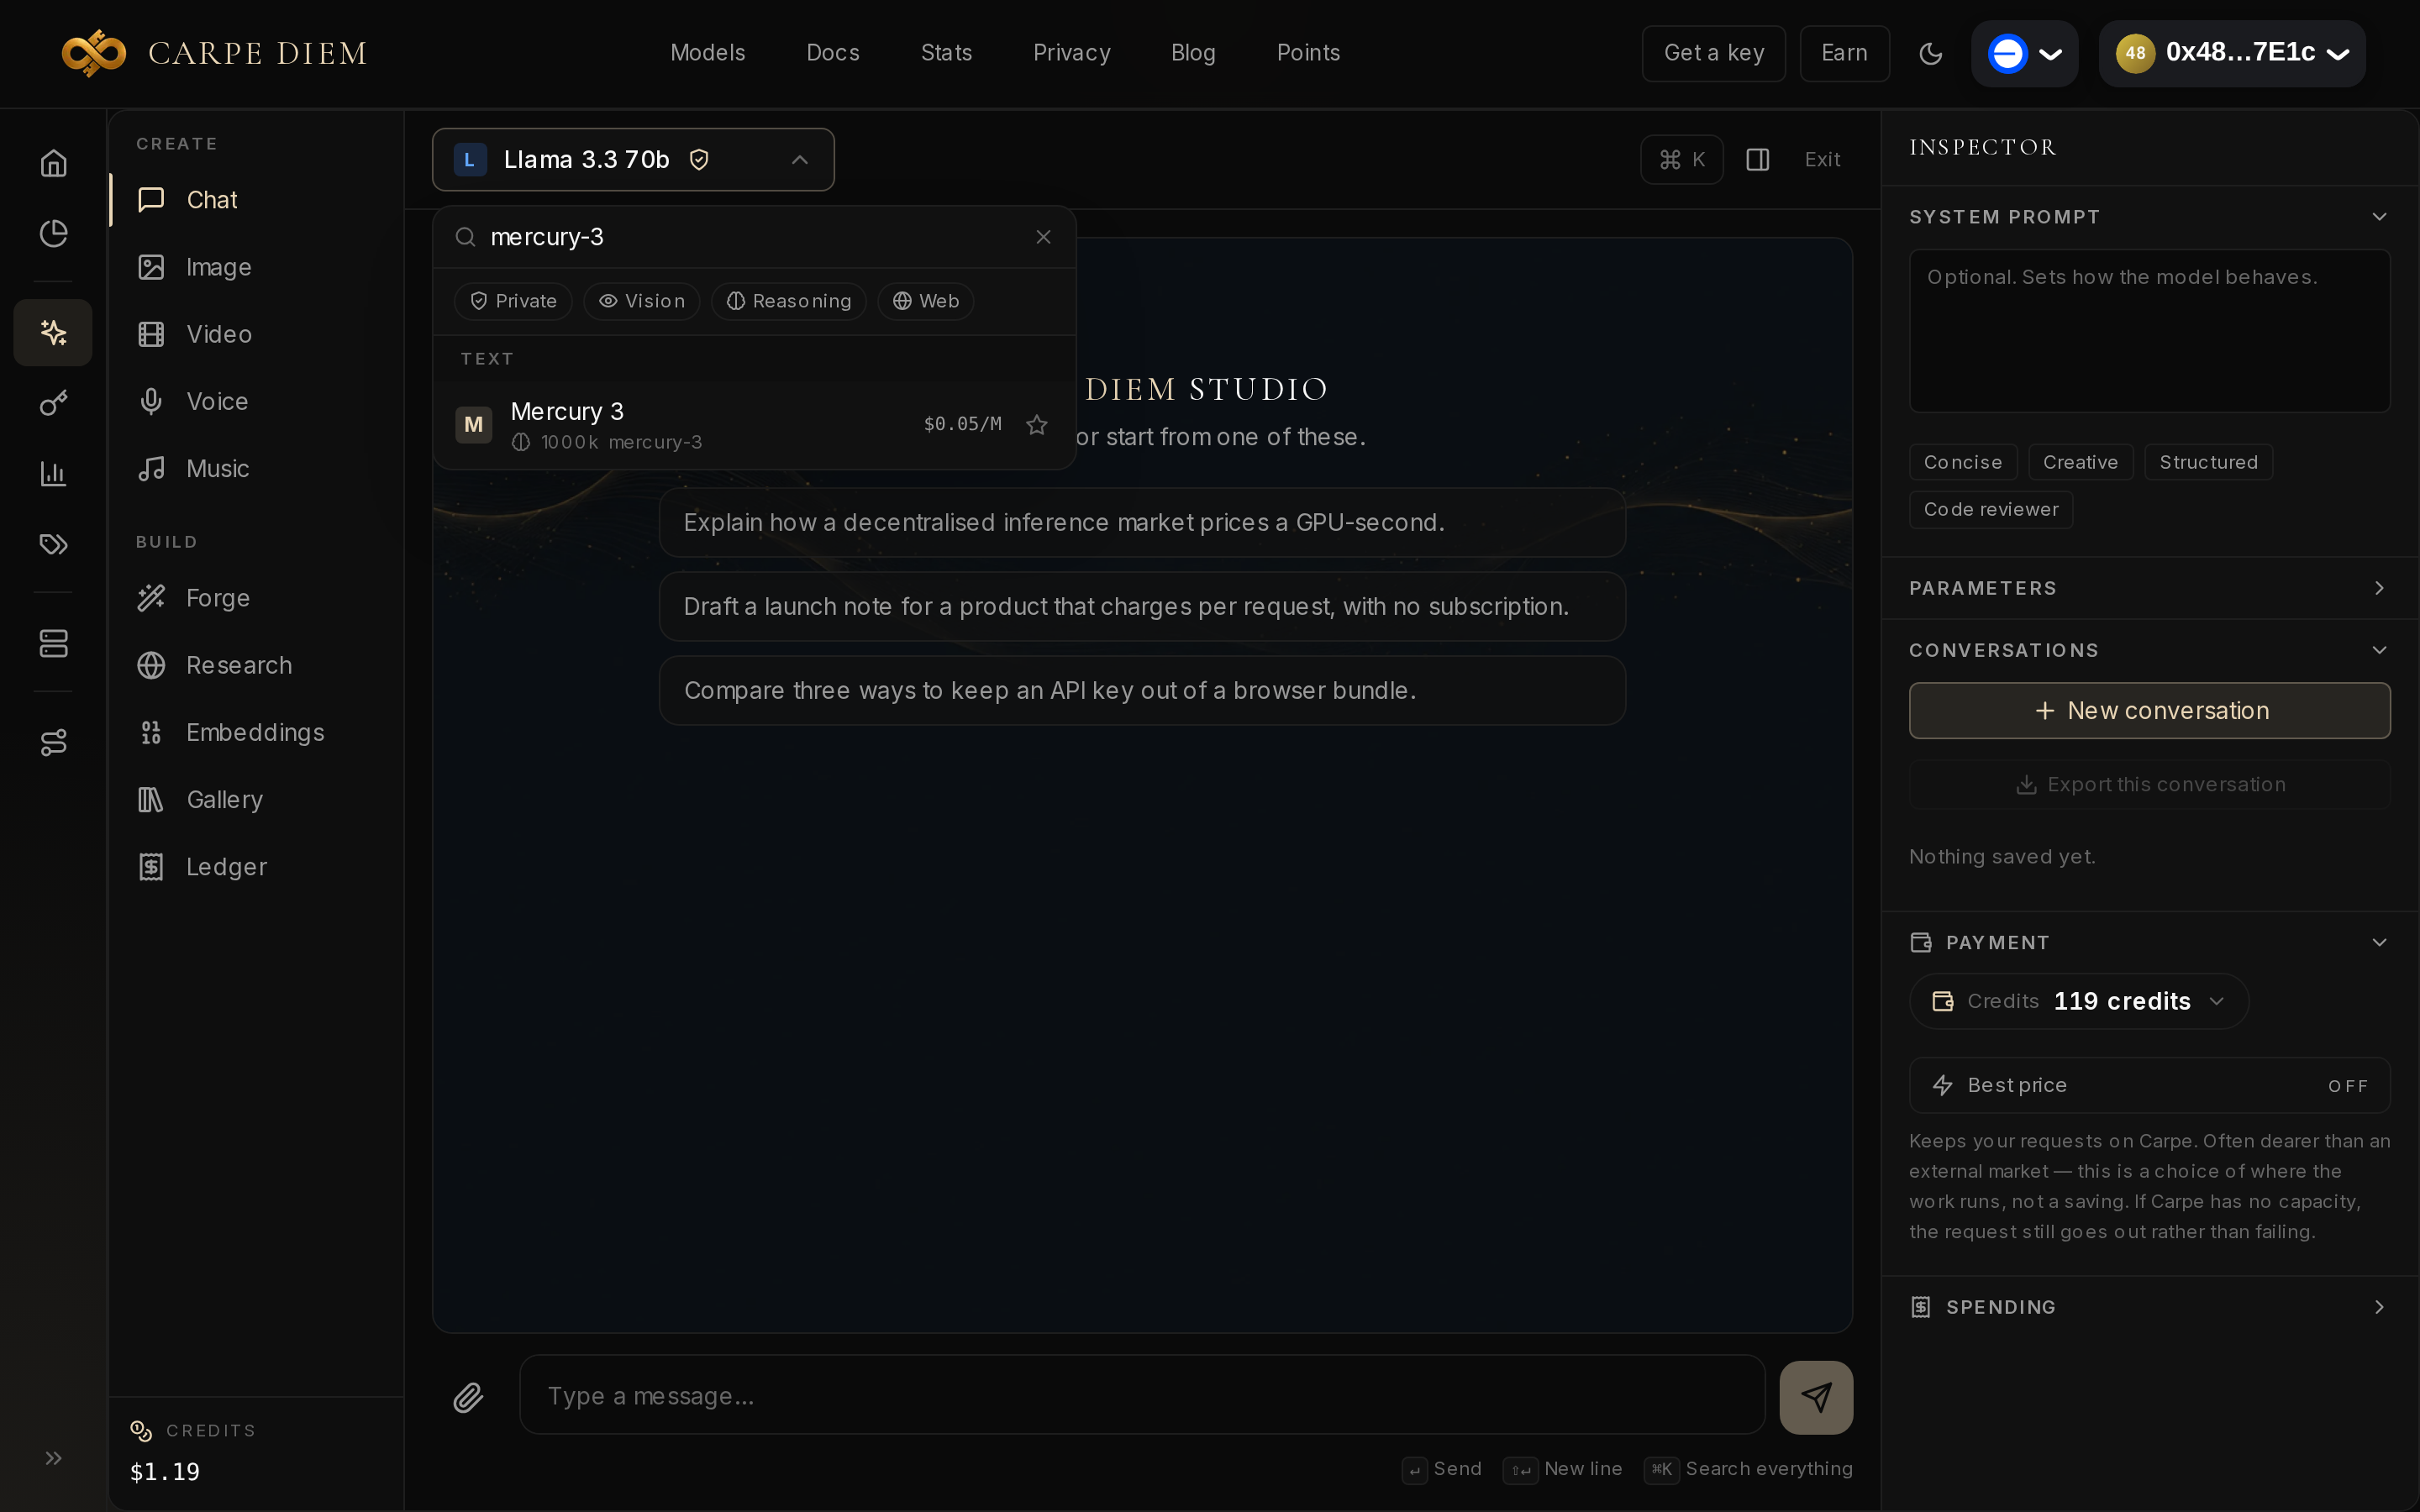
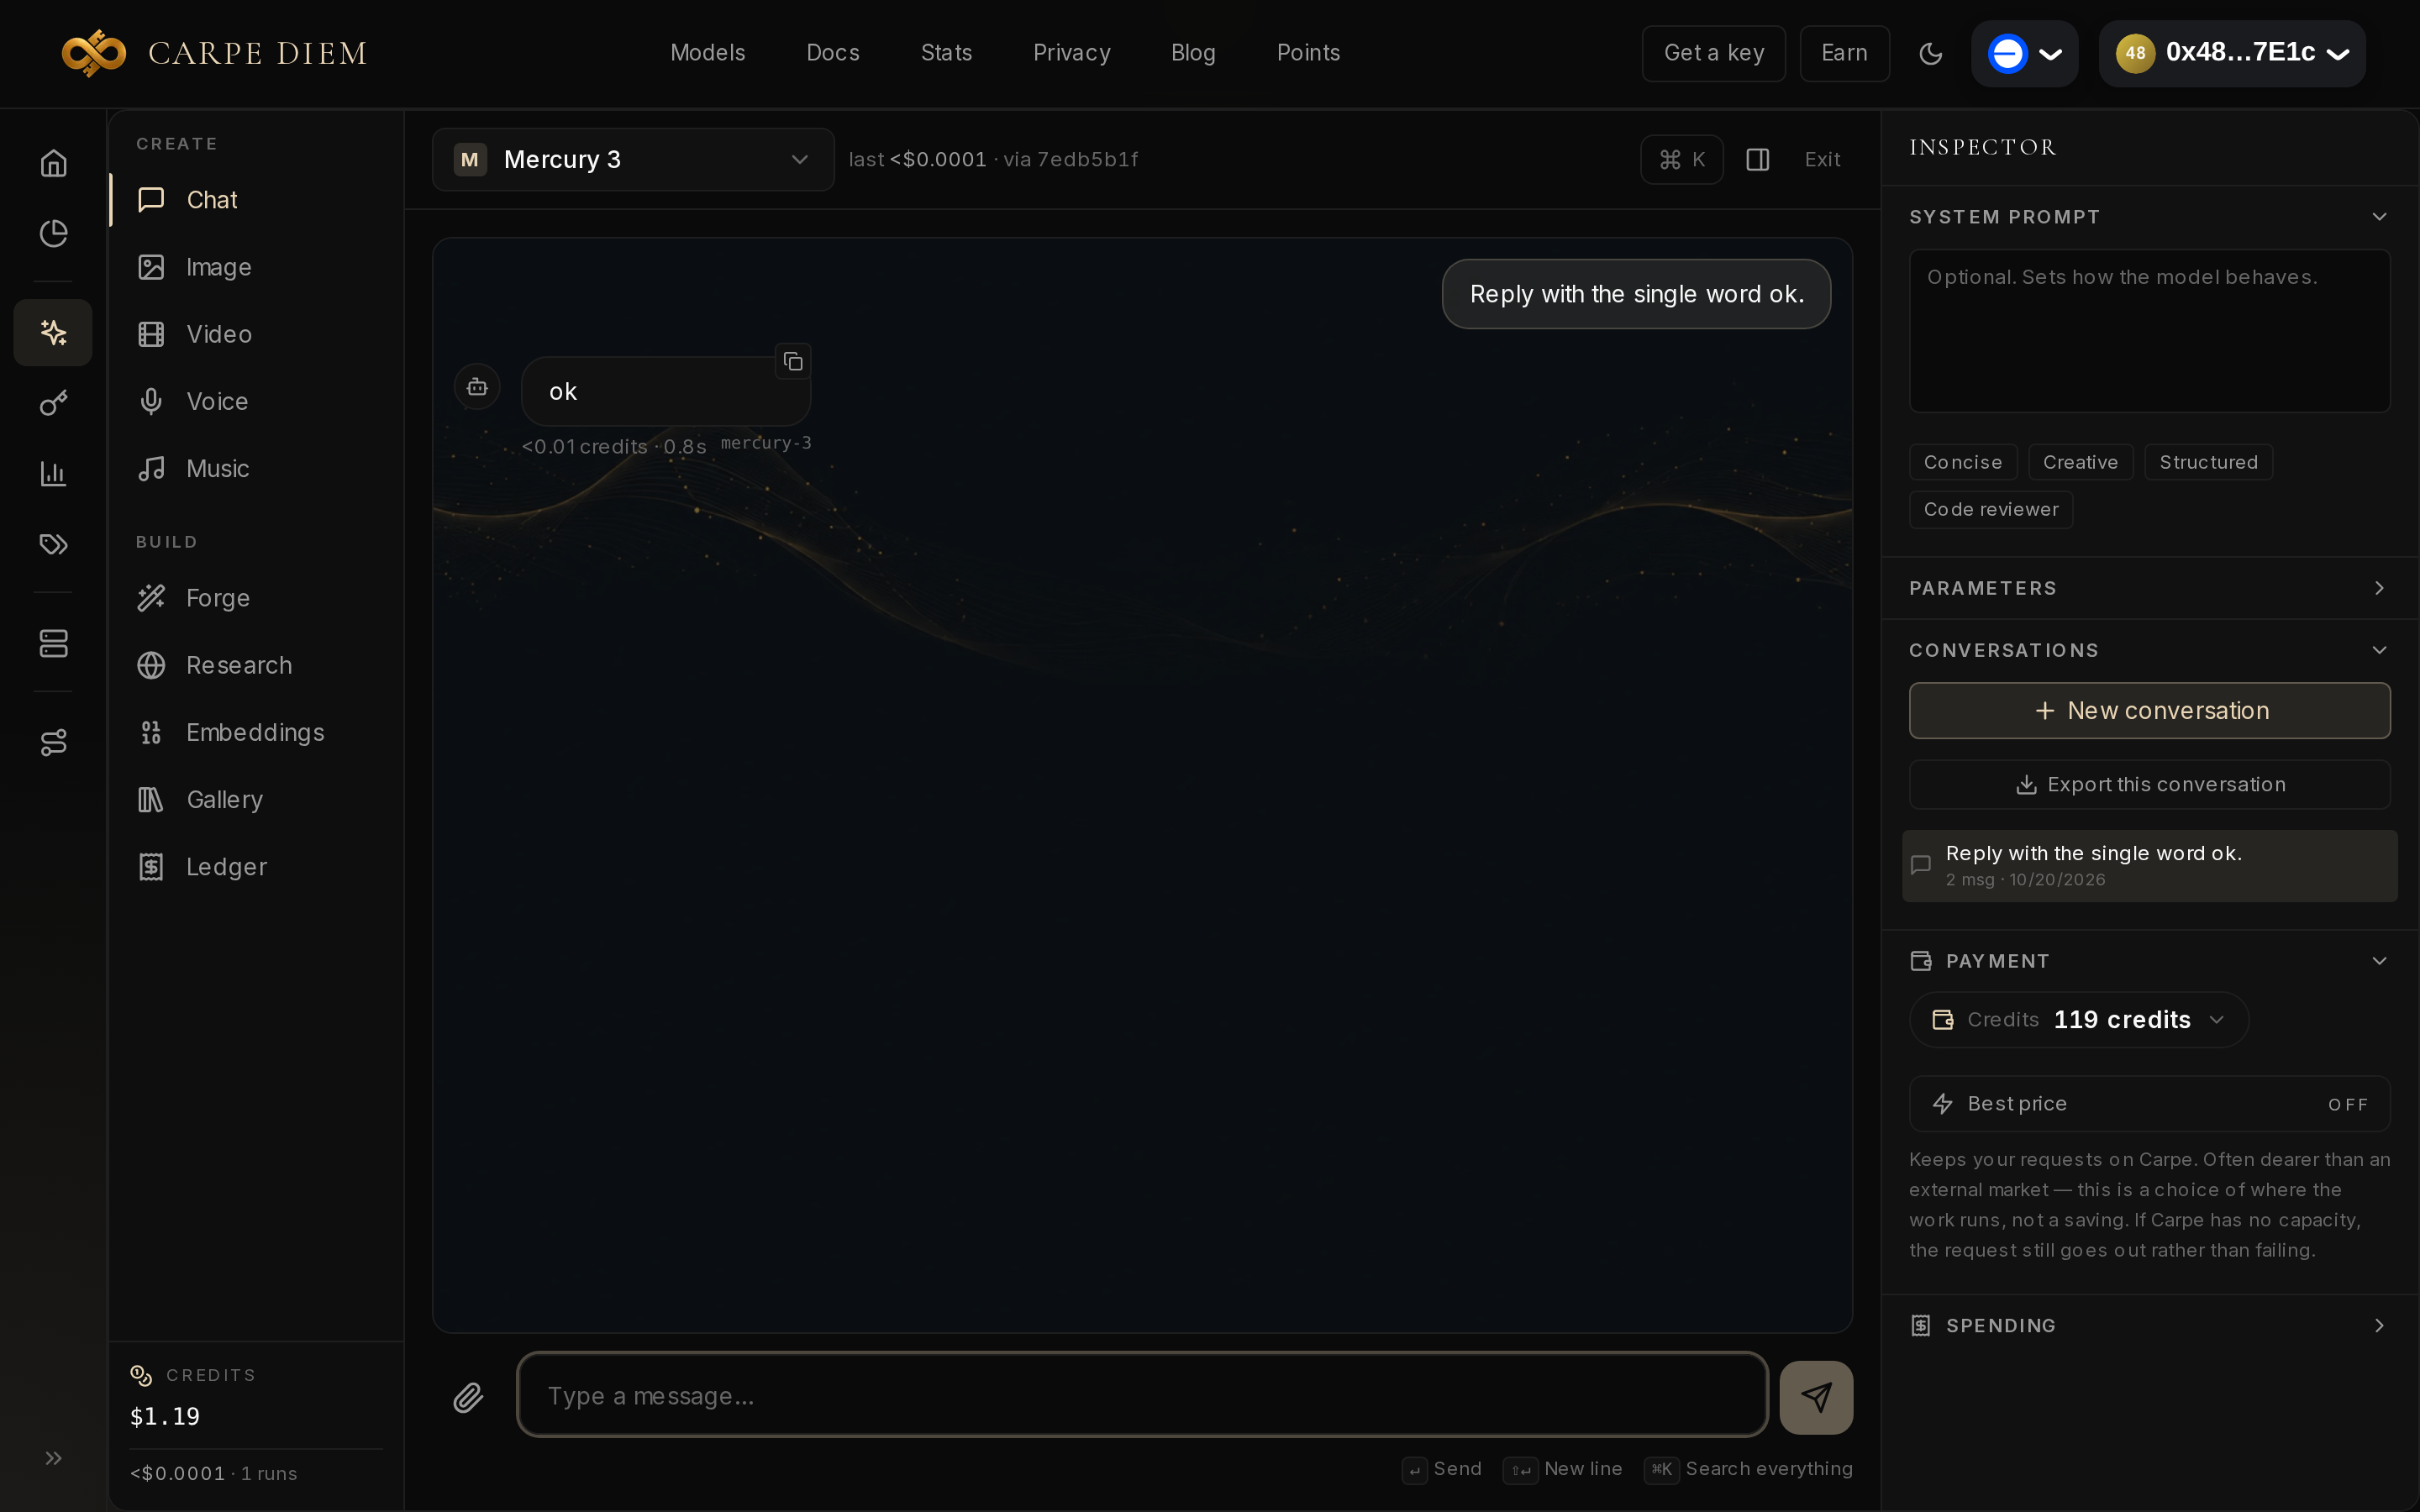
Le studio Chat du Create Hub suffit : ouvrez Chat, cherchez mercury-3, envoyez une ligne. Pas de clé API, le wallet de session paie en crédits. Une invite d'un mot a répondu ok en 0,8 s, pour moins de 0,0001 $. Pour l'API, l'appel suivant a tourné (réponse ok, 0,9 s) :
curl https://carpe-diem.xyz/api/operator/v1/chat/completions \
  -H "Authorization: Bearer cdm_your_key_here" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "mercury-3",
    "messages": [{"role": "user", "content": "Reply with the single word ok."}]
  }'
La clé se crée dans le tableau de bord. L'URL de base documentée pour l'API est https://carpe-diem.xyz/api/operator/v1 (documentation, référence API). Le playground est décrit dans l'article Create Hub.