Kimi K3.1 Pro: precio API, banco de pruebas y cuándo usarlo
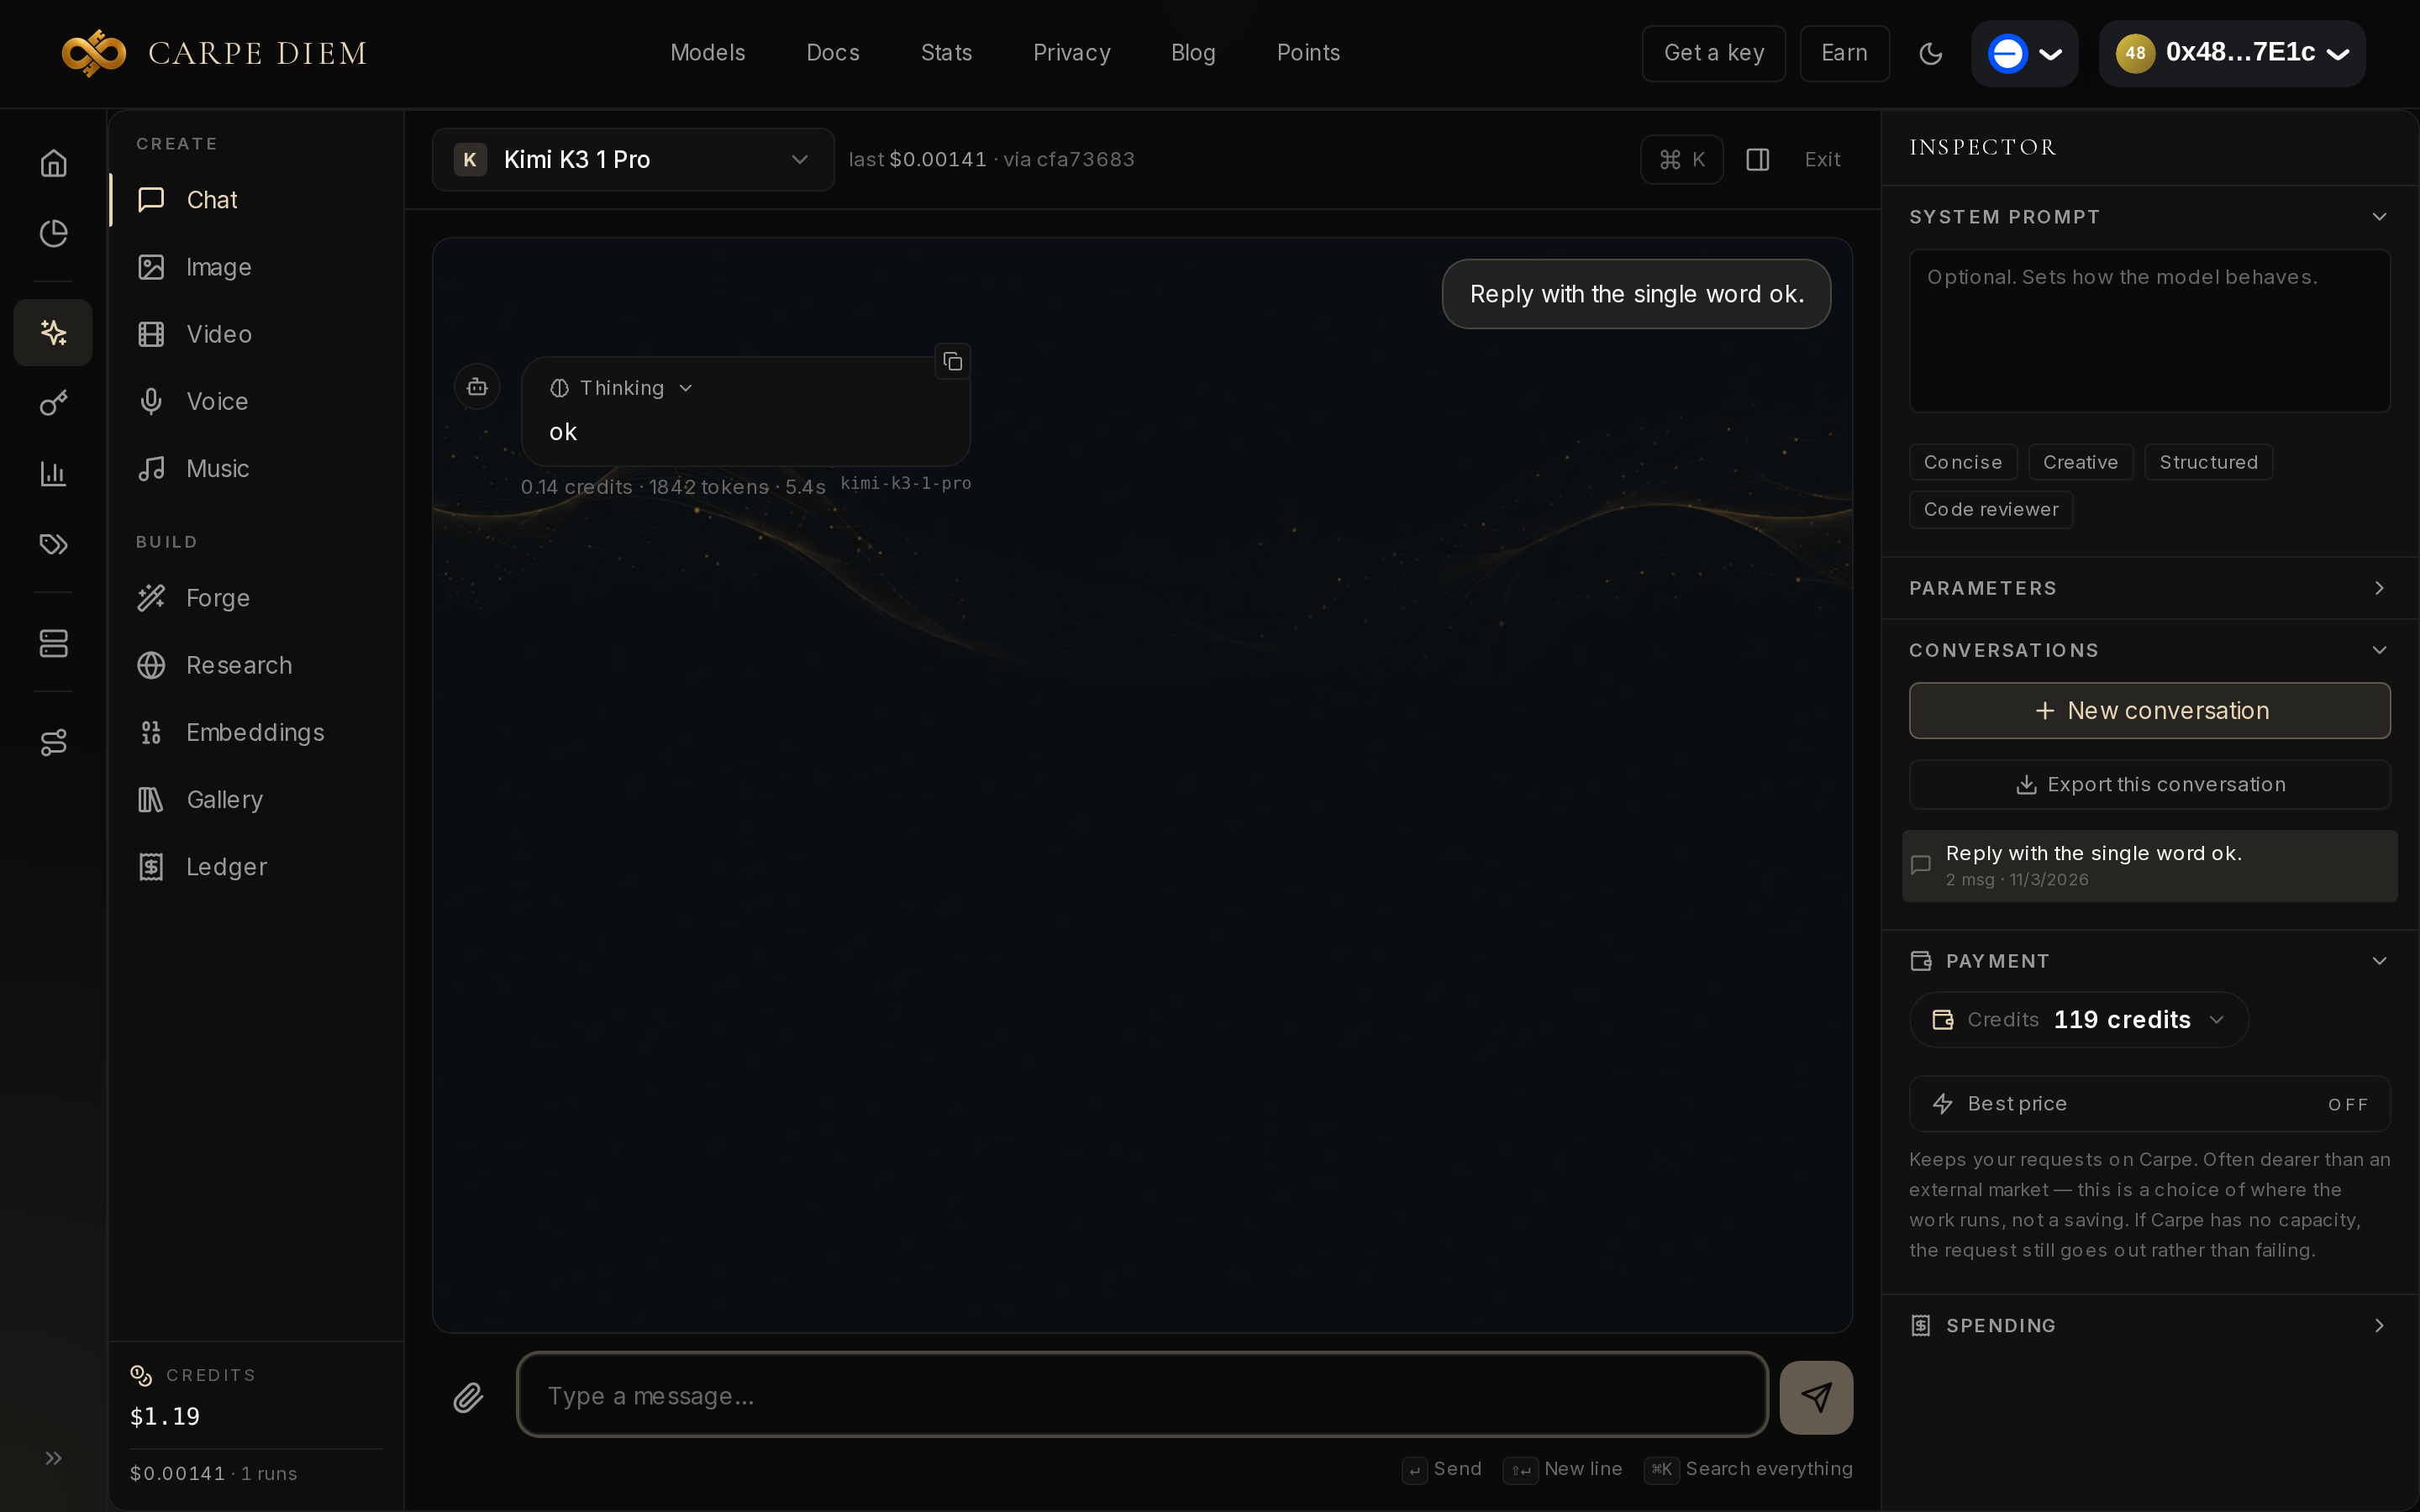
Kimi K3.1 Pro, el modelo que Moonshot AI presentó el 23 de octubre, está disponible en Carpe Diem con el identificador kimi-k3-1-pro. En el momento de nuestra prueba, el 3 de noviembre, costaba 2,11 $ el millón de tokens de entrada y 10,56 $ el de salida, frente a 3,75 $ y 18,75 $ en Venice. Superó el cálculo, el JSON y la aguja en un texto largo. Tiene sentido especialmente si su pila ya está construida alrededor de Kimi.
Kimi K3.1 Pro en breve
Moonshot presenta K3.1 Pro como el primer modelo de su serie K3.1, una versión post-entrenada de Kimi K3, multimodal, con un millón de tokens de contexto, orientada a código largo, creación 3D e investigación financiera. El anuncio oficial también promete los pesos completos para el 4 de noviembre; no hemos comprobado su publicación.
El catálogo le atribuye visión, razonamiento, llamada de funciones, salidas estructuradas, búsqueda web y varias imágenes por petición. Está clasificado anonymized: Venice transmite sus peticiones a Moonshot, que ve el contenido pero no al emisor. Si sus prompts deben quedarse en un modelo private, elija otro.
Precio: 12,67 $ por mil peticiones medias
Mil peticiones de 1 000 tokens de entrada y otros tantos de salida salen a 12,67 $ en Carpe Diem, frente a 22,50 $ en directo en Venice. El precio sigue la capacidad disponible en el día: compruébelo en /models antes de presupuestar un volumen grande.
| Entrada / M | Salida / M | 1 000 peticiones (1k / 1k) | Confidencialidad | |
|---|---|---|---|---|
| Kimi K3.1 Pro (Carpe Diem) | 2,1114 $ | 10,5572 $ | 12,67 $ | anonymized |
| Kimi K3.1 Pro (Venice) | 3,7500 $ | 18,7500 $ | 22,50 $ | n/a |
| GPT-6.1 Terra | 0,5634 $ | 2,8172 $ | 3,38 $ | anonymized |
| Mercury 3 | 0,0563 $ | 0,1972 $ | 0,25 $ | anonymized |
La tarifa de Moonshot lista este modelo a 2 $ y 10 $ el millón. La variante Highspeed, que no hemos medido, se mostraba a aproximadamente el doble en el selector del Hub.
Para llamadas cortas y numerosas, añada venice_parameters.include_venice_system_prompt: false: sin ese campo, Venice añade su propio prompt de sistema, unos 1 700 tokens facturados en cada llamada.
Banco: JSON conforme en 4,8 s, cálculo en 24,9 s
El banco completo costó unos 0,03 $. Kimi encontró el umbral de rentabilidad (40 000 peticiones) en 24,9 s, devolvió un JSON conforme al esquema en 4,8 s y recuperó la referencia 7319-KESTREL oculta en un texto de unos 2 500 palabras. El francés, 114 palabras sobre el papel de un enrutador de modelos, es correcto a la lectura. Moonshot indica que el modelo razona siempre; no hemos variado reasoning_effort.
| Prueba | Resultado | Duración |
|---|---|---|
| Razonamiento (umbral de rentabilidad) | correcto, 40000 | 24,9 s |
| Extracción JSON | conforme | 4,8 s |
| Aguja en ~2 500 palabras | encontrada | 8,1 s |
| Redacción en francés | correcta, sin falta | 21,6 s |
Código JavaScript (compressRanges) |
6/6 fuera del harness | 12,1 s |
El harness de la prueba de código no encontró su archivo de tests y mostró 0/6. El modelo había enviado aun así una función compressRanges completa: extraída y ejecutada aparte, pasa los 6 casos.
¿Kimi, GPT-6.1 Terra o Mercury 3?
Para extraer JSON o hacer un cálculo corto, cogeríamos Mercury 3: supera el mismo tipo de pruebas por una fracción del precio, unas cuarenta veces más barato en entrada.
GPT-6.1 Terra también sigue más barato que Kimi, con visión y el mismo estado anonymized. Kimi tiene sentido en tres casos: quiere precisamente el modelo Moonshot para código de agente, necesita su millón de tokens de contexto, o su pila ya está conectada a Kimi.
Primera llamada con una clave Carpe Diem
Cree una clave cdm_ en el panel, luego exporte CARPE_API_KEY=cdm_your_key_here y OPENAI_BASE_URL=https://carpe-diem.xyz/api/operator/v1. El extracto no instala nada: basta urllib.
import json
import os
import urllib.request

url = os.environ["OPENAI_BASE_URL"].rstrip("/") + "/chat/completions"
req = urllib.request.Request(
    url,
    data=json.dumps(
        {
            "model": "kimi-k3-1-pro",
            "messages": [{"role": "user", "content": "Reply with the single word ok."}],
            "venice_parameters": {"include_venice_system_prompt": False},
        }
    ).encode(),
    headers={
        "Authorization": "Bearer " + os.environ["CARPE_API_KEY"],
        "Content-Type": "application/json",
    },
    method="POST",
)
with urllib.request.urlopen(req, timeout=90) as resp:
    headers = dict(resp.headers)
    body = json.loads(resp.read().decode())

print(body["choices"][0]["message"]["content"])
usage = body.get("usage") or {}
print("prompt_tokens", usage.get("prompt_tokens"))
print("completion_tokens", usage.get("completion_tokens"))
print("x-carpe-cost-usdc-micro", headers.get("X-Carpe-Cost-Usdc-Micro") or headers.get("x-carpe-cost-usdc-micro"))
print("model", body.get("model"))
ok
prompt_tokens 92
completion_tokens 61
x-carpe-cost-usdc-micro 839
model kimi-k3-1-pro
Procedimiento: prueba del 3 de noviembre de 2026, una ejecución por prueba, solo texto corto. El primer token, la visión, las herramientas, reasoning_effort, la ventana de un millón de tokens y Highspeed no se ensayaron.
El Hub se describe en el artículo Create Hub; la API, en el SDK Python. Cree una clave, lance el extracto, o abra kimi-k3-1-pro en el Create Hub.