Kimi K3.1 Pro API-Preis, Benchmark und Einsatz
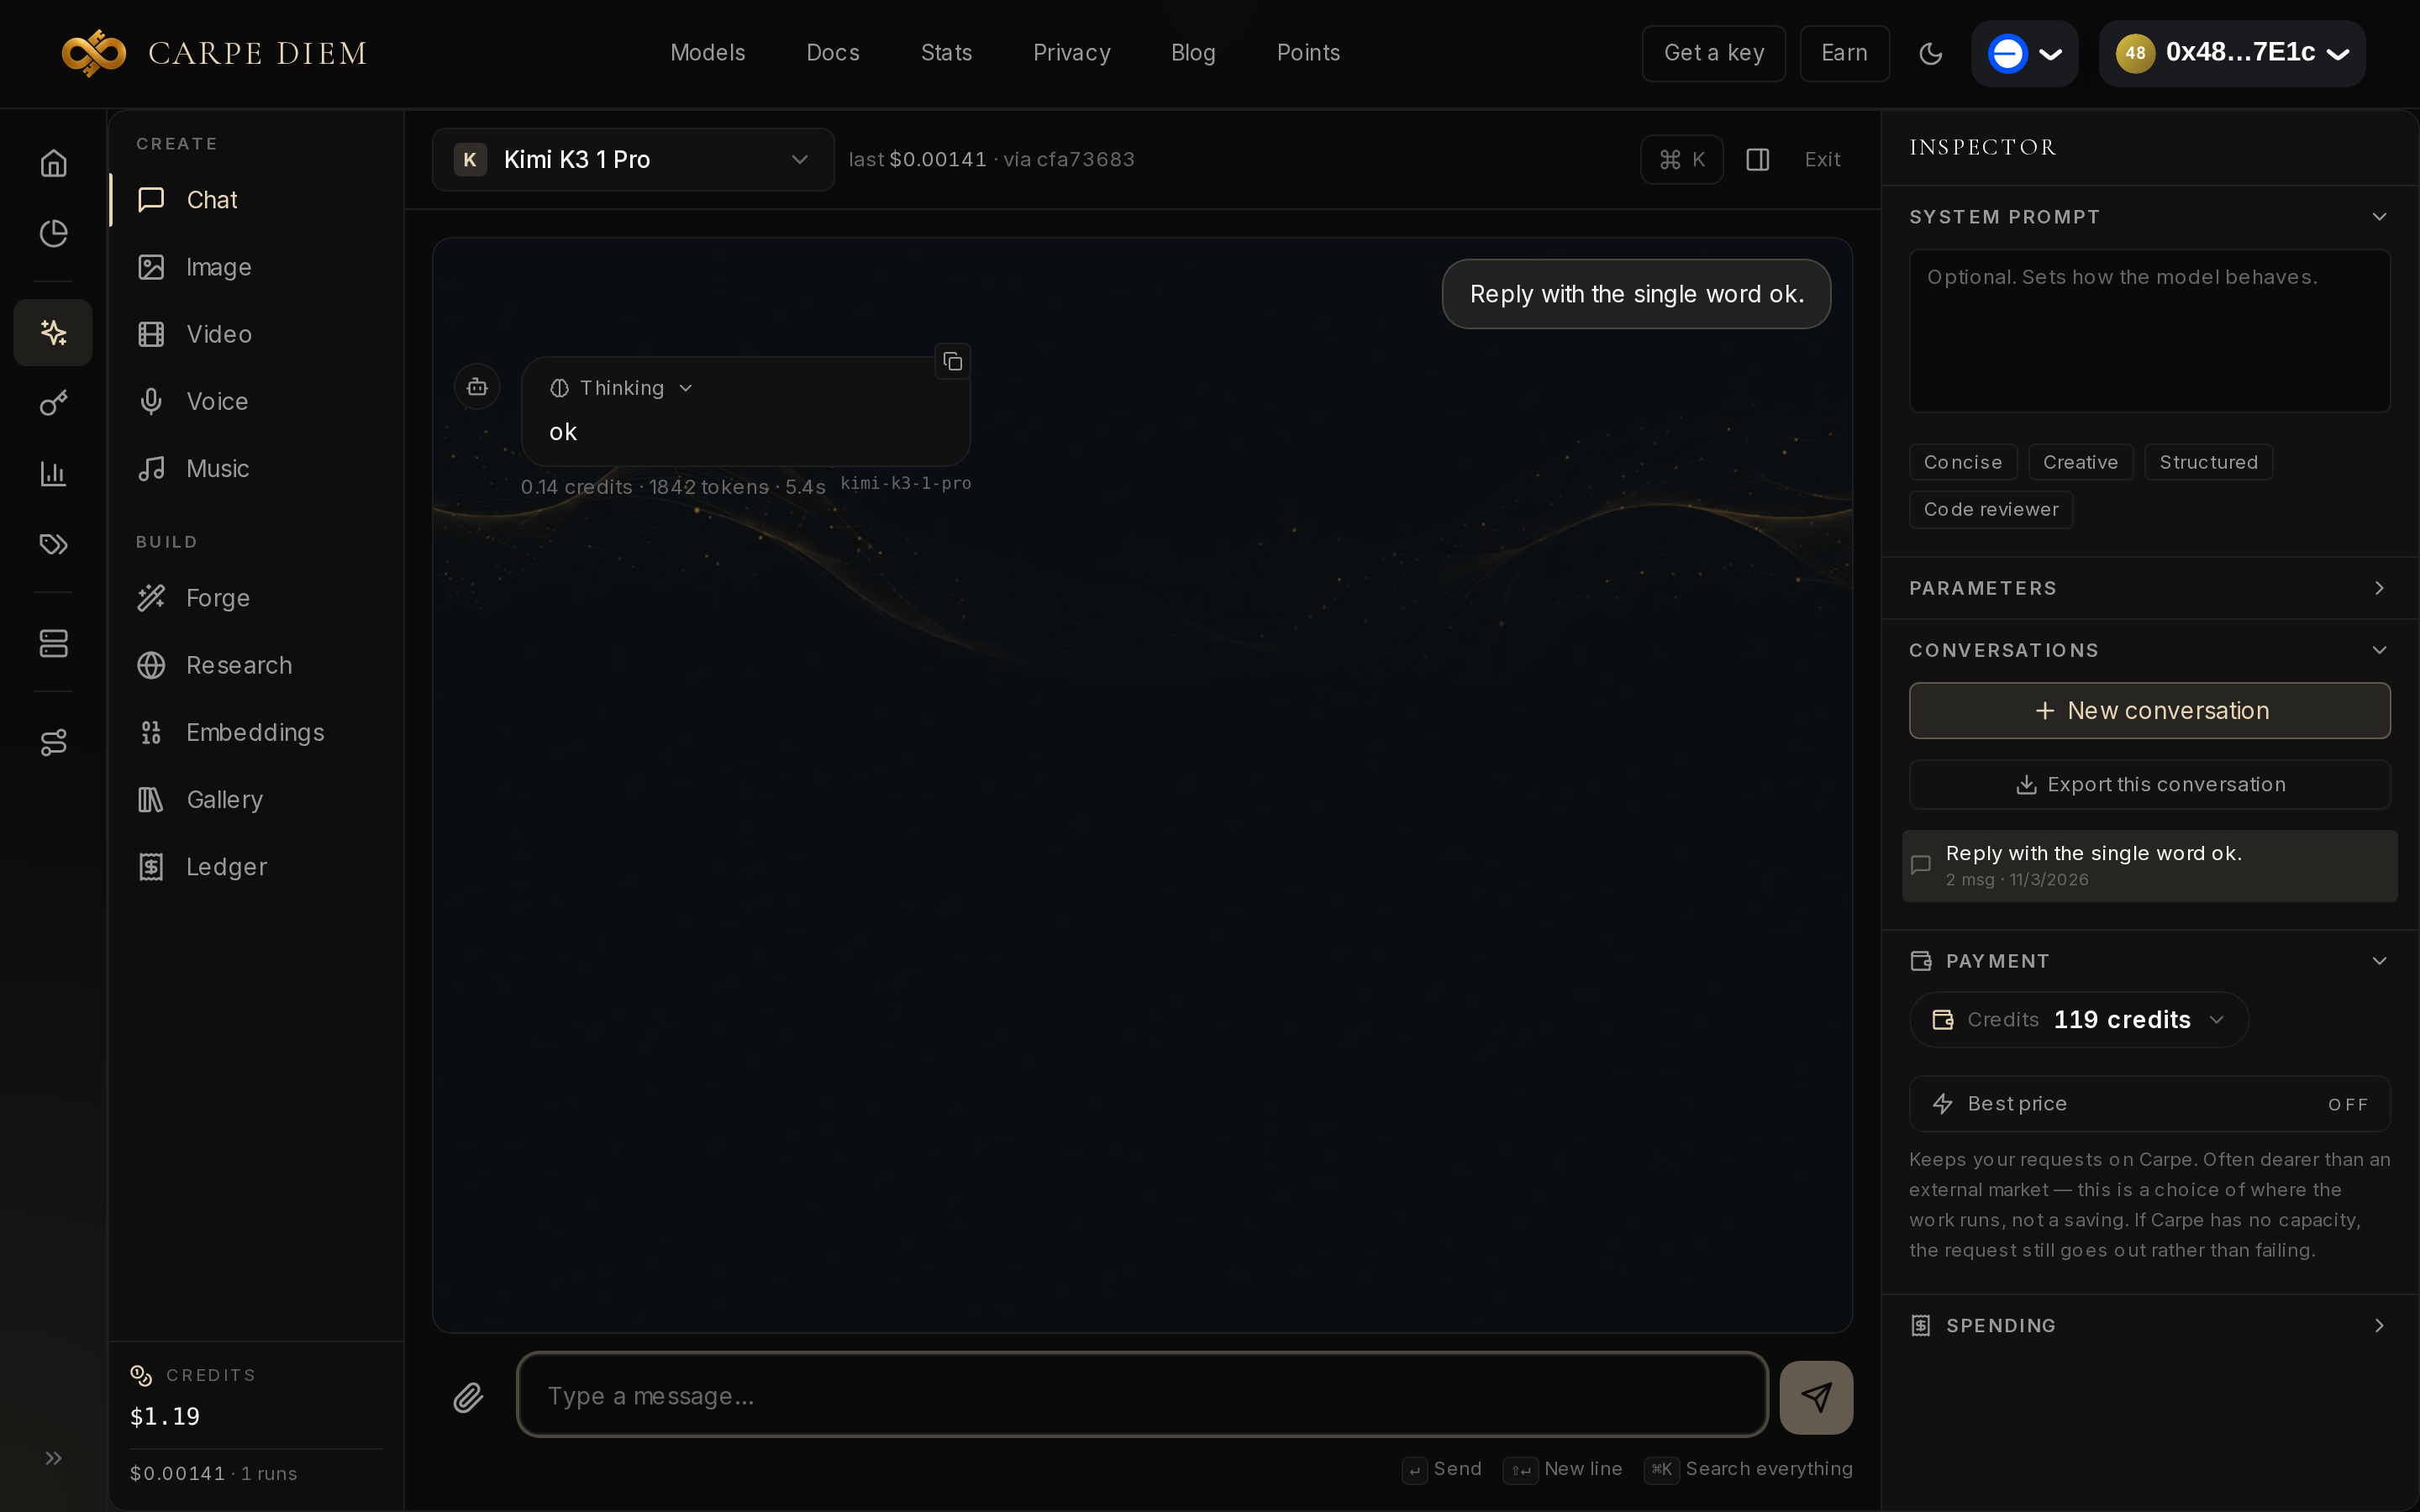
Kimi K3.1 Pro, das Modell, das Moonshot AI am 23. Oktober vorgestellt hat, ist auf Carpe Diem unter der Kennung kimi-k3-1-pro verfügbar. Zum Zeitpunkt unseres Tests am 3. November kostete es 2,11 $ je Million Tokens Eingabe und 10,56 $ Ausgabe, gegenüber 3,75 $ und 18,75 $ bei Venice. Es hat die Rechnung, das JSON und die Nadel in einem langen Text gelöst. Es lohnt sich vor allem, wenn Ihr Stack schon um Kimi herum gebaut ist.
Kimi K3.1 Pro kurz
Moonshot stellt K3.1 Pro als erstes Modell der K3.1-Serie vor, eine nachtrainierte Fassung von Kimi K3, multimodal, mit einer Million Tokens Kontext, ausgerichtet auf langen Code, 3D-Erstellung und Finanzrecherche. Die offizielle Ankündigung verspricht zudem die vollständigen Gewichte zum 4. November; wir haben die Veröffentlichung nicht geprüft.
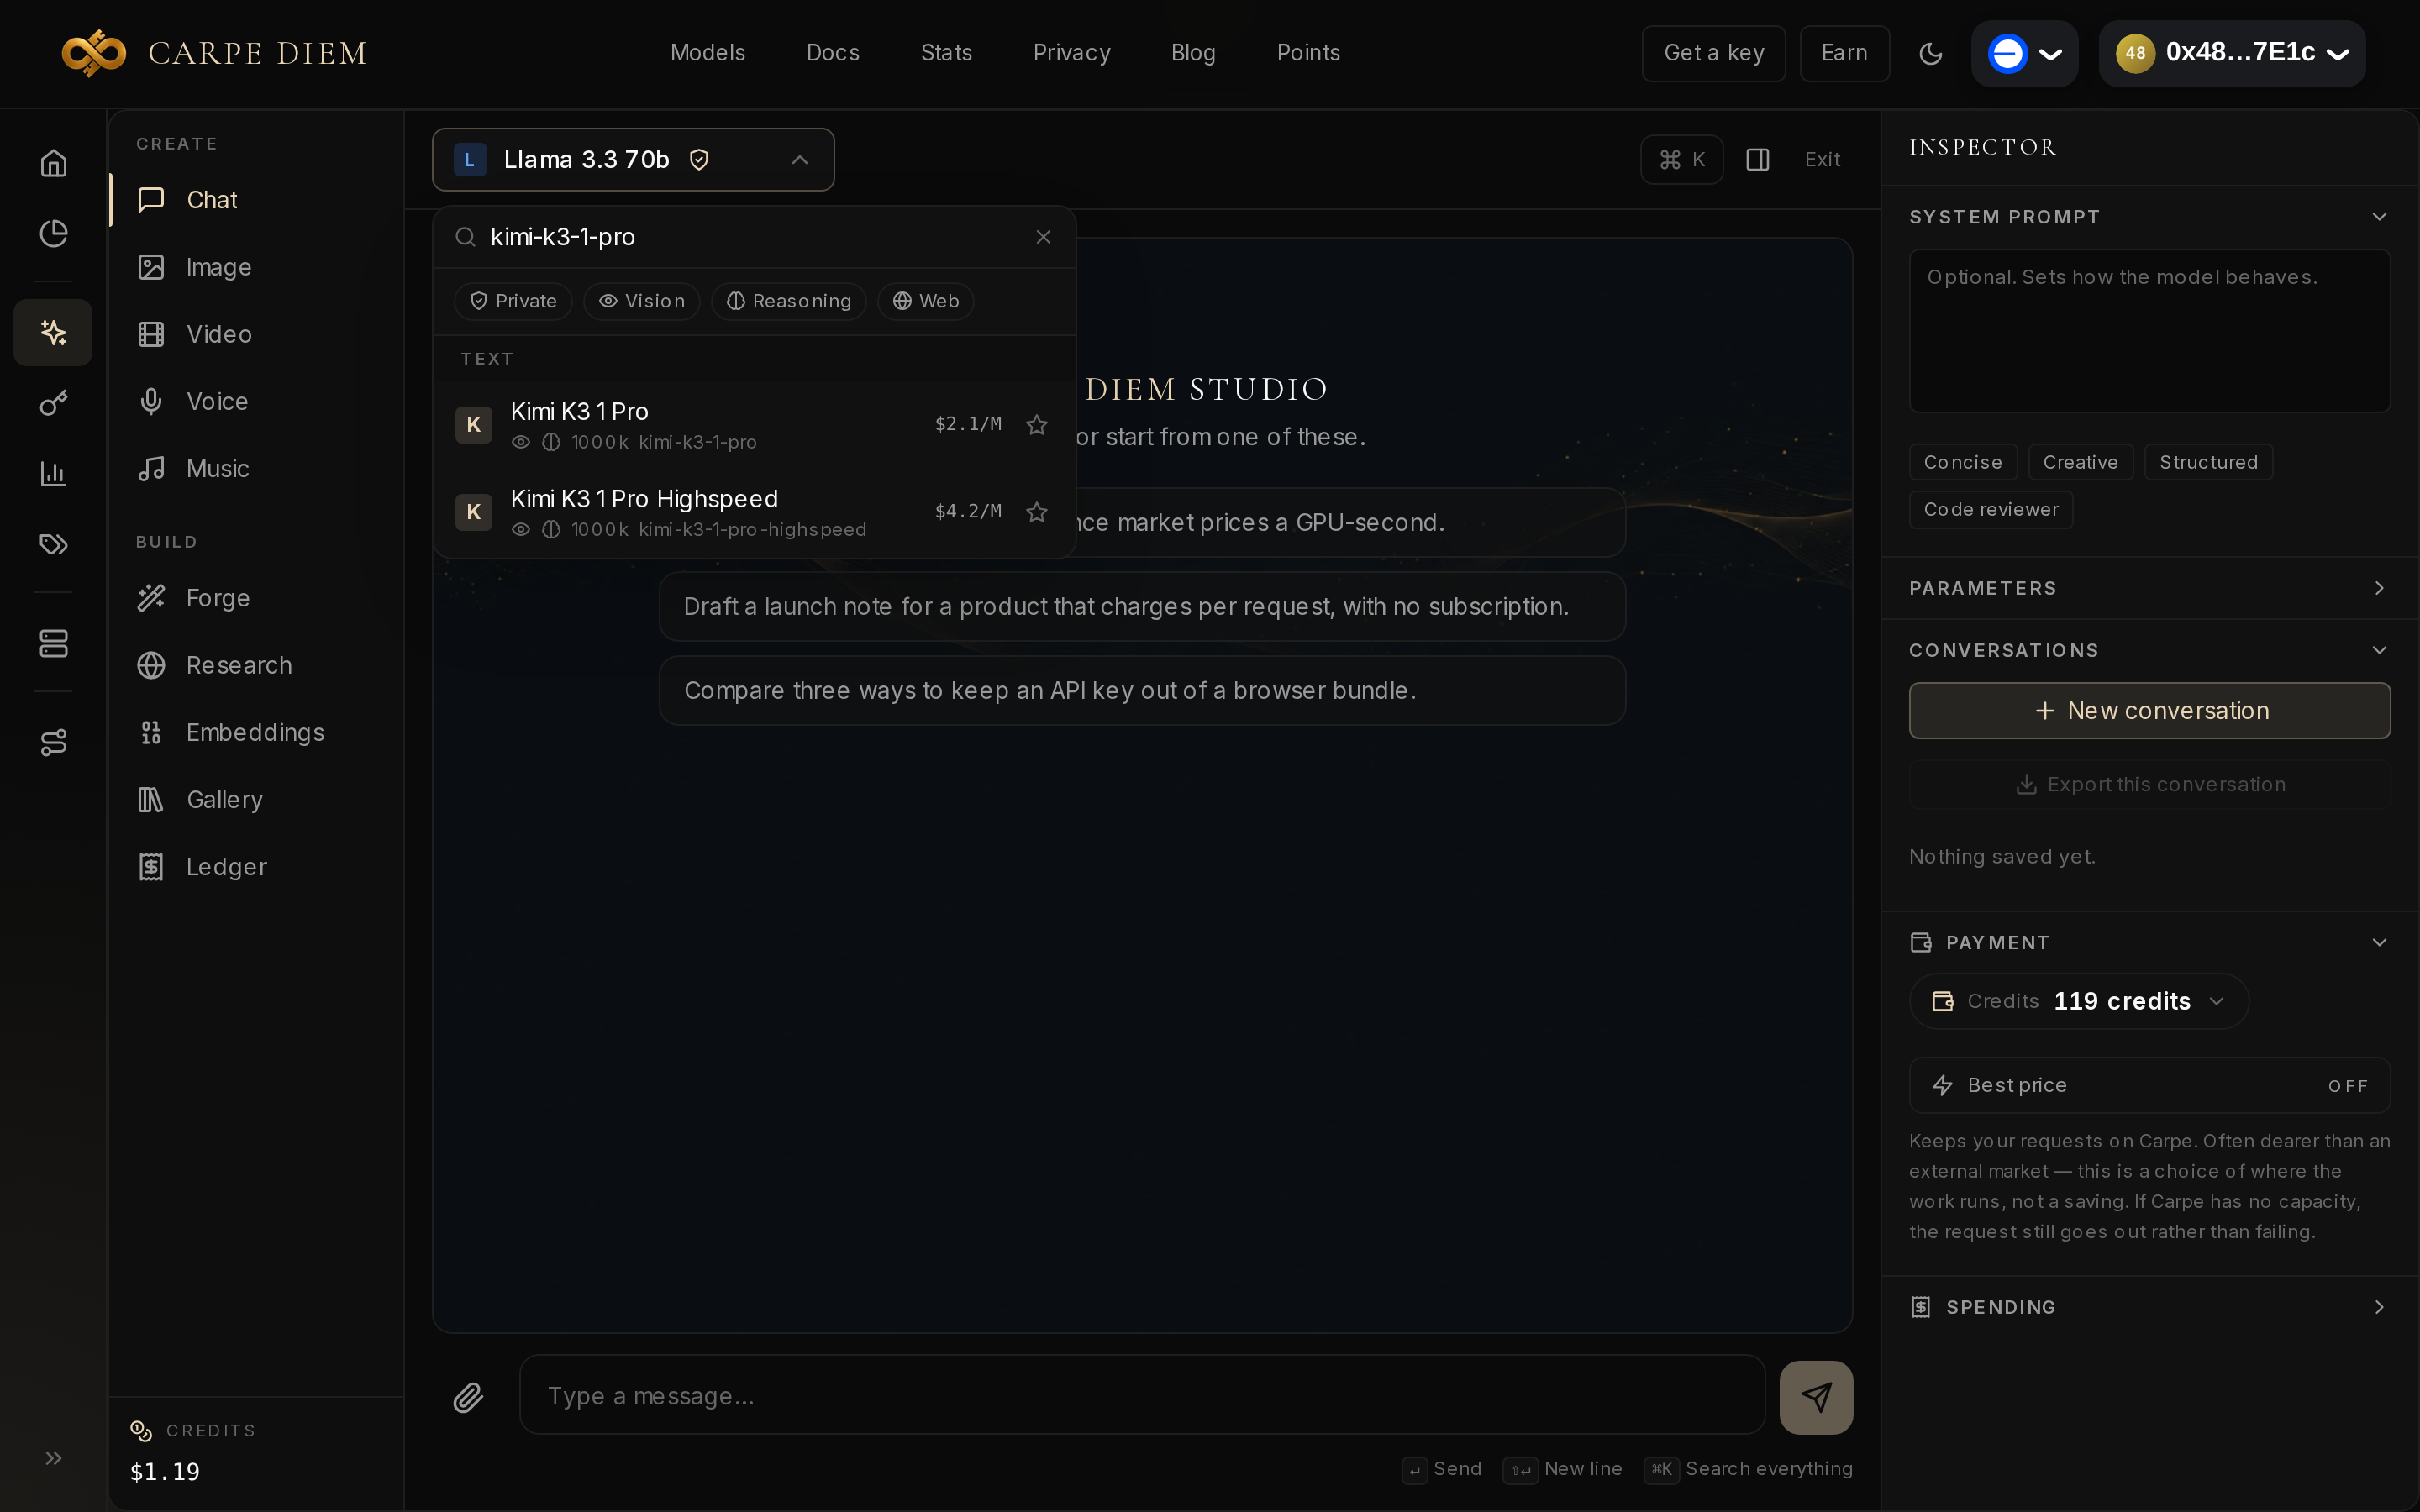
Der Katalog weist ihm Vision, Reasoning, Funktionsaufrufe, strukturierte Ausgaben, Websuche und mehrere Bilder pro Anfrage zu. Er ist als anonymized eingestuft: Venice leitet Ihre Anfragen an Moonshot weiter, das den Inhalt sieht, nicht den Absender. Wenn Ihre Prompts auf einem private-Modell bleiben müssen, wählen Sie ein anderes.
Preis: 12,67 $ für tausend durchschnittliche Anfragen
Tausend Anfragen mit 1 000 Tokens Eingabe und ebenso vielen Ausgabe kommen auf Carpe Diem auf 12,67 $, gegenüber 22,50 $ direkt bei Venice. Der Preis folgt der Kapazität des Tages: prüfen Sie /models, bevor Sie ein großes Volumen budgetieren.
| Eingabe / M | Ausgabe / M | 1 000 Anfragen (1k / 1k) | Vertraulichkeit | |
|---|---|---|---|---|
| Kimi K3.1 Pro (Carpe Diem) | 2,1114 $ | 10,5572 $ | 12,67 $ | anonymized |
| Kimi K3.1 Pro (Venice) | 3,7500 $ | 18,7500 $ | 22,50 $ | n/a |
| GPT-6.1 Terra | 0,5634 $ | 2,8172 $ | 3,38 $ | anonymized |
| Mercury 3 | 0,0563 $ | 0,1972 $ | 0,25 $ | anonymized |
Die Preisliste von Moonshot führt dieses Modell mit 2 $ und 10 $ je Million. Die Variante Highspeed, die wir nicht gemessen haben, erschien im Hub-Selektor etwa zum Doppelten.
Für kurze, häufige Aufrufe setzen Sie venice_parameters.include_venice_system_prompt: false: ohne dieses Feld hängt Venice den eigenen Systemprompt an, rund 1 700 Tokens, die bei jedem Aufruf berechnet werden.
Benchmark: gültiges JSON in 4,8 s, Rechnung in 24,9 s
Der gesamte Benchmark kostete etwa 0,03 $. Kimi fand die Gewinnschwelle (40 000 Anfragen) in 24,9 s, lieferte schema-konformes JSON in 4,8 s und holte die Markierung 7319-KESTREL aus einem Text von etwa 2 500 Wörtern. Das Französische, 114 Wörter zur Rolle eines Modell-Routers, ist beim Lesen korrekt. Moonshot gibt an, dass das Modell immer nachdenkt; wir haben reasoning_effort nicht variiert.
| Prüfung | Ergebnis | Dauer |
|---|---|---|
| Reasoning (Gewinnschwelle) | richtig, 40000 | 24,9 s |
| JSON-Extraktion | konform | 4,8 s |
| Nadel in ~2 500 Wörtern | gefunden | 8,1 s |
| Französischer Text | korrekt, ohne Fehler | 21,6 s |
JavaScript (compressRanges) |
6/6 außerhalb des Harness | 12,1 s |
Der Harness der Code-Prüfung fand seine Testdatei nicht und zeigte 0/6. Das Modell hatte trotzdem eine vollständige compressRanges-Funktion geliefert: extrahiert und separat ausgeführt, besteht sie alle 6 Fälle.
Kimi, GPT-6.1 Terra oder Mercury 3?
Für JSON-Extraktion oder eine kurze Rechnung würden wir Mercury 3 nehmen: es besteht dieselbe Art von Prüfungen für einen Bruchteil des Preises, etwa vierzigmal günstiger bei der Eingabe.
GPT-6.1 Terra bleibt ebenfalls günstiger als Kimi, mit Vision und demselben Status anonymized. Kimi ergibt Sinn in drei Fällen: Sie wollen genau das Moonshot-Modell für Agent-Code, Sie brauchen sein Kontextfenster von einer Million Tokens, oder Ihr Stack ist bereits an Kimi angebunden.
Erster Aufruf mit einem Carpe Diem Schlüssel
Legen Sie im Dashboard einen cdm_-Schlüssel an und exportieren Sie CARPE_API_KEY=cdm_your_key_here sowie OPENAI_BASE_URL=https://carpe-diem.xyz/api/operator/v1. Der Ausschnitt installiert nichts: urllib reicht.
import json
import os
import urllib.request

url = os.environ["OPENAI_BASE_URL"].rstrip("/") + "/chat/completions"
req = urllib.request.Request(
    url,
    data=json.dumps(
        {
            "model": "kimi-k3-1-pro",
            "messages": [{"role": "user", "content": "Reply with the single word ok."}],
            "venice_parameters": {"include_venice_system_prompt": False},
        }
    ).encode(),
    headers={
        "Authorization": "Bearer " + os.environ["CARPE_API_KEY"],
        "Content-Type": "application/json",
    },
    method="POST",
)
with urllib.request.urlopen(req, timeout=90) as resp:
    headers = dict(resp.headers)
    body = json.loads(resp.read().decode())

print(body["choices"][0]["message"]["content"])
usage = body.get("usage") or {}
print("prompt_tokens", usage.get("prompt_tokens"))
print("completion_tokens", usage.get("completion_tokens"))
print("x-carpe-cost-usdc-micro", headers.get("X-Carpe-Cost-Usdc-Micro") or headers.get("x-carpe-cost-usdc-micro"))
print("model", body.get("model"))
ok
prompt_tokens 92
completion_tokens 61
x-carpe-cost-usdc-micro 839
model kimi-k3-1-pro
Vorgehen: Test am 3. November 2026, eine Ausführung je Prüfung, nur kurzer Text. Erstes Token, Vision, Werkzeuge, reasoning_effort, das Fenster von einer Million Tokens und Highspeed wurden nicht getestet.
Das Hub steht im Artikel Create Hub; die API im Python-SDK. Legen Sie einen Schlüssel an, führen Sie den Ausschnitt aus, oder öffnen Sie kimi-k3-1-pro im Create Hub.