GPT-6.1 Terra : prix API, banc d'essai et cas d'usage
GPT-6.1 Terra est sur Carpe Diem sous openai-gpt-61-terra, à 0,5711 $ / 2,8557 $ le million de tokens au relevé du 28 octobre, 43 % sous Venice (1 $ / 5 $). OpenAI le présente comme un modèle de milieu de gamme, avec vision et usage d'écran, annoncé le 26 octobre. Notre banc du 27 octobre a renvoyé du JSON conforme en 1,8 s et a résolu juste un calcul de seuil de rentabilité en 3,8 s.
Illustration générée avec seedream-v5-lite sur Carpe Diem.
Ce que Terra accepte et où partent vos données
Terra accepte le texte et les images, et répond en texte. Audio et vidéo ne sont pas pris en charge. La fiche OpenAI le destine au raisonnement visuel (apparier une photo à une fiche produit, lire un dessin technique) et à l'usage d'écran. Le catalogue Carpe Diem lui donne aussi le raisonnement, reasoning.effort, l'appel d'outils, un schéma de réponse, la recherche web et 1 050 000 tokens de contexte, comme la fiche OpenAI. L'identifiant côté OpenAI est gpt-6.1-terra ; chez nous, openai-gpt-61-terra.
Confidentialité anonymized : Venice transmet le contenu à OpenAI, qui le voit et le traite selon sa propre politique. Détail sur la page confidentialité. Si vos prompts ne doivent pas quitter un modèle private, Terra n'est pas le bon choix, même à 43 % sous Venice.
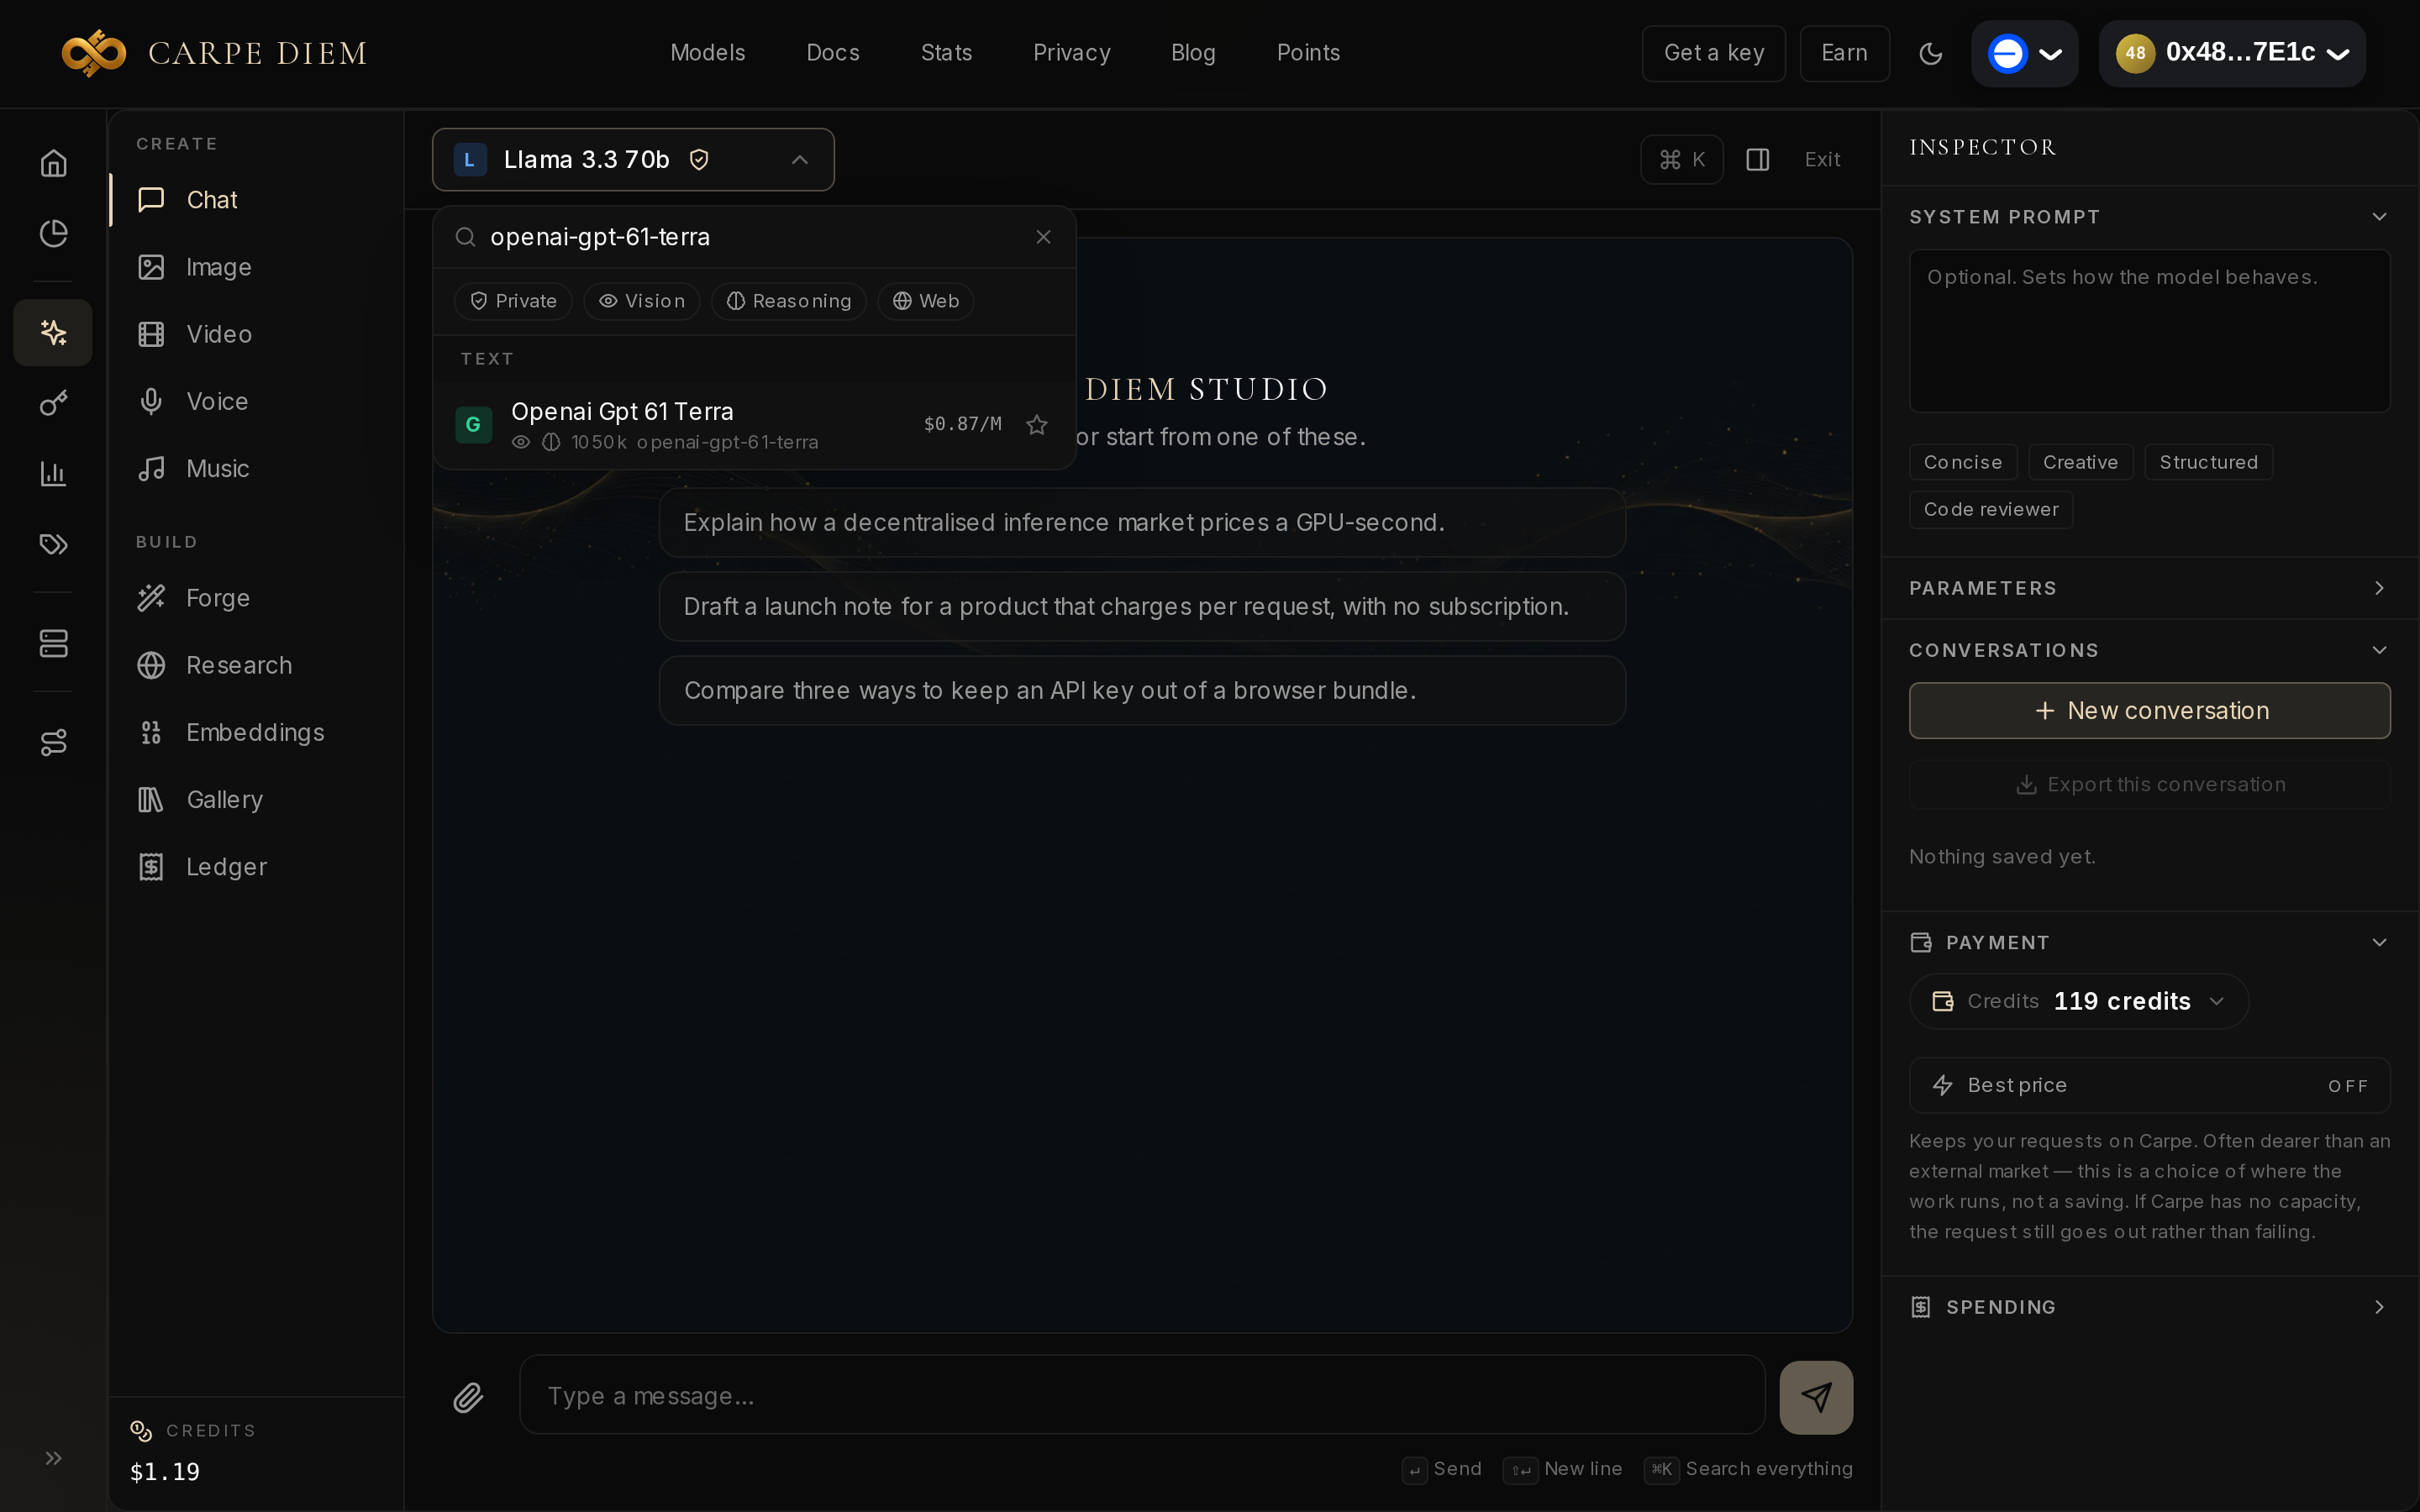 Sélecteur du Hub le 27 octobre : 1 050 k de contexte. Le 0,87 $/M affiché est le tarif du jour, celui auquel le banc a été facturé.
Prix relevés le 28 octobre : 0,57 $ / 2,86 $ le million
Carpe Diem revend l'inférence via Venice. Les 27 et 28 octobre, l'écart d'entrée face à Venice est allé de 13 % (0,8723 $, tarif du banc) à 48 % (0,5235 $). Au dernier relevé, 0,5711 $ / 2,8557 $, soit 43 % sous Venice. Mille requêtes à 1 000 tokens d'entrée et 1 000 de sortie coûtent 3,43 $ chez nous, 6,00 $ en direct chez Venice. Vérifiez /models avant de budgéter : le tarif bouge d'un jour à l'autre.
| Entrée / M | Sortie / M | 1 000 requêtes (1k in / 1k out) | Contexte | Confidentialité | |
|---|---|---|---|---|---|
| GPT-6.1 Terra (Carpe Diem) | 0,5711 $ | 2,8557 $ | 3,43 $ | 1 050 000 | anonymized |
| GPT-6.1 Terra (Venice) | 1,0000 $ | 5,0000 $ | 6,00 $ | — | — |
| GPT-6.1 Sol | 1,1423 $ | 5,7115 $ | 6,85 $ | 1 050 000 | anonymized |
| GPT-5.6 Terra | 1,1423 $ | 6,8538 $ | 8,00 $ | 1 000 000 | anonymized |
| Mercury 3 | 0,0571 $ | 0,1999 $ | 0,26 $ | 1 000 000 | anonymized |
Sauf venice_parameters.include_venice_system_prompt: false, Venice préfixe son prompt système et le facture. Notre phrase « Reply with the single word ok. » sans ce champ a gonflé l'entrée à 1 689 tokens. Avec le champ, le même prompt est passé à 13 tokens d'entrée. Sur un chat long, ces ~1 700 tokens se noient. Sur un millier d'appels d'une phrase, ils deviennent le poste principal : autant couper le préfixe dès le premier essai.
Banc du 27 octobre : JSON conforme en 1,8 s
Une seule exécution par épreuve, facturée au tarif du 27 octobre (0,8723 $ / 4,3616 $ le million), même batterie que dans l'article Mercury 3. Nous n'avons éprouvé ni la vision, ni les outils, ni reasoning.effort, ni la fenêtre de 1 050 000 tokens : le banc porte sur du texte court. L'aiguille tenait dans environ 2 500 mots. L'épreuve code n'a pas été notée : notre harnais n'a pas trouvé son fichier de tests. Terra a tout de même renvoyé une fonction compressRanges en JavaScript ; nous ne l'avons pas exécutée.
| openai-gpt-61-terra | |
|---|---|
| Premier token | 1 029 ms |
| Raisonnement | OK, 40000 · 3,8 s |
| JSON | conforme · 1,8 s |
| Aiguille (~2 500 mots) | trouvée · 1,7 s |
| Rédaction FR | 87 mots · 2,5 s |
| Coût du banc | 0,00625 $ |
Le premier token est venu en 1 029 ms, acceptable pour du chat, pas pour de l'autocomplétion. Le raisonnement demandait à partir de combien de requêtes un forfait à 12 $ de frais mensuels, mais 0,30 $ de moins par mille, devient rentable. Réponse attendue : 40000. Terra a répondu 40000, en 3,8 s, pour 0,00088 $.
Le JSON contenait vendor, amount_usdc 42.50, date 2026-03-03 et les deux lignes d'articles, en 1,8 s pour 0,00032 $. L'aiguille 7319-KESTREL est sortie telle quelle ; c'est l'épreuve la plus chère du banc (0,00365 $ sur 0,00625 $), à cause du poids de l'entrée. La rédaction française, jugée à la lecture, est correcte, fluide, sans faute : 87 mots sur le rôle d'un routeur de modèles.
Quand choisir Terra plutôt que Mercury 3
Mercury 3 pour l'extraction JSON et le calcul courts : même JSON conforme en 0,9 s (contre 1,8 s) et même 40000 en 1,5 s (contre 3,8 s) sur notre banc du 23 octobre, à 0,0571 $ / 0,1999 $ le million, soit environ un dixième du prix Terra. Ces écarts reposent sur une seule exécution par modèle, à cinq jours d'intervalle. Mercury 3 est lui aussi anonymized : ce n'est pas l'alternative privée.
Terra si vous avez besoin de la vision (le catalogue ne la donne pas à Mercury 3) ou d'un modèle OpenAI déjà dans votre pile. GPT-5.6 Terra, au-dessus dans la gamme OpenAI, est à 1,1423 $ / 6,8538 $ le million chez nous, sans que nous l'ayons mesuré. Sol coûte le double de GPT-6.1 Terra (1,1423 $ / 5,7115 $) et nous ne l'avons pas passé au banc. Si les données doivent rester private, ni Terra ni Mercury 3 : le contenu part chez le fabricant.
Un appel Python qui coupe le prompt Venice
Créez une clé cdm_ dans le tableau de bord. Exportez CARPE_API_KEY=cdm_your_key_here et OPENAI_BASE_URL=https://carpe-diem.xyz/api/operator/v1. L'extrait n'installe rien : urllib suffit. Il coupe le prompt système de Venice et affiche la réponse et les tokens.
import json
import os
import urllib.request

url = os.environ["OPENAI_BASE_URL"].rstrip("/") + "/chat/completions"
req = urllib.request.Request(
    url,
    data=json.dumps(
        {
            "model": "openai-gpt-61-terra",
            "messages": [{"role": "user", "content": "Reply with the single word ok."}],
            "venice_parameters": {"include_venice_system_prompt": False},
        }
    ).encode(),
    headers={
        "Authorization": "Bearer " + os.environ["CARPE_API_KEY"],
        "Content-Type": "application/json",
    },
    method="POST",
)
with urllib.request.urlopen(req, timeout=60) as resp:
    body = json.loads(resp.read().decode())

print(body["choices"][0]["message"]["content"])
usage = body.get("usage") or {}
print("prompt_tokens", usage.get("prompt_tokens"))
print("completion_tokens", usage.get("completion_tokens"))
ok
prompt_tokens 13
completion_tokens 5
Le Hub est décrit dans l'article Create Hub ; l'API, dans le SDK Python. Créez une clé, lancez l'extrait, puis remplacez le prompt par une extraction JSON réelle : notre banc du 27 octobre a coûté 0,00625 $.