SDK OpenAI Python : base_url Carpe Diem, clé cdm_, coût réel
Ce tutoriel sert à appeler Carpe Diem depuis un script Python, avec le SDK OpenAI que vous utilisez déjà : chat, liste des modèles, changement de modèle, streaming, lecture du coût. On n'installe qu'un paquet, openai==3.36.0, dans un venv. Ensuite, deux champs suffisent : base_url vers https://carpe-diem.xyz/api/operator/v1 et une clé cdm_. Notre essai du 22 octobre 2026 a obtenu pong de llama-3.3-70b pour 524 micro-USDC ; le même client a listé 392 modèles.
Illustration générée avec seedream-v5-lite sur Carpe Diem.
Ce qu'il vous faut
Rien d'autre que Python, un venv, le SDK OpenAI figé, et une clé Carpe Diem. Pas de CLI Carpe Diem, pas de SDK maison.
- Un compte Carpe Diem avec des crédits ou un compte prepaid, et une clé
cdm_(onglet API Keys du tableau de bord acheteur). - Python 3.10 ou plus (le paquet
openai==3.36.0l'exige). pipdans un venv, pour figeropenai==3.36.0.
À la fin, vous pourrez : envoyer un chat.completions.create (étape 3), lister les identifiants via models.list() (étape 3), lire x-carpe-cost-usdc-micro (étape 4), passer de llama-3.3-70b à claude-haiku-5-5 en changeant une chaîne (étape 5), et streamer un haïku (étape 6).
Étape 1 : créer une clé cdm_
Ouvrez Credits & keys, onglet API Keys. Les clés commencent par cdm_ et ne s'affichent qu'une fois. Choisissez comment la clé paie (Credits ou Prepaid), éventuellement un nom, puis Create a key.
Credits : solde d'usage, 1 crédit = 0,01 $, pas de retrait. Prepaid : compte que vous détenez, le protocole ne prélève que le coût de chaque appel, retrait possible. Les deux se règlent en USDC sur Base (guide, §4.1). Un troisième rail, x402, paie depuis un wallet sans clé cdm_ ; ce tutoriel n'en parle pas.
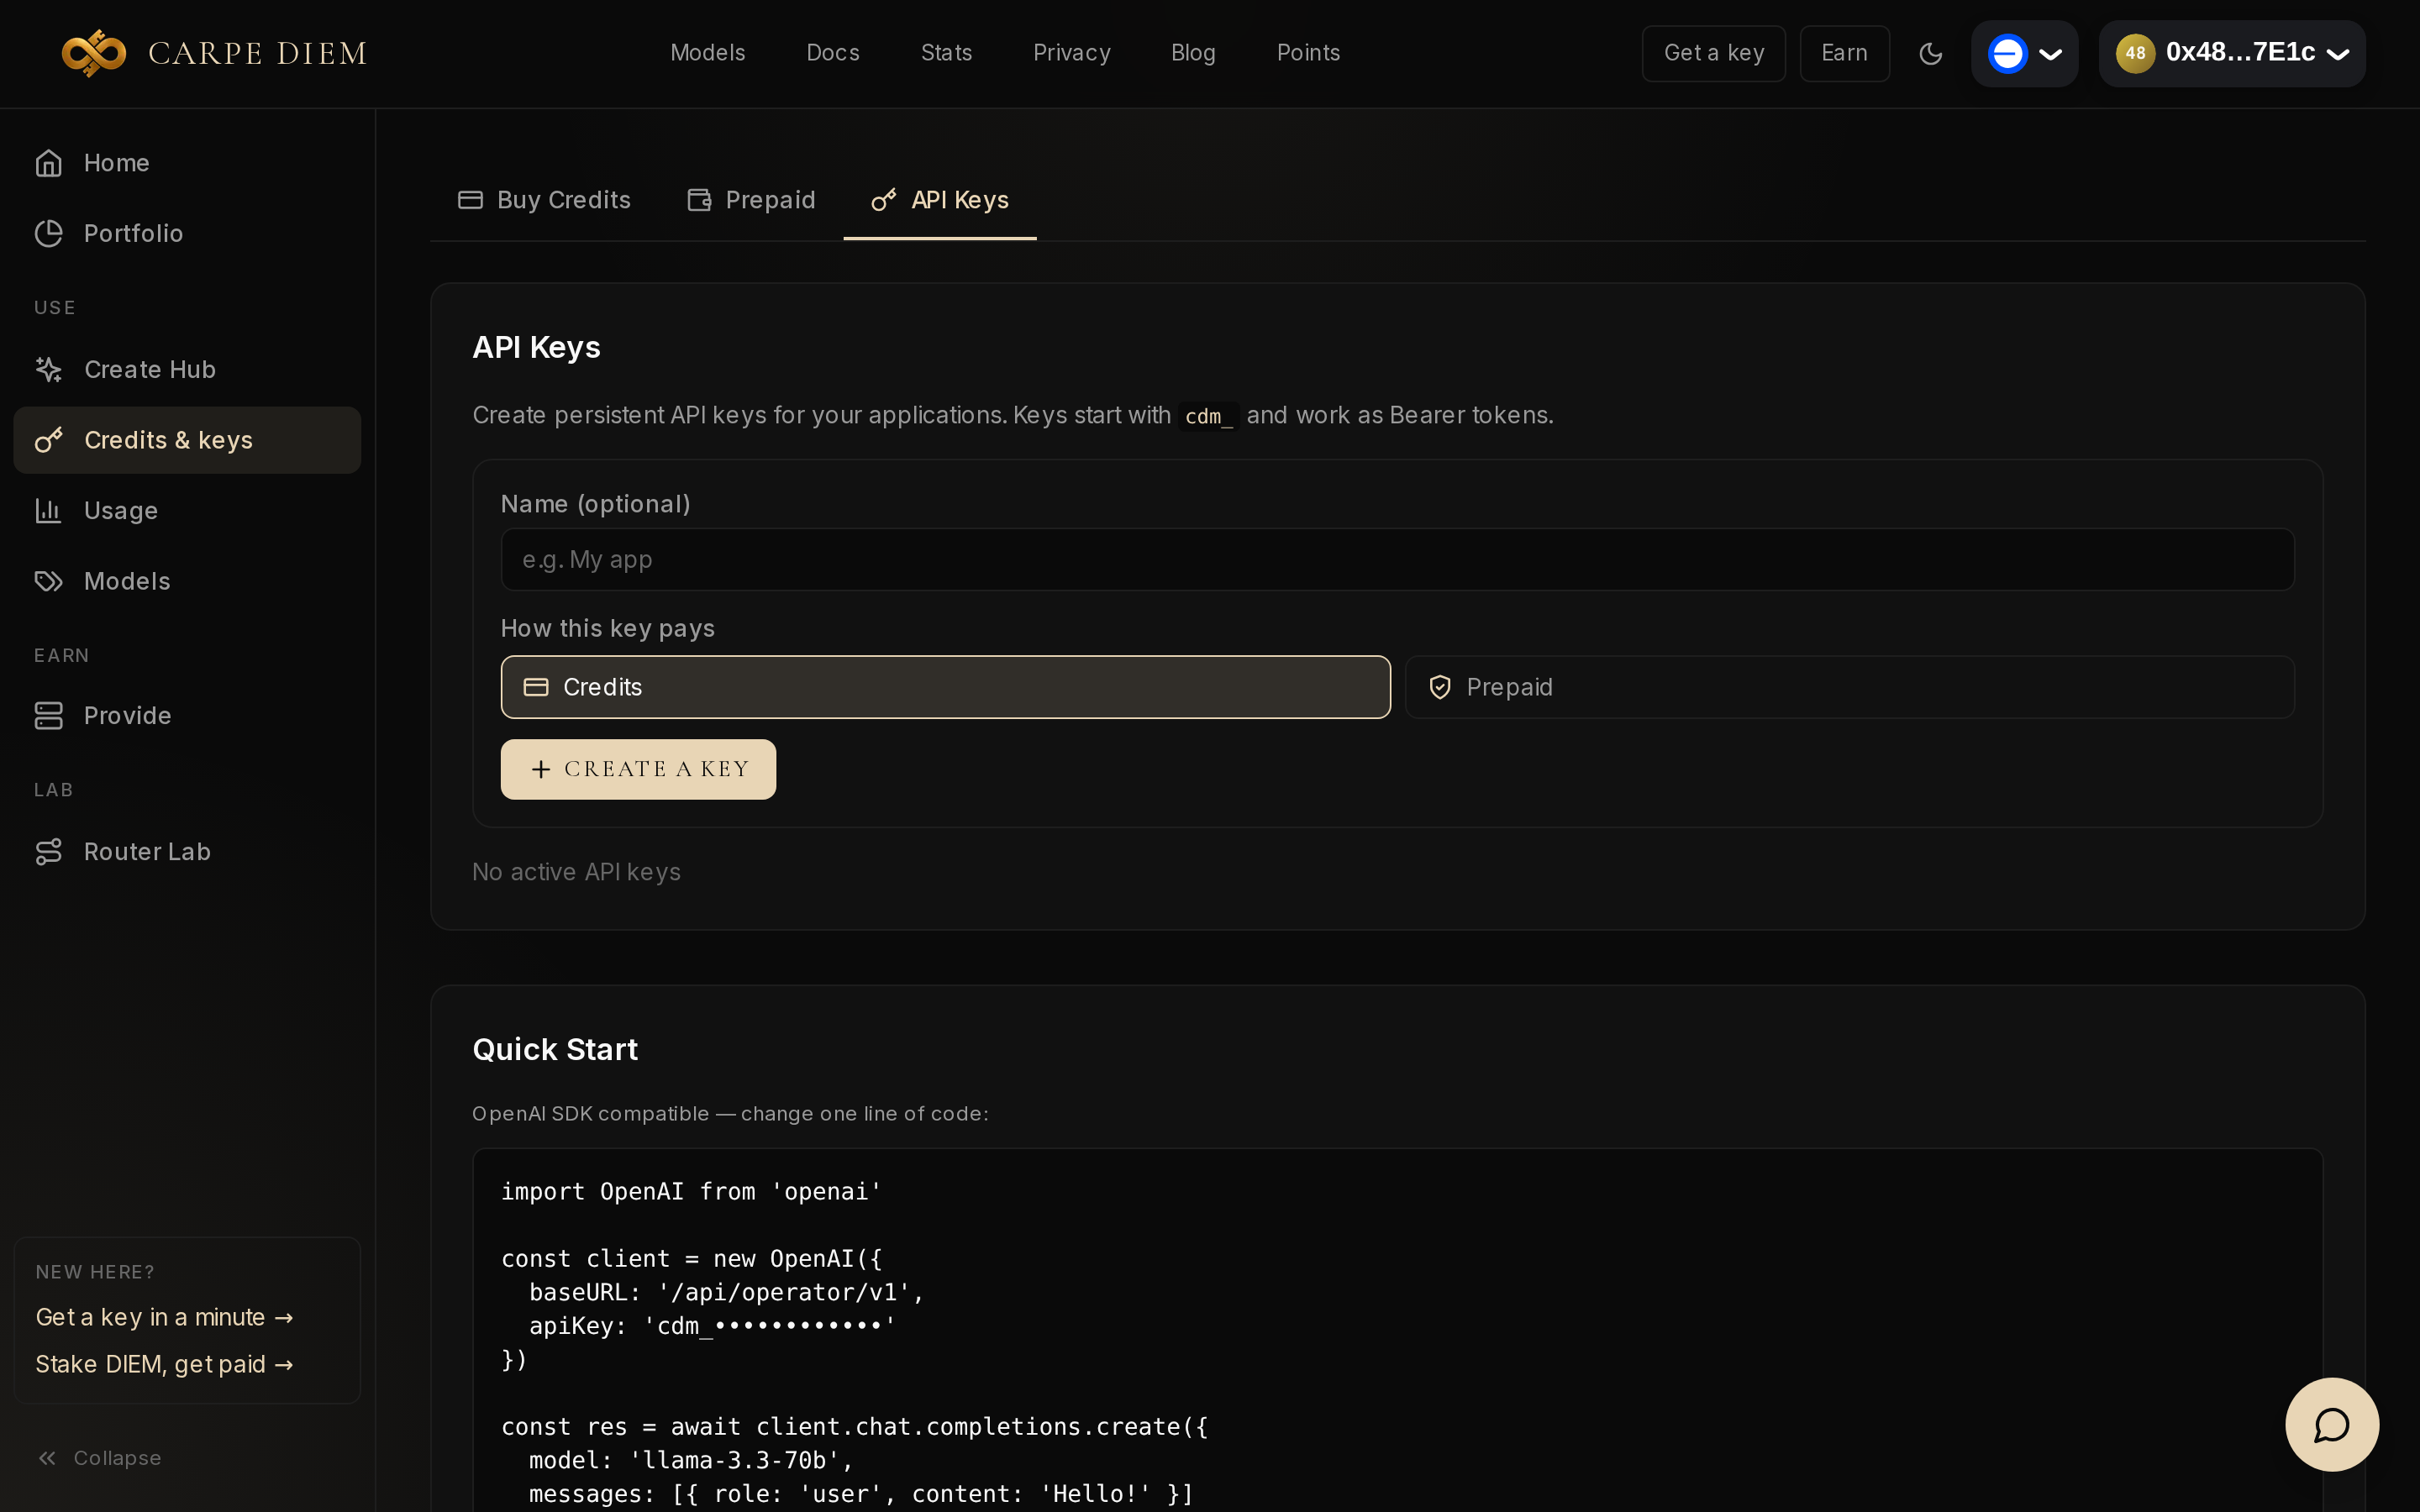
Copiez-la tout de suite dans un gestionnaire de secrets : elle ne sera plus affichée. Dans le shell du tutoriel :
export OPENAI_API_KEY=cdm_your_key_here
Pour tester un modèle sans code, il reste Create Hub.
Étape 2 : installer openai 3.36.0
python3 -m venv .venv
.venv/bin/pip install openai==3.36.0
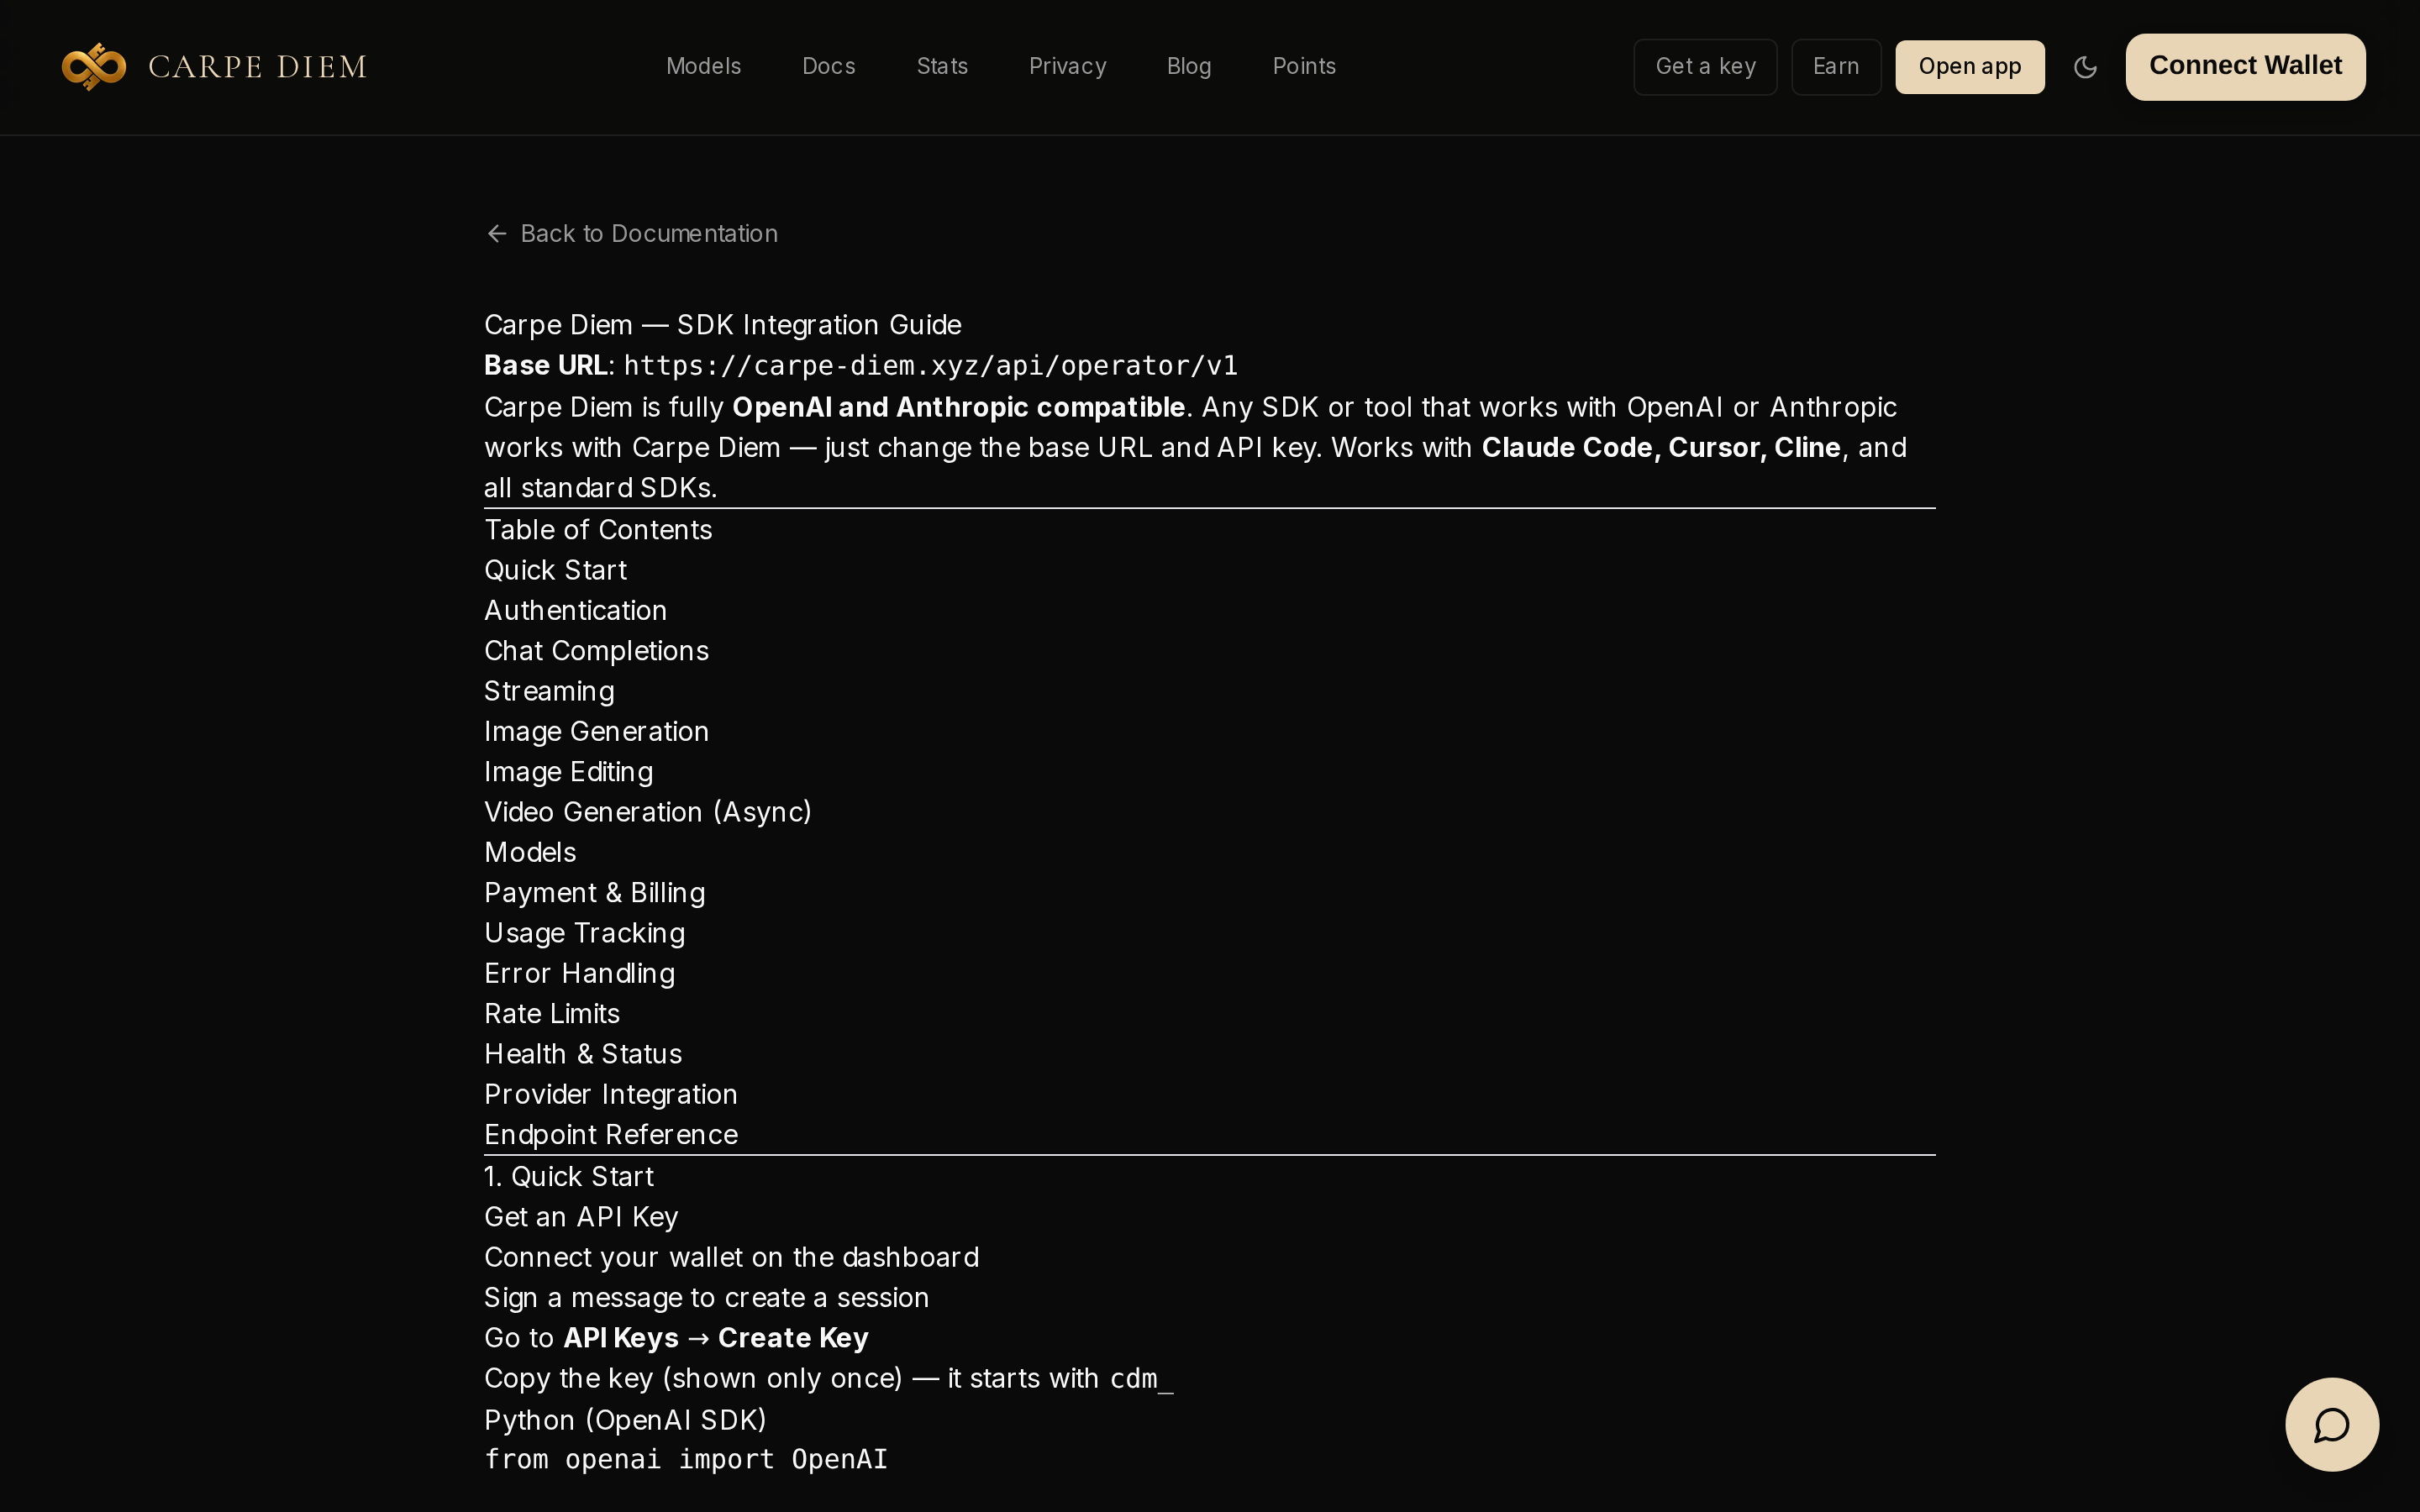
Nous n'avons pas testé d'autre version du paquet. Le client OpenAI envoie POST /chat/completions sous base_url. Pour Carpe Diem, base_url doit donc déjà contenir /v1 :
https://carpe-diem.xyz/api/operator/v1
Pas https://carpe-diem.xyz/api/operator : c'est l'URL de l'adaptateur Anthropic, un autre protocole. Le guide SDK le dit en tête de page, juste au-dessus de l'exemple Python OpenAI.
Étape 3 : envoyer le premier message
Fichier hello.py (le client y est recréé, comme dans chaque extrait) :
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://carpe-diem.xyz/api/operator/v1",
    api_key=os.environ["OPENAI_API_KEY"],
)

response = client.chat.completions.create(
    model="llama-3.3-70b",
    messages=[{"role": "user", "content": "Reply with the exact word: pong"}],
    max_tokens=16,
)

print(response.choices[0].message.content)
print("model:", response.model)
print("usage:", response.usage)
.venv/bin/python hello.py
Sortie obtenue :
pong
model: llama-3.3-70b
usage: CompletionUsage(completion_tokens=2, prompt_tokens=1675, total_tokens=1677, …)
Deux jetons en sortie, mais 1675 en entrée pour une phrase de six mots. Sur nos deux appels à llama-3.3-70b avec ce prompt, 1675 puis 1695 jetons d'entrée ont été facturés (2714 sur Haiku). L'origine de ce préambule n'est pas documentée. max_tokens=16 plafonne seulement la sortie.
Pour vérifier qu'un id existe avant d'écrire le reste :
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://carpe-diem.xyz/api/operator/v1",
    api_key=os.environ["OPENAI_API_KEY"],
)

models = client.models.list()
ids = sorted(m.id for m in models.data)
print("count:", len(ids))
print("has llama-3.3-70b:", "llama-3.3-70b" in ids)
print("has claude-haiku-5-5:", "claude-haiku-5-5" in ids)
Sortie : 392 identifiants, les deux True. models.list() appelle GET /v1/models avec la même clé : pas besoin d'un second client.
Étape 4 : lire le coût de l'appel
Le corps JSON du SDK ne porte pas le prix. Carpe Diem le met dans les en-têtes HTTP, en micro-USDC (1 USDC = 1 000 000 micro-USDC), hors streaming. C'est documenté dans le guide SDK, table des en-têtes X-Carpe-*. with_raw_response les expose ; raw.parse() redonne l'objet habituel.
Fichier cost.py :
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://carpe-diem.xyz/api/operator/v1",
    api_key=os.environ["OPENAI_API_KEY"],
)

raw = client.chat.completions.with_raw_response.create(
    model="llama-3.3-70b",
    messages=[{"role": "user", "content": "Reply with the exact word: pong"}],
    max_tokens=16,
)

headers = raw.headers
print("x-carpe-cost-usdc-micro:", headers.get("x-carpe-cost-usdc-micro"))
print("x-carpe-input-tokens:", headers.get("x-carpe-input-tokens"))
print("x-carpe-output-tokens:", headers.get("x-carpe-output-tokens"))
print("x-carpe-available-credits:", headers.get("x-carpe-available-credits"))
print("x-carpe-cached-tokens:", headers.get("x-carpe-cached-tokens"))

response = raw.parse()
print("text:", response.choices[0].message.content)
print("usage:", response.usage)
En-têtes lus sur cet appel :
x-carpe-cost-usdc-micro: 524x-carpe-input-tokens: 1675x-carpe-output-tokens: 2x-carpe-available-credits: votre solde restant, en créditsx-carpe-cached-tokens: absent (Nonecôté SDK)
524 micro-USDC. Au tarif 0,311 $ / 1,24 $ par million de jetons (31,1 / 124 cr/M sur /models, 1 crédit = 0,01 $), 1675 × 0,311 $ / M + 2 × 1,24 $ / M = 523 micro-USDC. 523 calculés, 524 débités : le montant semble arrondi au micro-USDC supérieur.
Étape 5 : changer de modèle par une chaîne
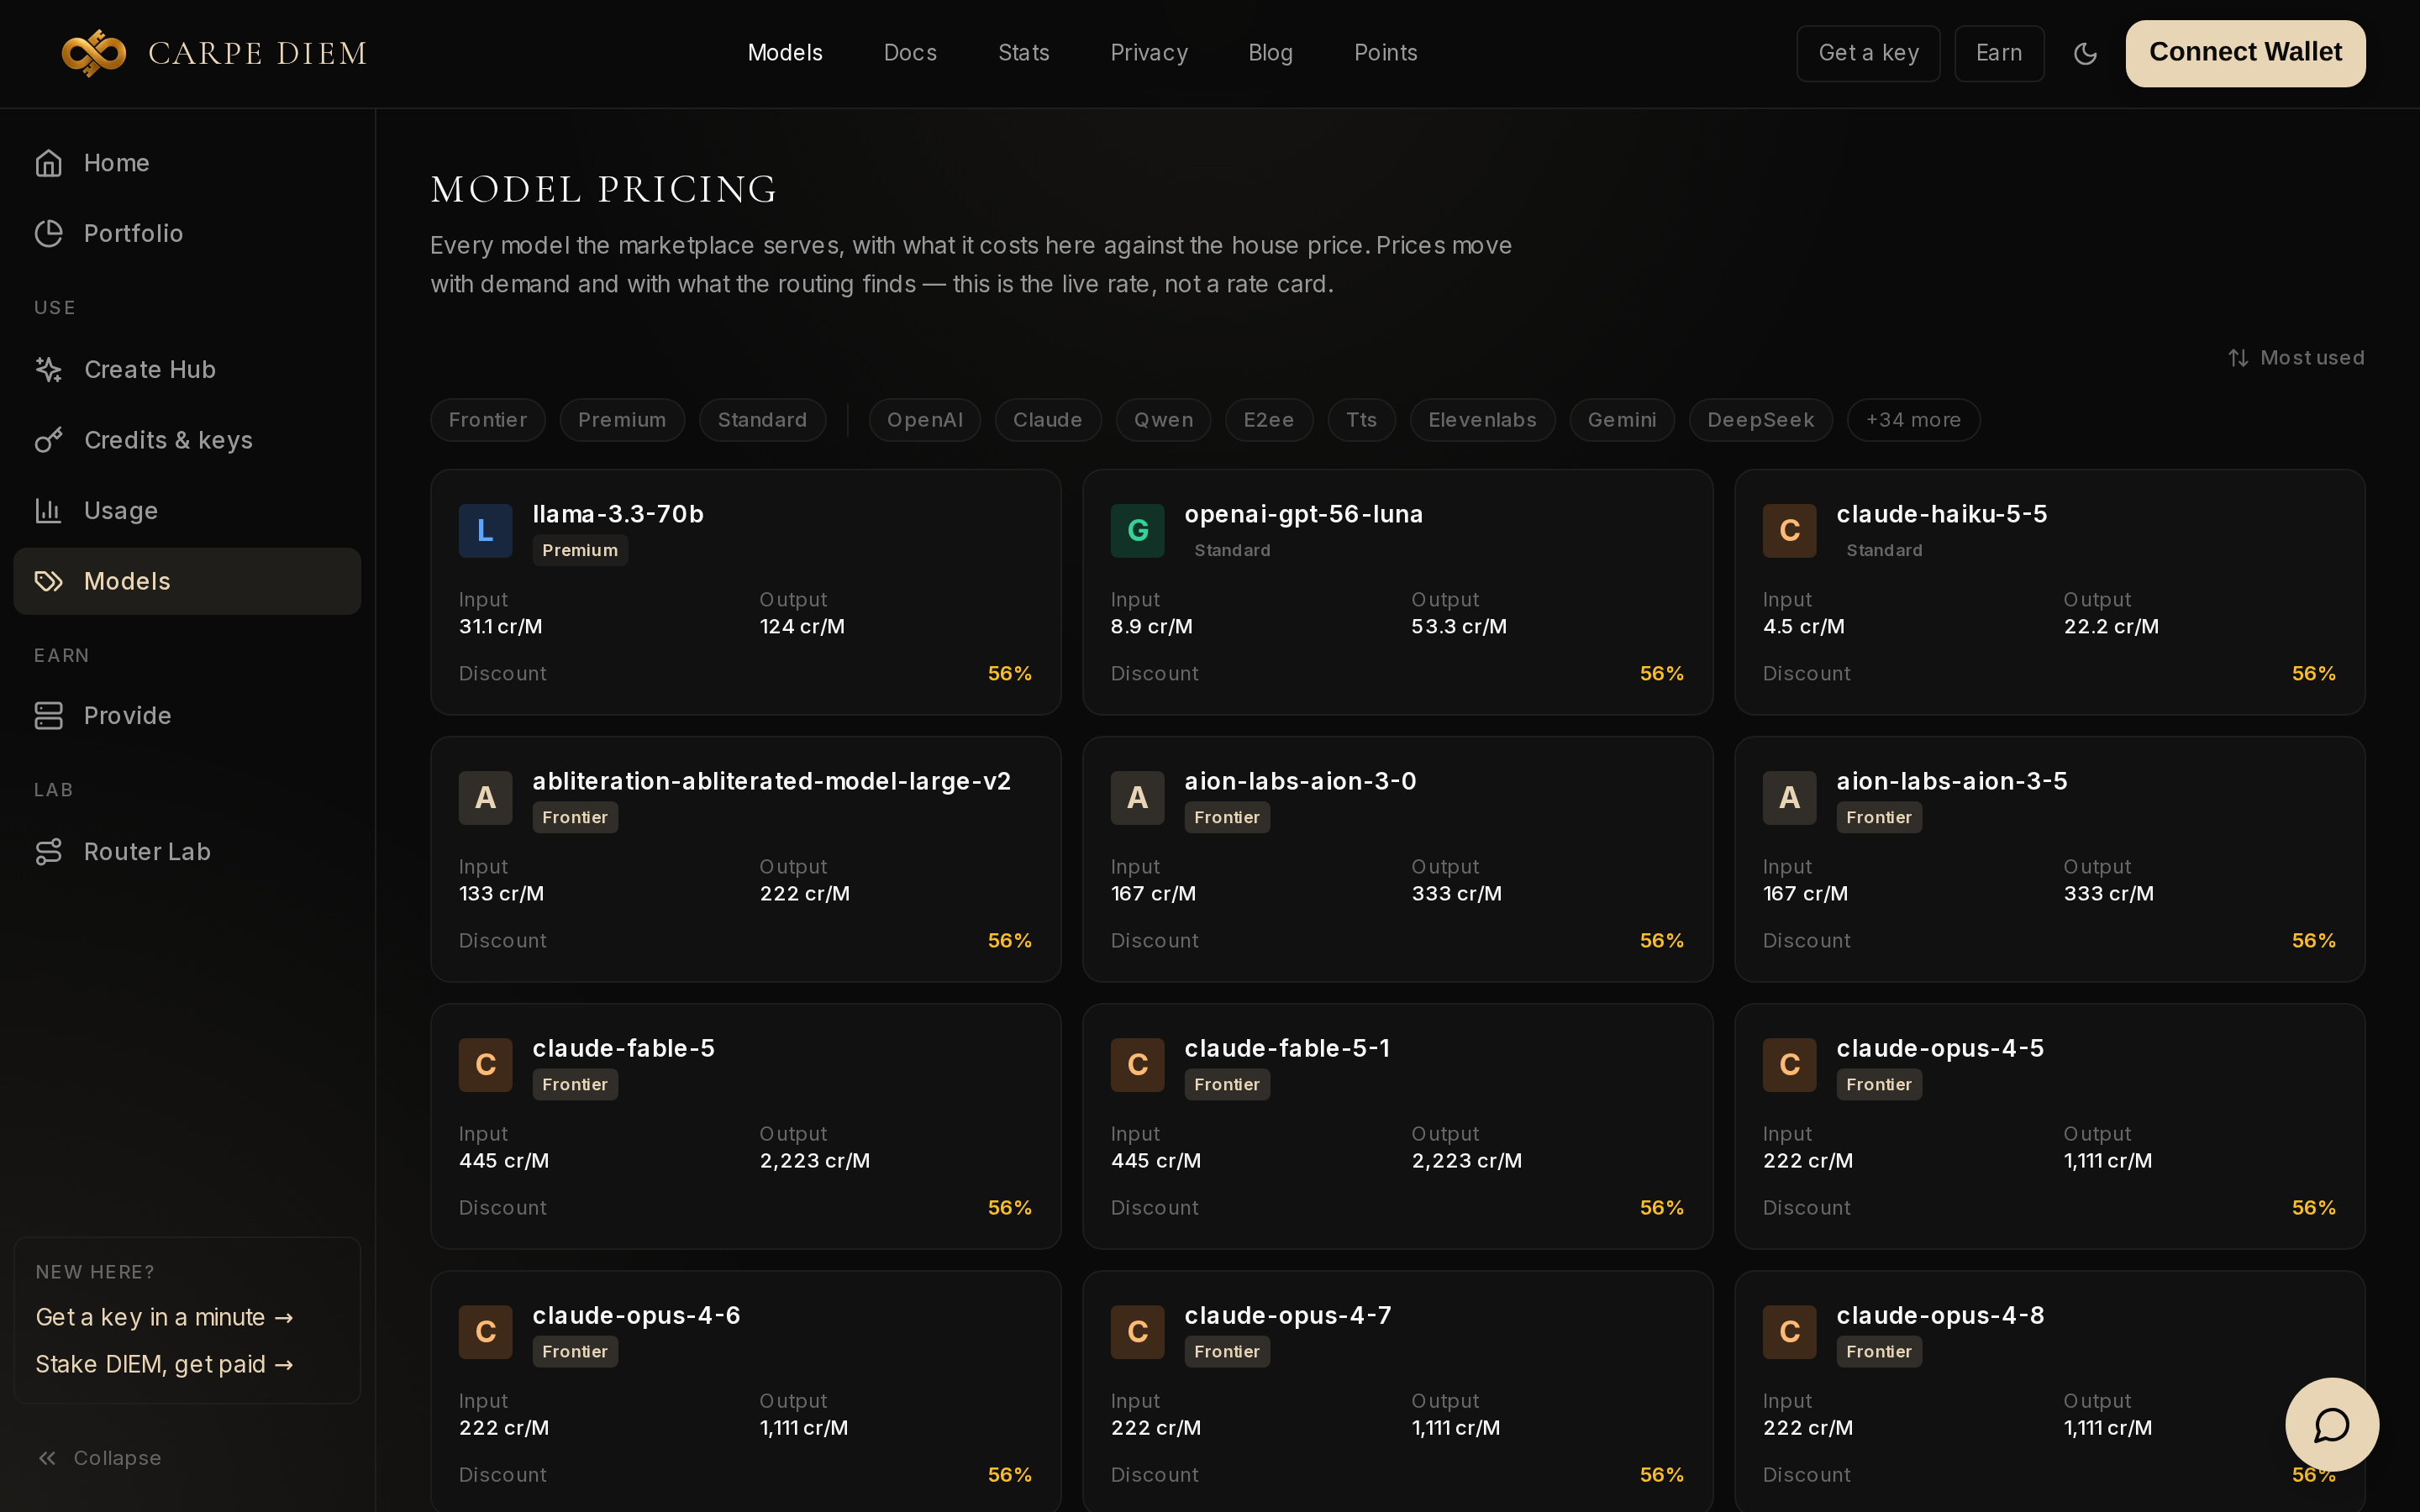
Même client, autre identifiant. Le catalogue public affiche les prix en crédits par million (1 crédit = 0,01 $) : llama-3.3-70b à 31,1 / 124 cr/M, claude-haiku-5-5 à 4,5 / 22,2 cr/M.
Fichier switch_model.py :
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://carpe-diem.xyz/api/operator/v1",
    api_key=os.environ["OPENAI_API_KEY"],
)

for model in ("llama-3.3-70b", "claude-haiku-5-5"):
    raw = client.chat.completions.with_raw_response.create(
        model=model,
        messages=[{"role": "user", "content": "Reply with the exact word: pong"}],
        max_tokens=16,
    )
    text = raw.parse().choices[0].message.content
    print(model)
    print("  text:", text)
    print("  cost-usdc-micro:", raw.headers.get("x-carpe-cost-usdc-micro"))
    print("  in:", raw.headers.get("x-carpe-input-tokens"), "out:", raw.headers.get("x-carpe-output-tokens"))
Les deux ont répondu pong. Sur ce second passage, llama-3.3-70b a coûté 530 micro-USDC pour 1695 + 2 jetons, du même ordre que les 524 / 1675 de l'étape 4. claude-haiku-5-5 a été débité 14 micro-USDC, avec 2714 + 4 jetons dans les en-têtes. Au tarif catalogue 4,5 / 22,2 cr/M, ces jetons donneraient environ 123 micro-USDC : l'écart n'est pas expliqué (nous n'avons pas lu x-carpe-cached-tokens sur cet appel). Le chiffre à retenir est celui de l'en-tête, pas le calcul à la main.
Les identifiants se copient depuis /models. llama-3.3-70b-typo n'a pas été réécrit vers llama-3.3-70b : collez l'id de la carte.
Étape 6 : brancher le streaming
Gardez le test chunk.choices : le guide SDK l'utilise, et un chunk sans choix ferait planter chunk.choices[0].
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://carpe-diem.xyz/api/operator/v1",
    api_key=os.environ["OPENAI_API_KEY"],
)

stream = client.chat.completions.create(
    model="llama-3.3-70b",
    messages=[{"role": "user", "content": "Write a haiku about the sea."}],
    max_tokens=64,
    stream=True,
)

for chunk in stream:
    if chunk.choices and chunk.choices[0].delta.content:
        print(chunk.choices[0].delta.content, end="", flush=True)
print()
Texte reçu, jeton par jeton :
Crashing waves ascend
Foam kisses the sandy shore
Ocean's gentle song
En streaming, X-Carpe-Cost-Usdc-Micro n'est pas envoyé (doc SDK). Pour tracer le coût, restez sur l'appel non streamé.
Si ça ne marche pas
401 AUTH_REQUIRED. Avec OPENAI_API_KEY=cdm_invalid, le SDK a levé openai.AuthenticationError: Error code: 401 - {'error': 'Unauthorized', 'code': 'AUTH_REQUIRED'}. Clé incomplète, mal copiée, ou variable d'environnement non exportée dans ce shell. Un export dans un terminal n'atteint pas un IDE lancé depuis le dock.
400 MODEL_ERROR. model="llama-3.3-70b-typo" a renvoyé : This model is no longer available upstream. Try a newer version of the same model. Le message parle d'un retrait amont ; ici c'était une faute de frappe. Vérifiez l'id sur /models ou via client.models.list().
URL sans /v1. Voir l'étape 2.
Aller plus loin
Le même base_url avec /v1 remplacé par /router envoie l'appel au routeur au meilleur prix : même clé, même corps. Nous n'avons pas rejoué hello.py sur /router dans cet essai.
Pour un agent dans le terminal plutôt qu'un script, on a déjà branché OpenCode : Kimi K3 et Claude Fable dans OpenCode.
Pour un modèle sans écrire hello.py, ouvrez Create Hub, puis revenez coller l'id dans model=.
Essai réalisé le 22 octobre 2026 avec openai==3.36.0 et une clé de test créditée. Les extraits sont ceux qui ont tourné ici.