KI-Modellpreise vergleichen: Katalog und Kostenschätzung
KI-Modellpreise zu vergleichen beginnt oft beim Listenpreis des Anbieters, etwa auf BenchLM. Die Seite Model pricing von Carpe Diem zeigt den Live-Preis des Marktplatzes, Filter nach Nutzung und einen Last-Schätzer: bis zu 3 Modelle, mit den Kosten einer typischen Anfrage auf /v1 und auf /router. Die Seite ist öffentlich: Sie brauchen kein Wallet, um die Preise zu lesen.
Was Model pricing zeigt
Das Banner warnt: es ist « the live rate, not a rate card ». Die Tarife bewegen sich mit der Nachfrage und mit dem, was das Routing findet. Zum Zeitpunkt unseres Versuchs meldete die Seite 49 % unter dem Listenpreis von Venice. Für llama-3.3-70b lag die Million Tokens Eingabe / Ausgabe bei 0,36 $ / 1,44 $ auf Carpe Diem, gegenüber 0,70 $ / 2,80 $ bei Venice.
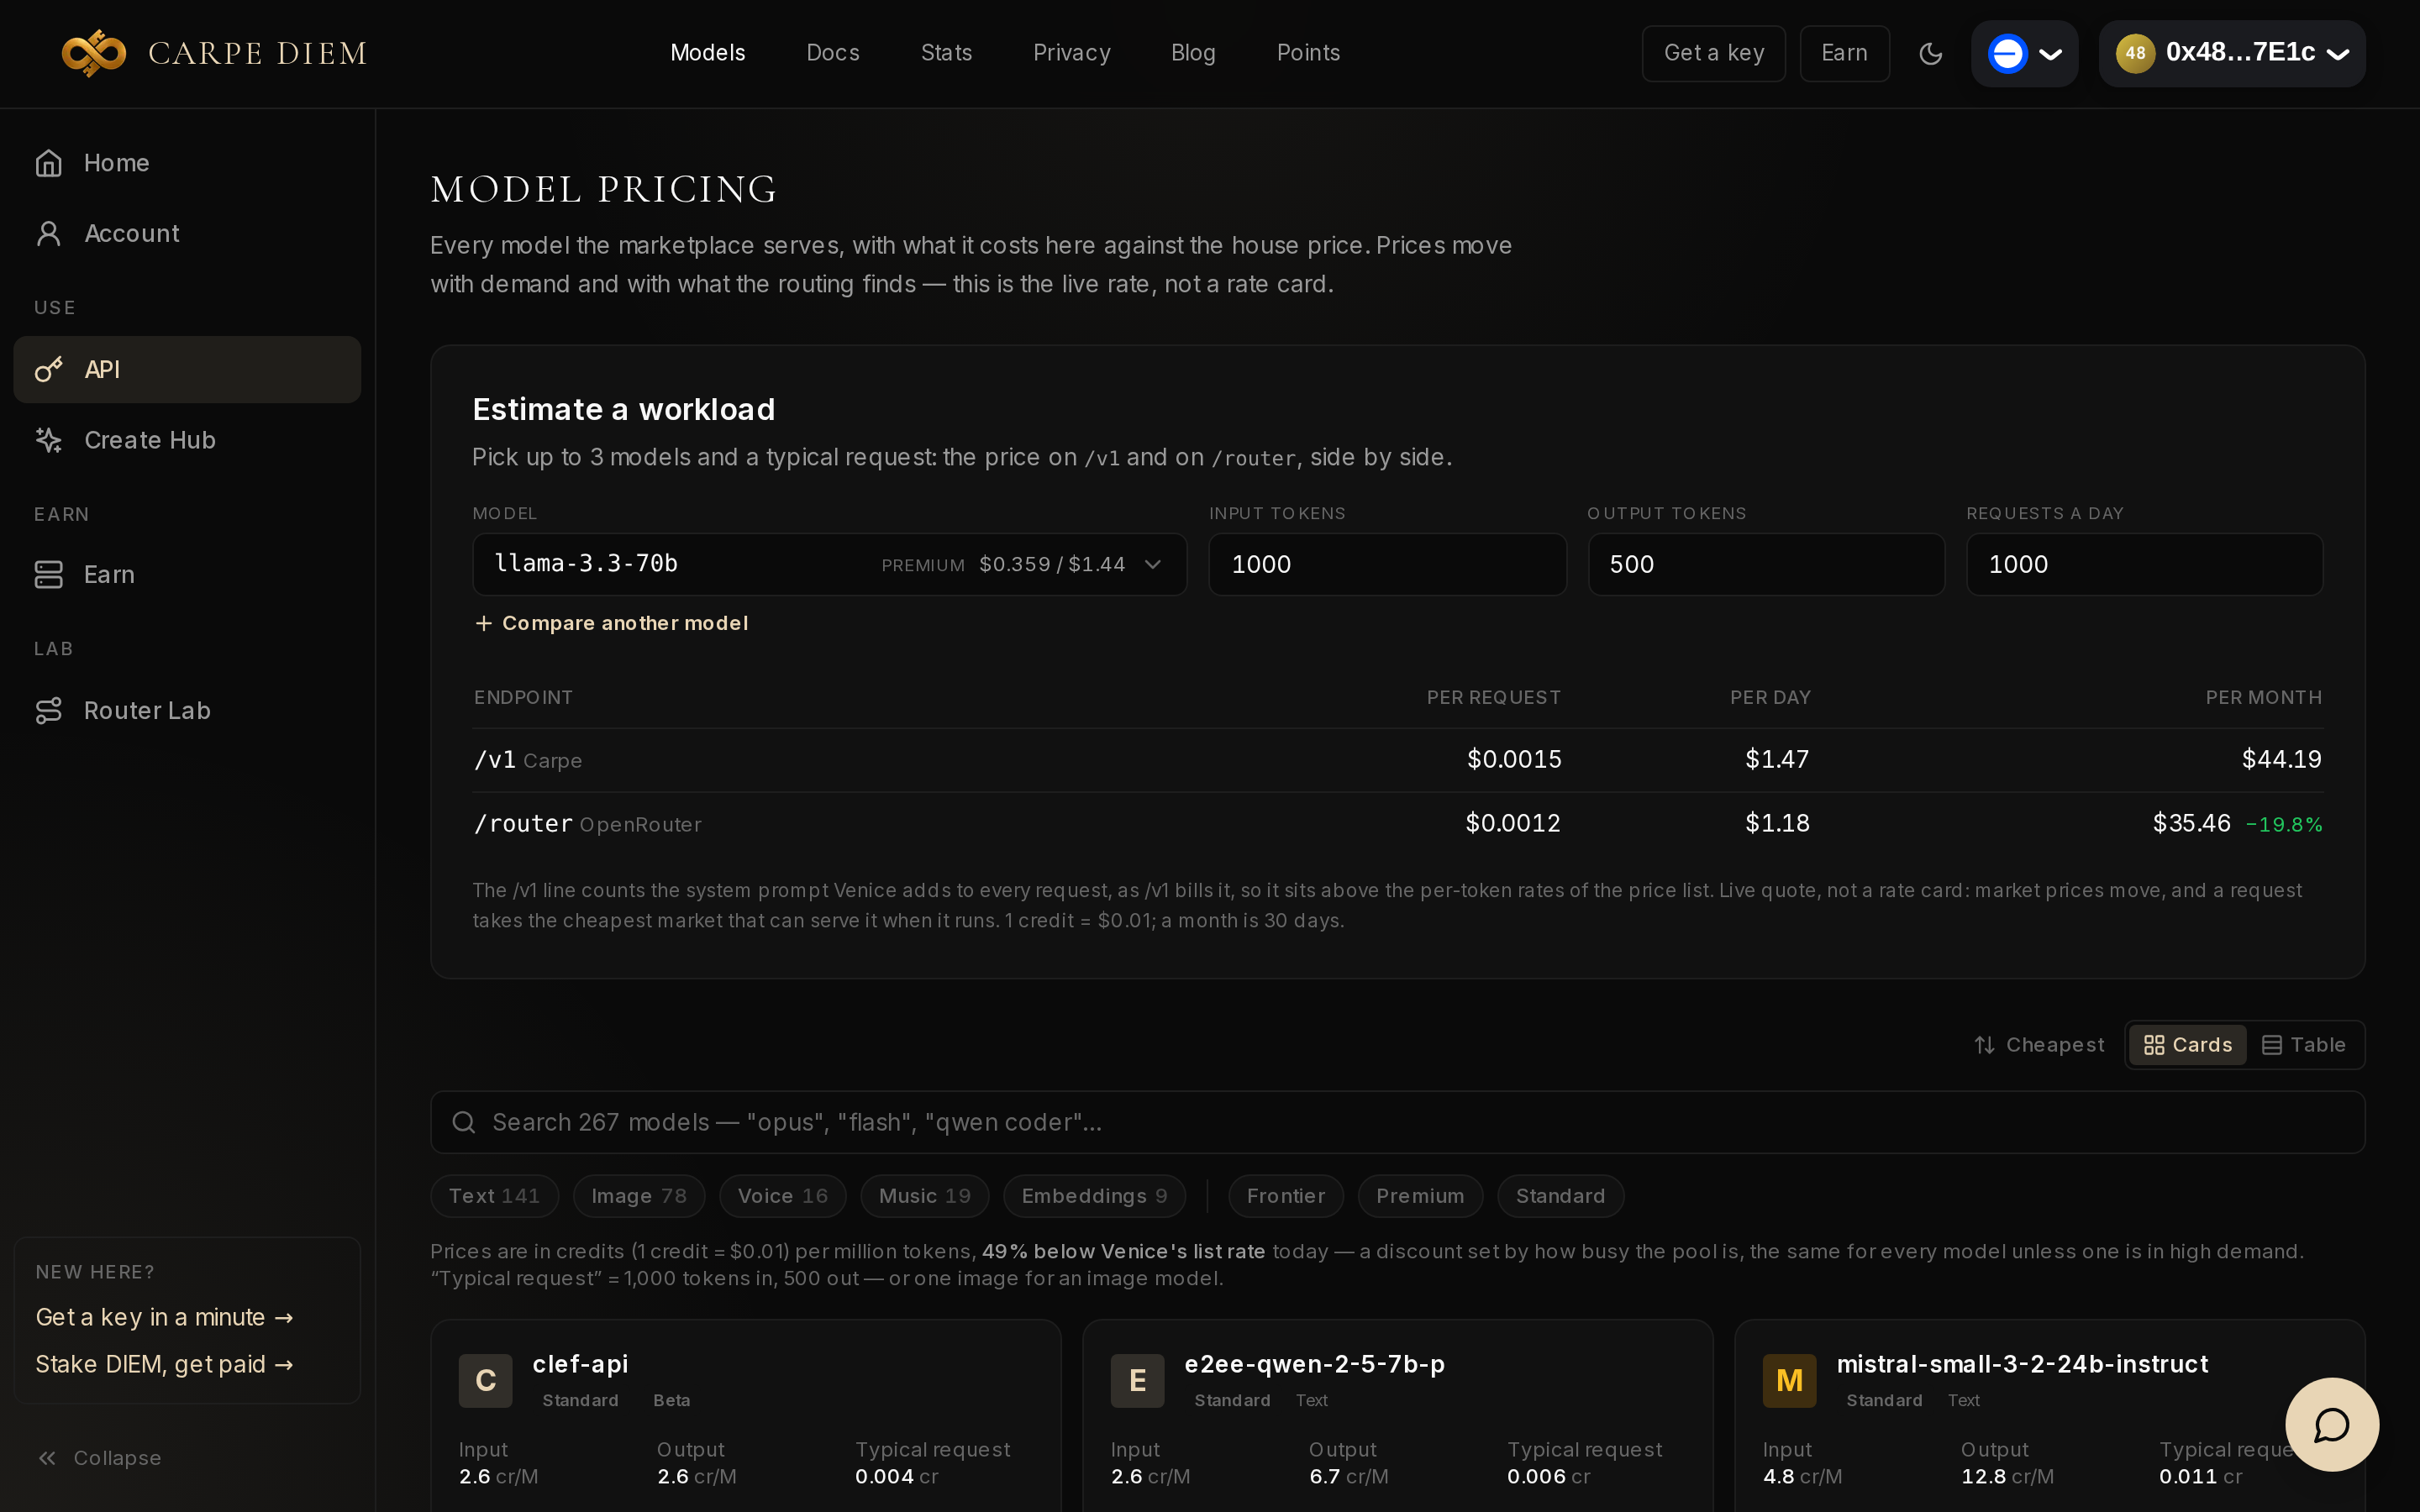
Der Block Estimate a workload ist vorausgefüllt: llama-3.3-70b, 1000 Eingabe-Tokens, 500 Ausgabe, 1000 Anfragen pro Tag. Für diese Last zeigte /v1 0,0015 $ pro Anfrage (44,19 $ pro Monat) und /router, das OpenRouter gewählt hatte, 0,0012 $ (35,46 $ pro Monat, −19,8 %). Eine Fußnote sagt, ein Monat zählt 30 Tage und die Zeile /v1 enthält den System-Prompt von Venice, der mit dem Aufruf berechnet wird.
Unter dem Block öffnet sich das Raster als Karten, sortiert nach steigendem Preis. Pillen filtern nach Nutzung (Text, Bild, Stimme, Musik, Embeddings) oder nach Stufe, und ein Knopf wechselt zur Ansicht Table. Das Suchfeld deckt den ganzen Katalog ab, 267 Modelle an diesem Tag.
Drei Modelle, dieselbe Last
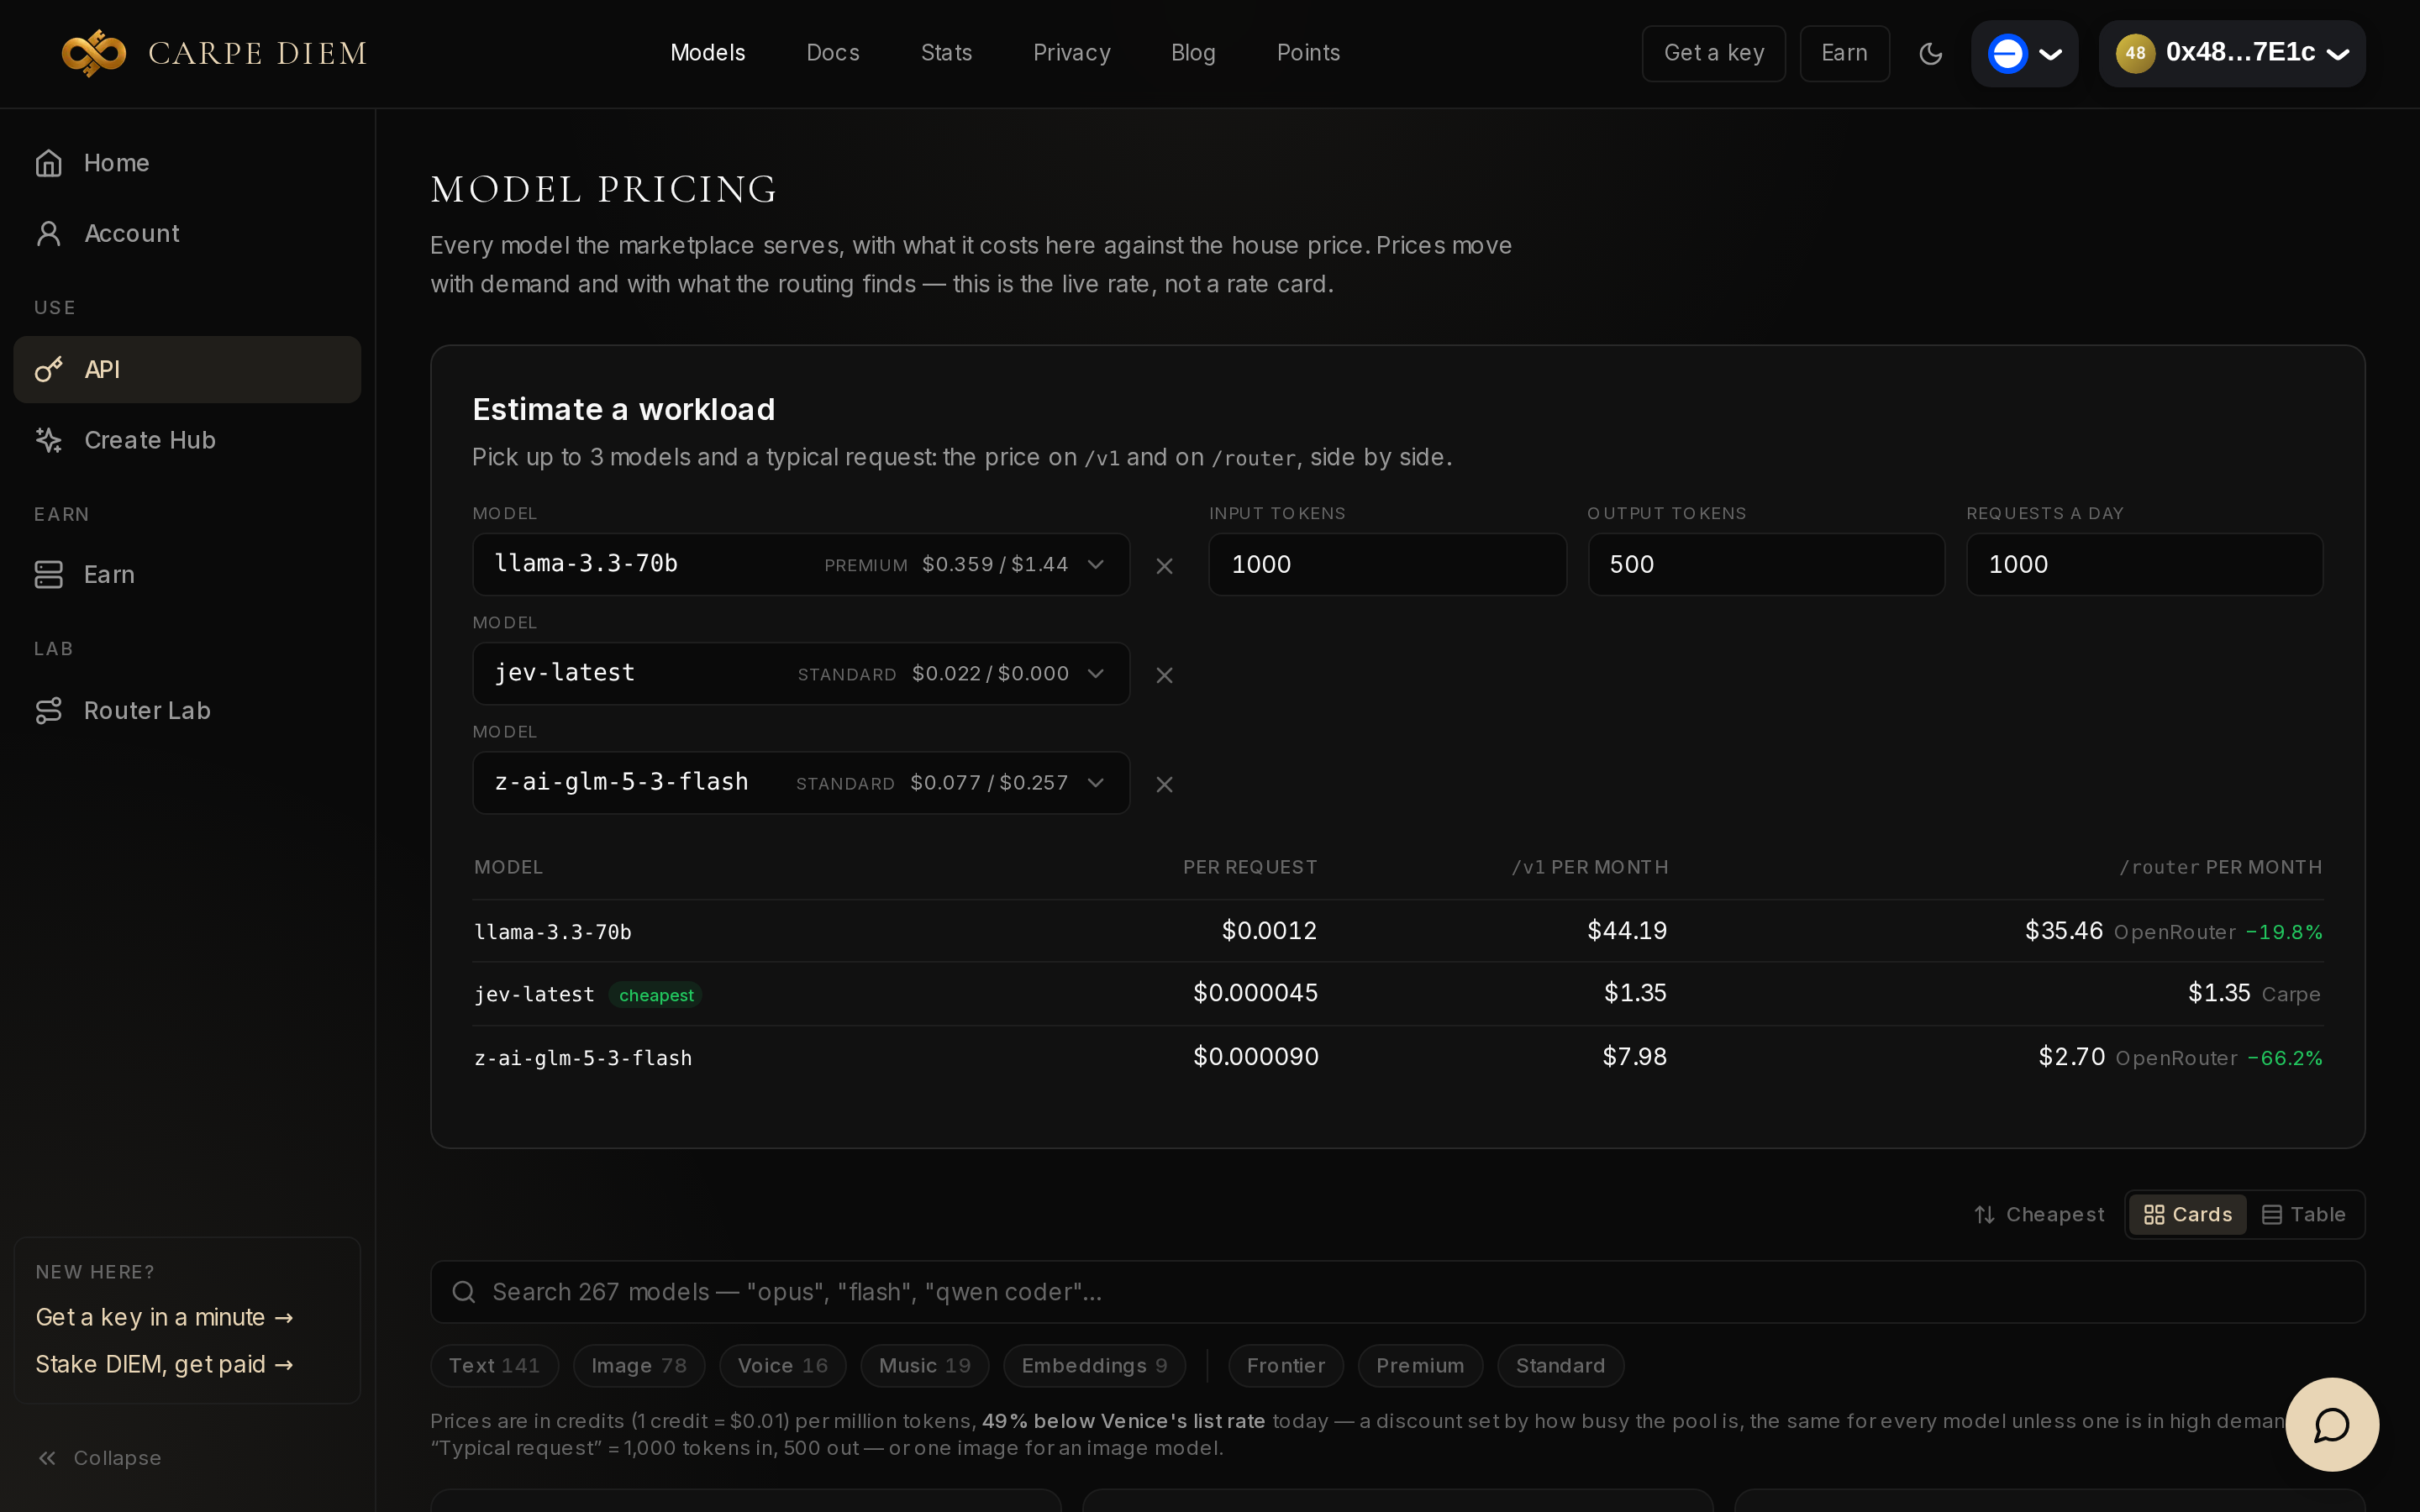
Wir haben den Standardkorb behalten und zweimal auf Compare another model geklickt. Die Oberfläche hat jev-latest hinzugefügt, dann z-ai-glm-5-3-flash. Die Tabelle wechselt auf eine Zeile pro Modell.
| Modell | /v1 pro Monat |
/router pro Monat |
|---|---|---|
llama-3.3-70b |
44,19 $ | 35,46 $ (OpenRouter) |
jev-latest (cheapest) |
1,35 $ | 1,35 $ (Markt Carpe) |
z-ai-glm-5-3-flash |
7,98 $ | 2,70 $ (OpenRouter) |
Das Badge cheapest bezeichnet den günstigsten Monat unter den gezeigten Spalten, nicht das beste Modell für Ihre Aufgabe. Der Abstand von /router hängt vom Modell ab: −19,8 % bei Llama, −66,2 % bei GLM Flash, nichts bei jev-latest, das Carpe bereits zum besten Preis bedient.
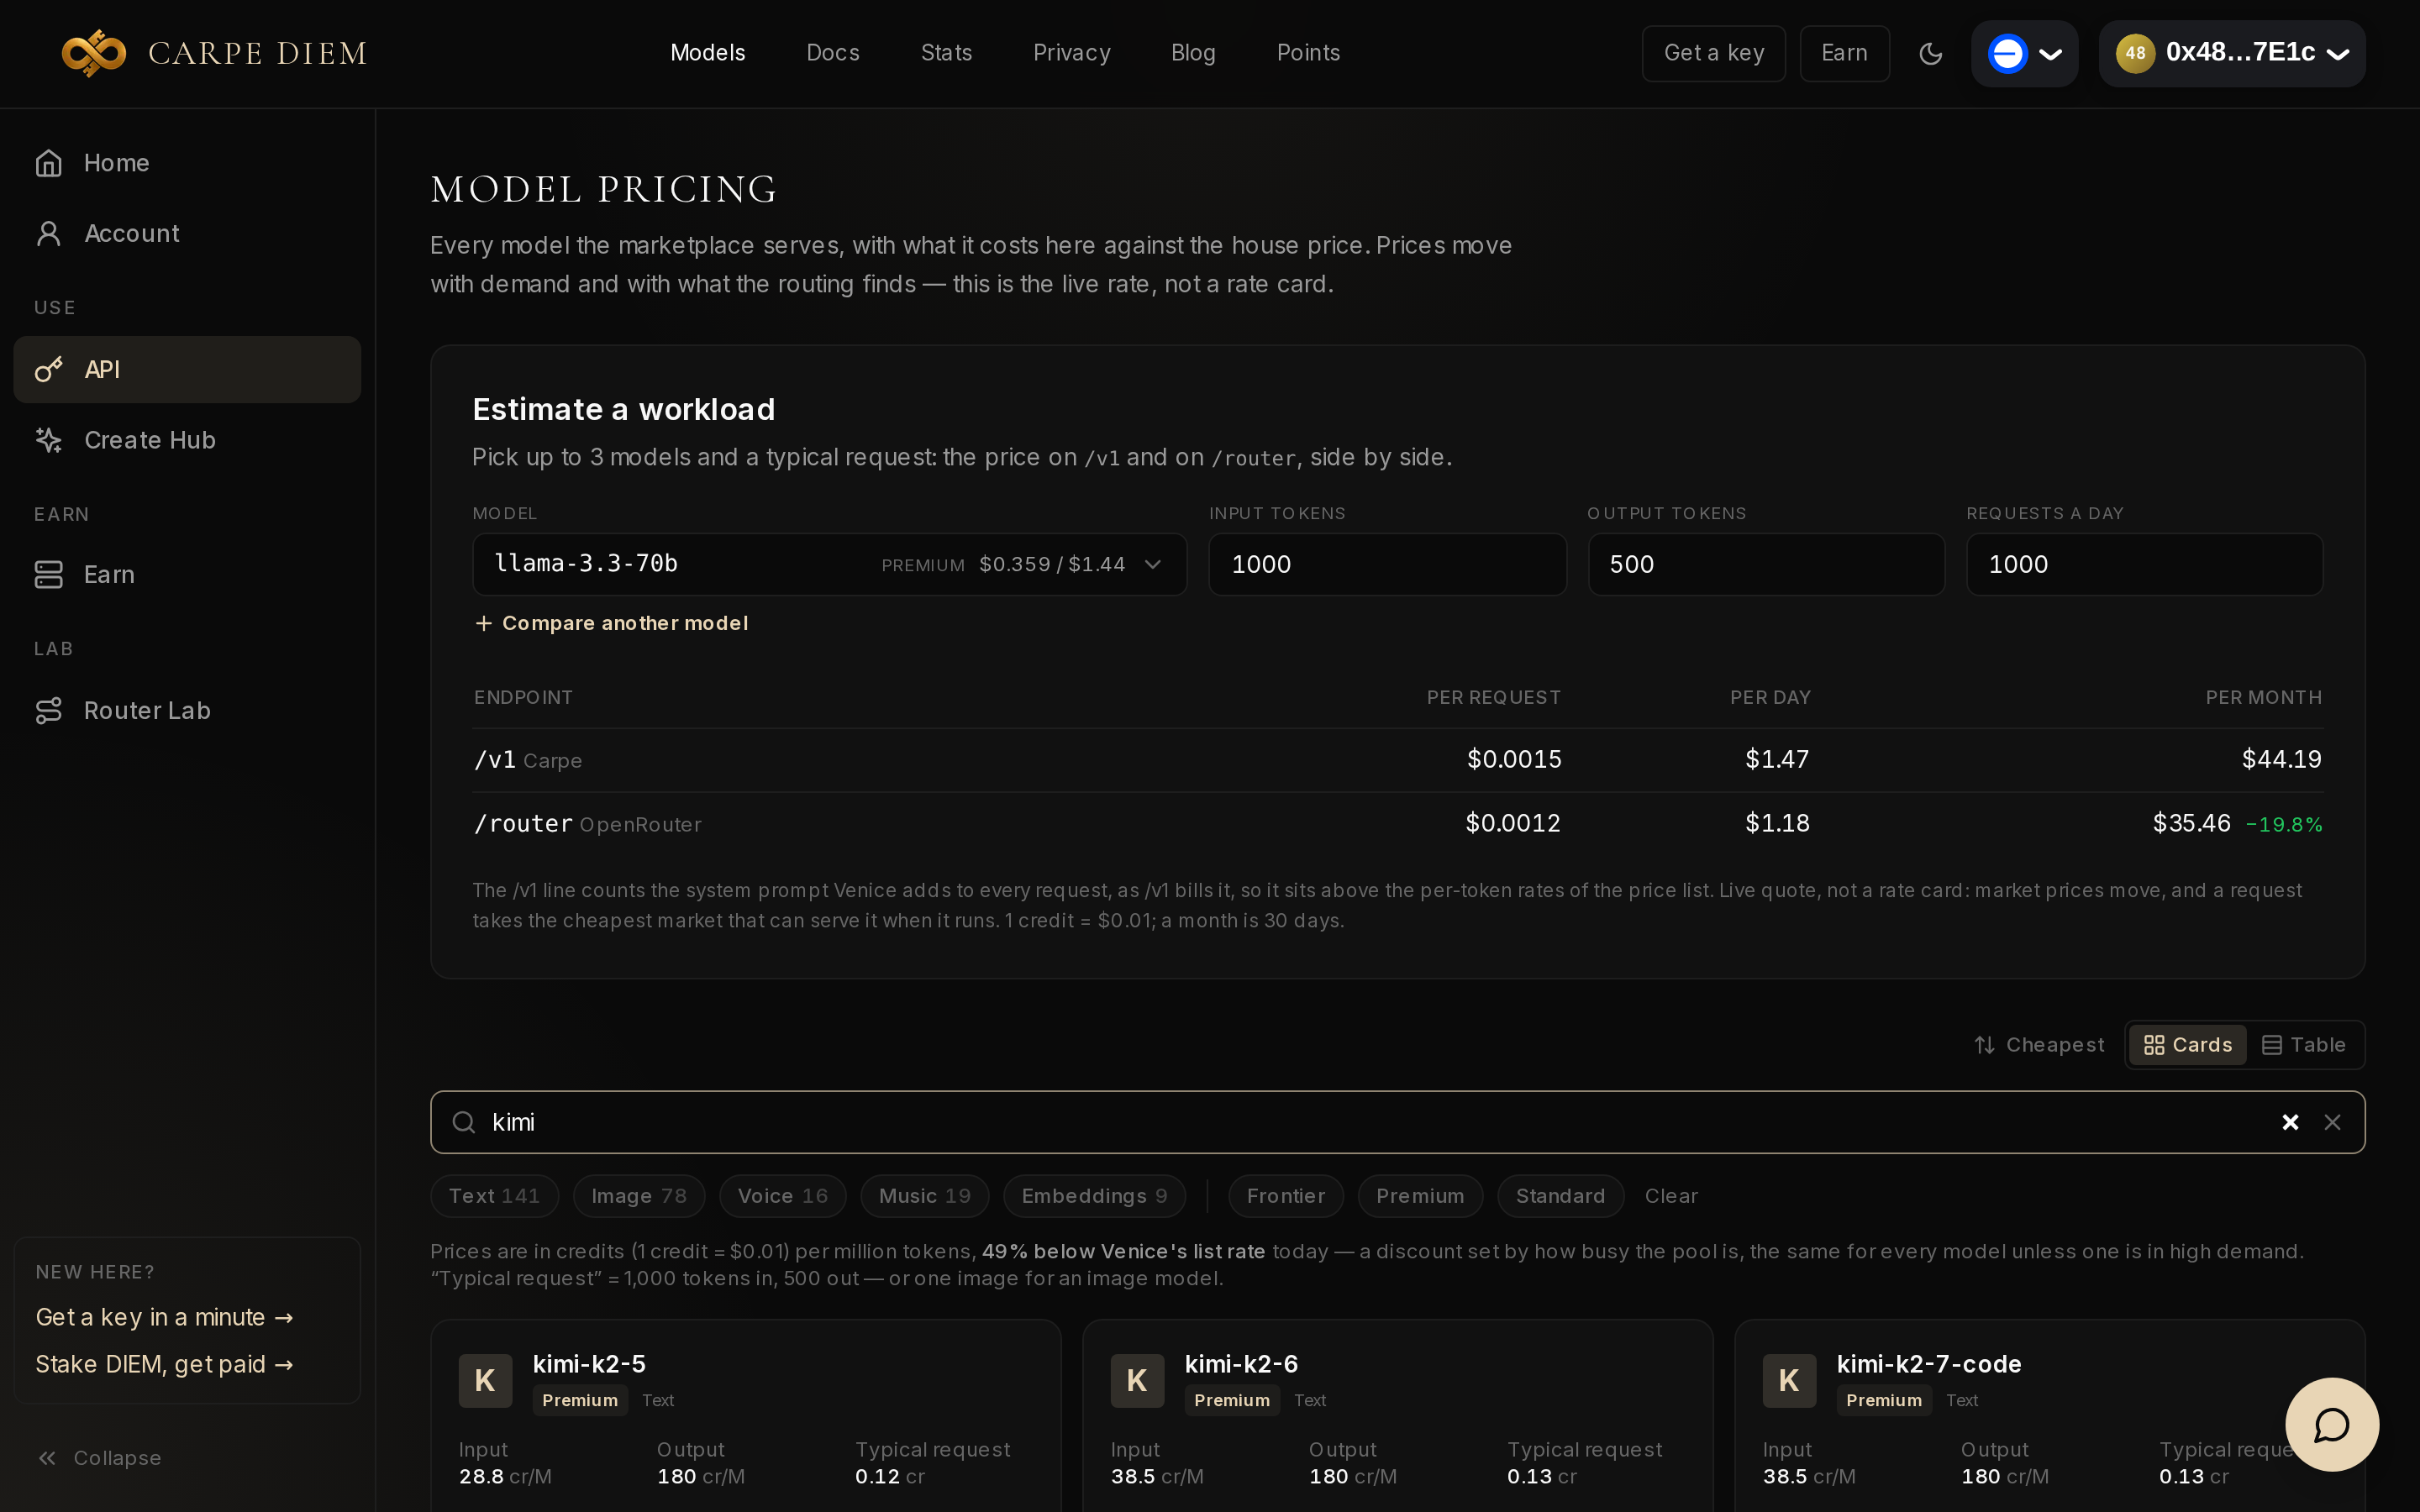
Um ein bestimmtes Modell zu treffen, funktioniert die Suche nach Wörtern: « kimi » listet kimi-k2-5, kimi-k2-6 und kimi-k2-7-code. Der Knopf Estimate auf einer Textkarte legt es in den Block oben, höchstens 3.
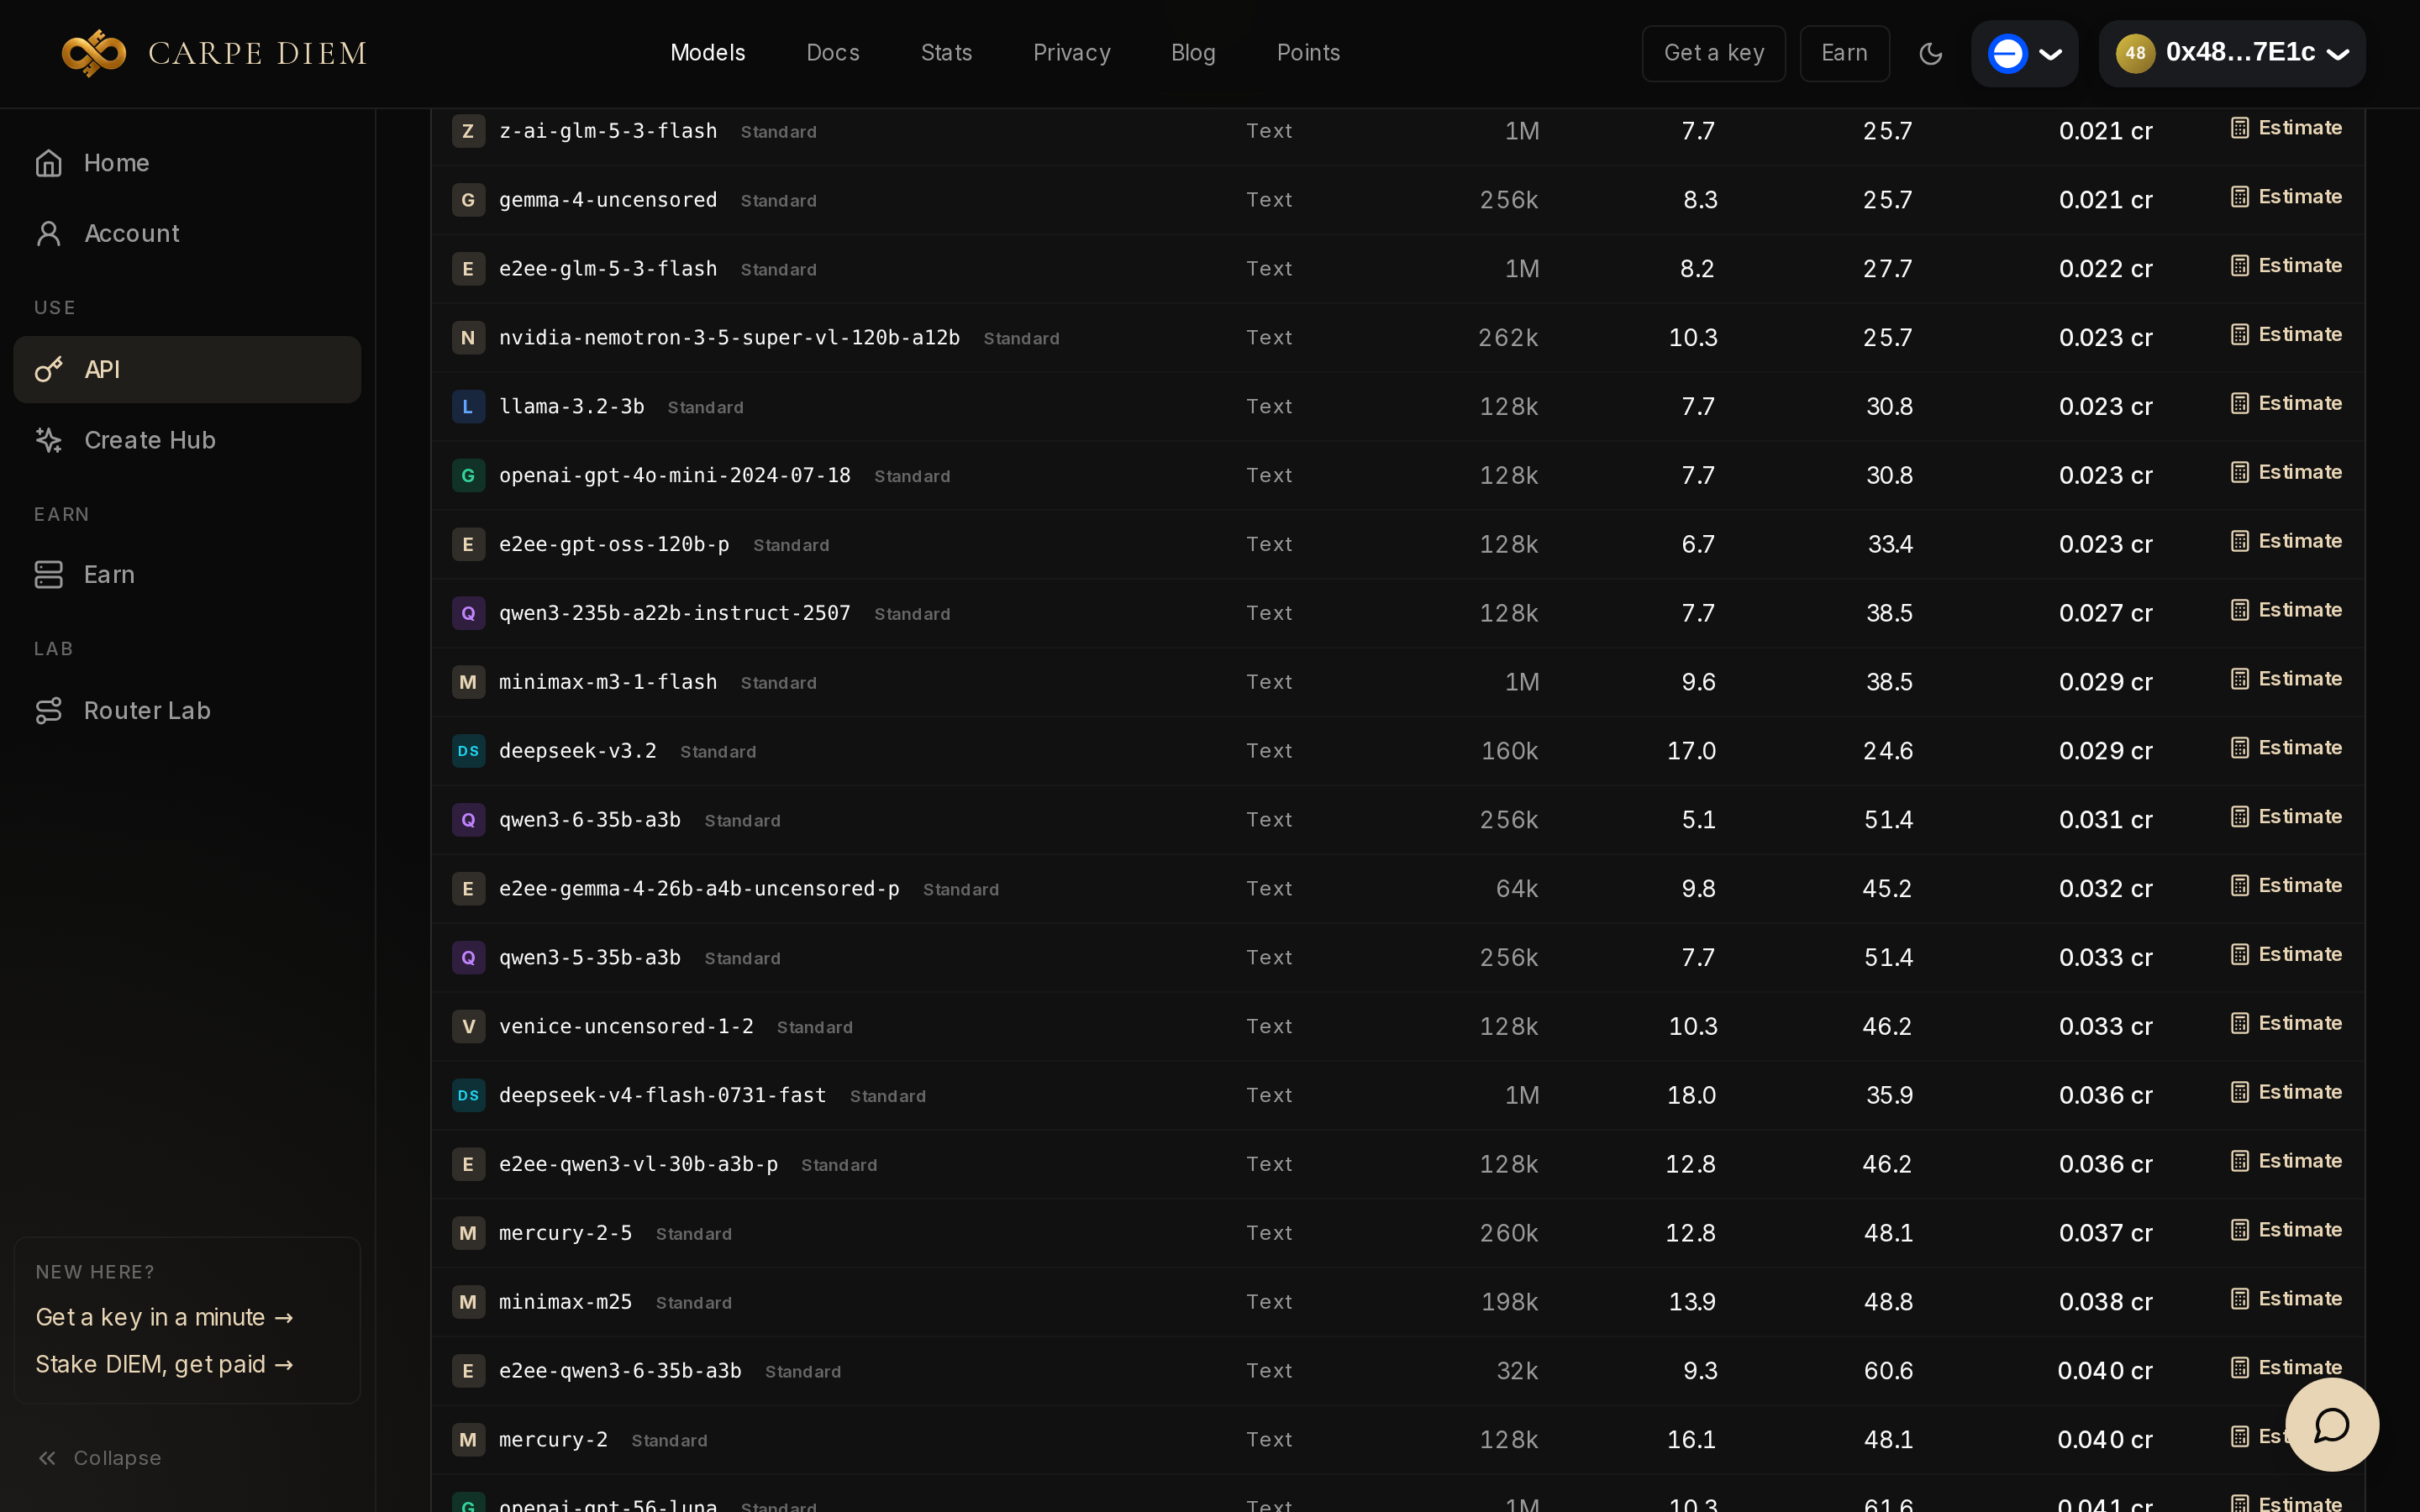
Die Ansicht Table listet Kennung, Typ, Kontext, Ein- und Ausgabepreis in Credits pro Million und die Kosten einer typischen Anfrage auf (1000 Tokens rein, 500 raus).
Was Sie wissen sollten, bevor Sie sich darauf stützen
Der Schätzer nimmt nur token-tarifierte Modelle. Ein Bildmodell hat keinen Knopf Estimate: ein Token-Korb sagt nichts über eine Generierung. Der Filter Image zeigt einen Preis Per image oder Per edit, zum Beispiel 0,51 Credit für lustify-sdxl und 1,54 Credit für flux-2-pro.
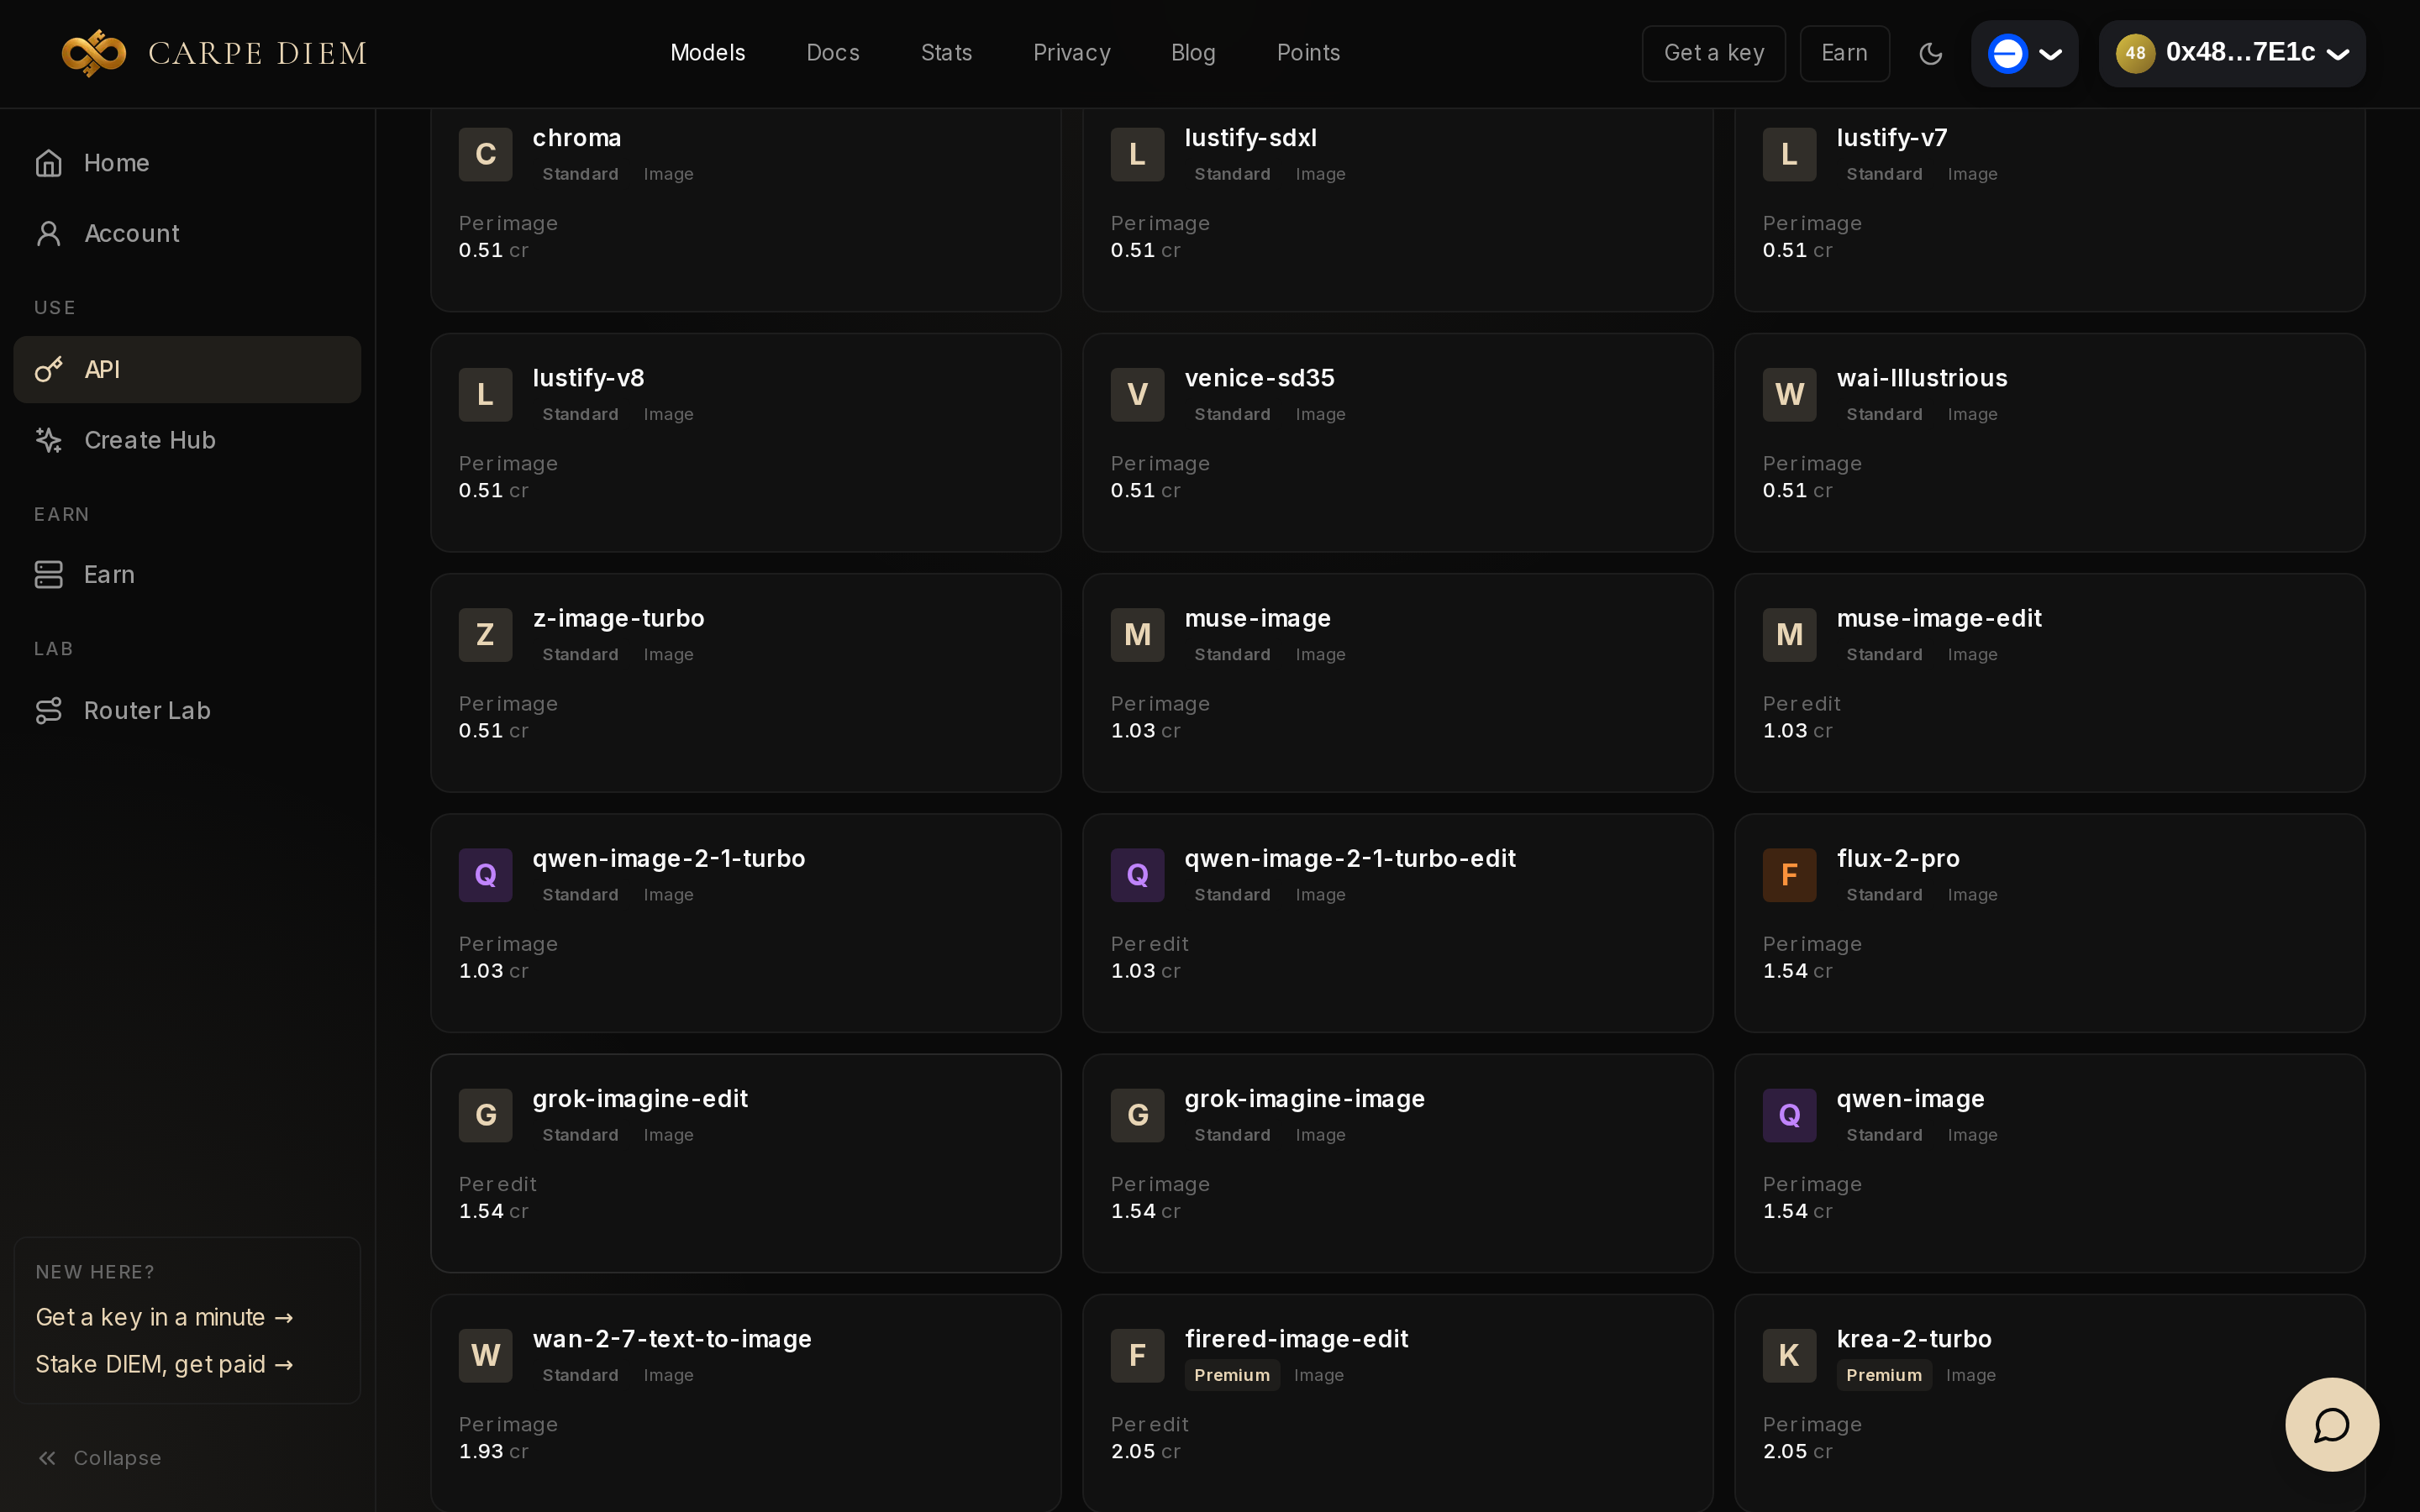
Um ein Bild oder ein Video zu testen, gehen Sie über den Create Hub.
Märkte bewegen sich, und eine Anfrage nimmt den günstigsten unter denen, die sie bedienen können, wenn sie losläuft. Auf einem nicht angemeldeten Konto zeigt die Seite die Marktnotierung und sagt, dass das echte Routing erst nach der Anmeldung sichtbar ist; wir waren angemeldet.
Für kurze, häufige Aufrufe setzen Sie venice_parameters.include_venice_system_prompt: false: Sie zahlen den System-Prompt von Venice nicht, etwa 1 700 Tokens pro Aufruf. Die /v1-Zeile des Schätzers zählt ihn bereits, daher die Abweichung von einer naiven Rechnung über die Million-Preise im Raster.
Was es kostet
Die Rasterpreise stehen in Credits pro Million Tokens (1 Credit = 0,01 $). Der Schätzer rechnet sie in Dollar pro Anfrage, pro Tag und pro Monat um, aber das ist keine Quittung: der abgerechnete Betrag eines echten Aufrufs steht im Antwortkopf oder im Hub. Um danach einen Schlüssel cdm_ anzuschließen, liefern das OpenAI Python SDK und der Versuch Kimi K3.1 Pro die base_url.
Methode: Test vom 8. November 2026, angemeldetes Konto, ein Lauf; Bild-, Sprach- und Musikmodelle wurden nicht geschätzt.
Öffnen Sie Model pricing, starten Sie Estimate a workload für Ihre drei Kandidaten, und schreiben Sie die base_url erst danach.