Comparar precios de modelos de IA: catálogo y estimación
Comparar los precios de los modelos de IA suele empezar por la tarifa del proveedor, como en BenchLM. La página Model pricing de Carpe Diem muestra el precio en vivo del marketplace, filtros por uso y un estimador de carga: hasta 3 modelos, con el coste de una petición tipo en /v1 y en /router. La página es pública: no hace falta un wallet para leer los precios.
Lo que muestra Model pricing
El banner avisa: es « the live rate, not a rate card ». Las tarifas se mueven con la demanda y con lo que encuentra el enrutado. En el momento de nuestra prueba, la página anunciaba un 49 % por debajo de la tarifa lista de Venice. Para llama-3.3-70b, el millón de tokens de entrada / salida estaba a 0,36 $ / 1,44 $ en Carpe Diem, frente a 0,70 $ / 2,80 $ en Venice.
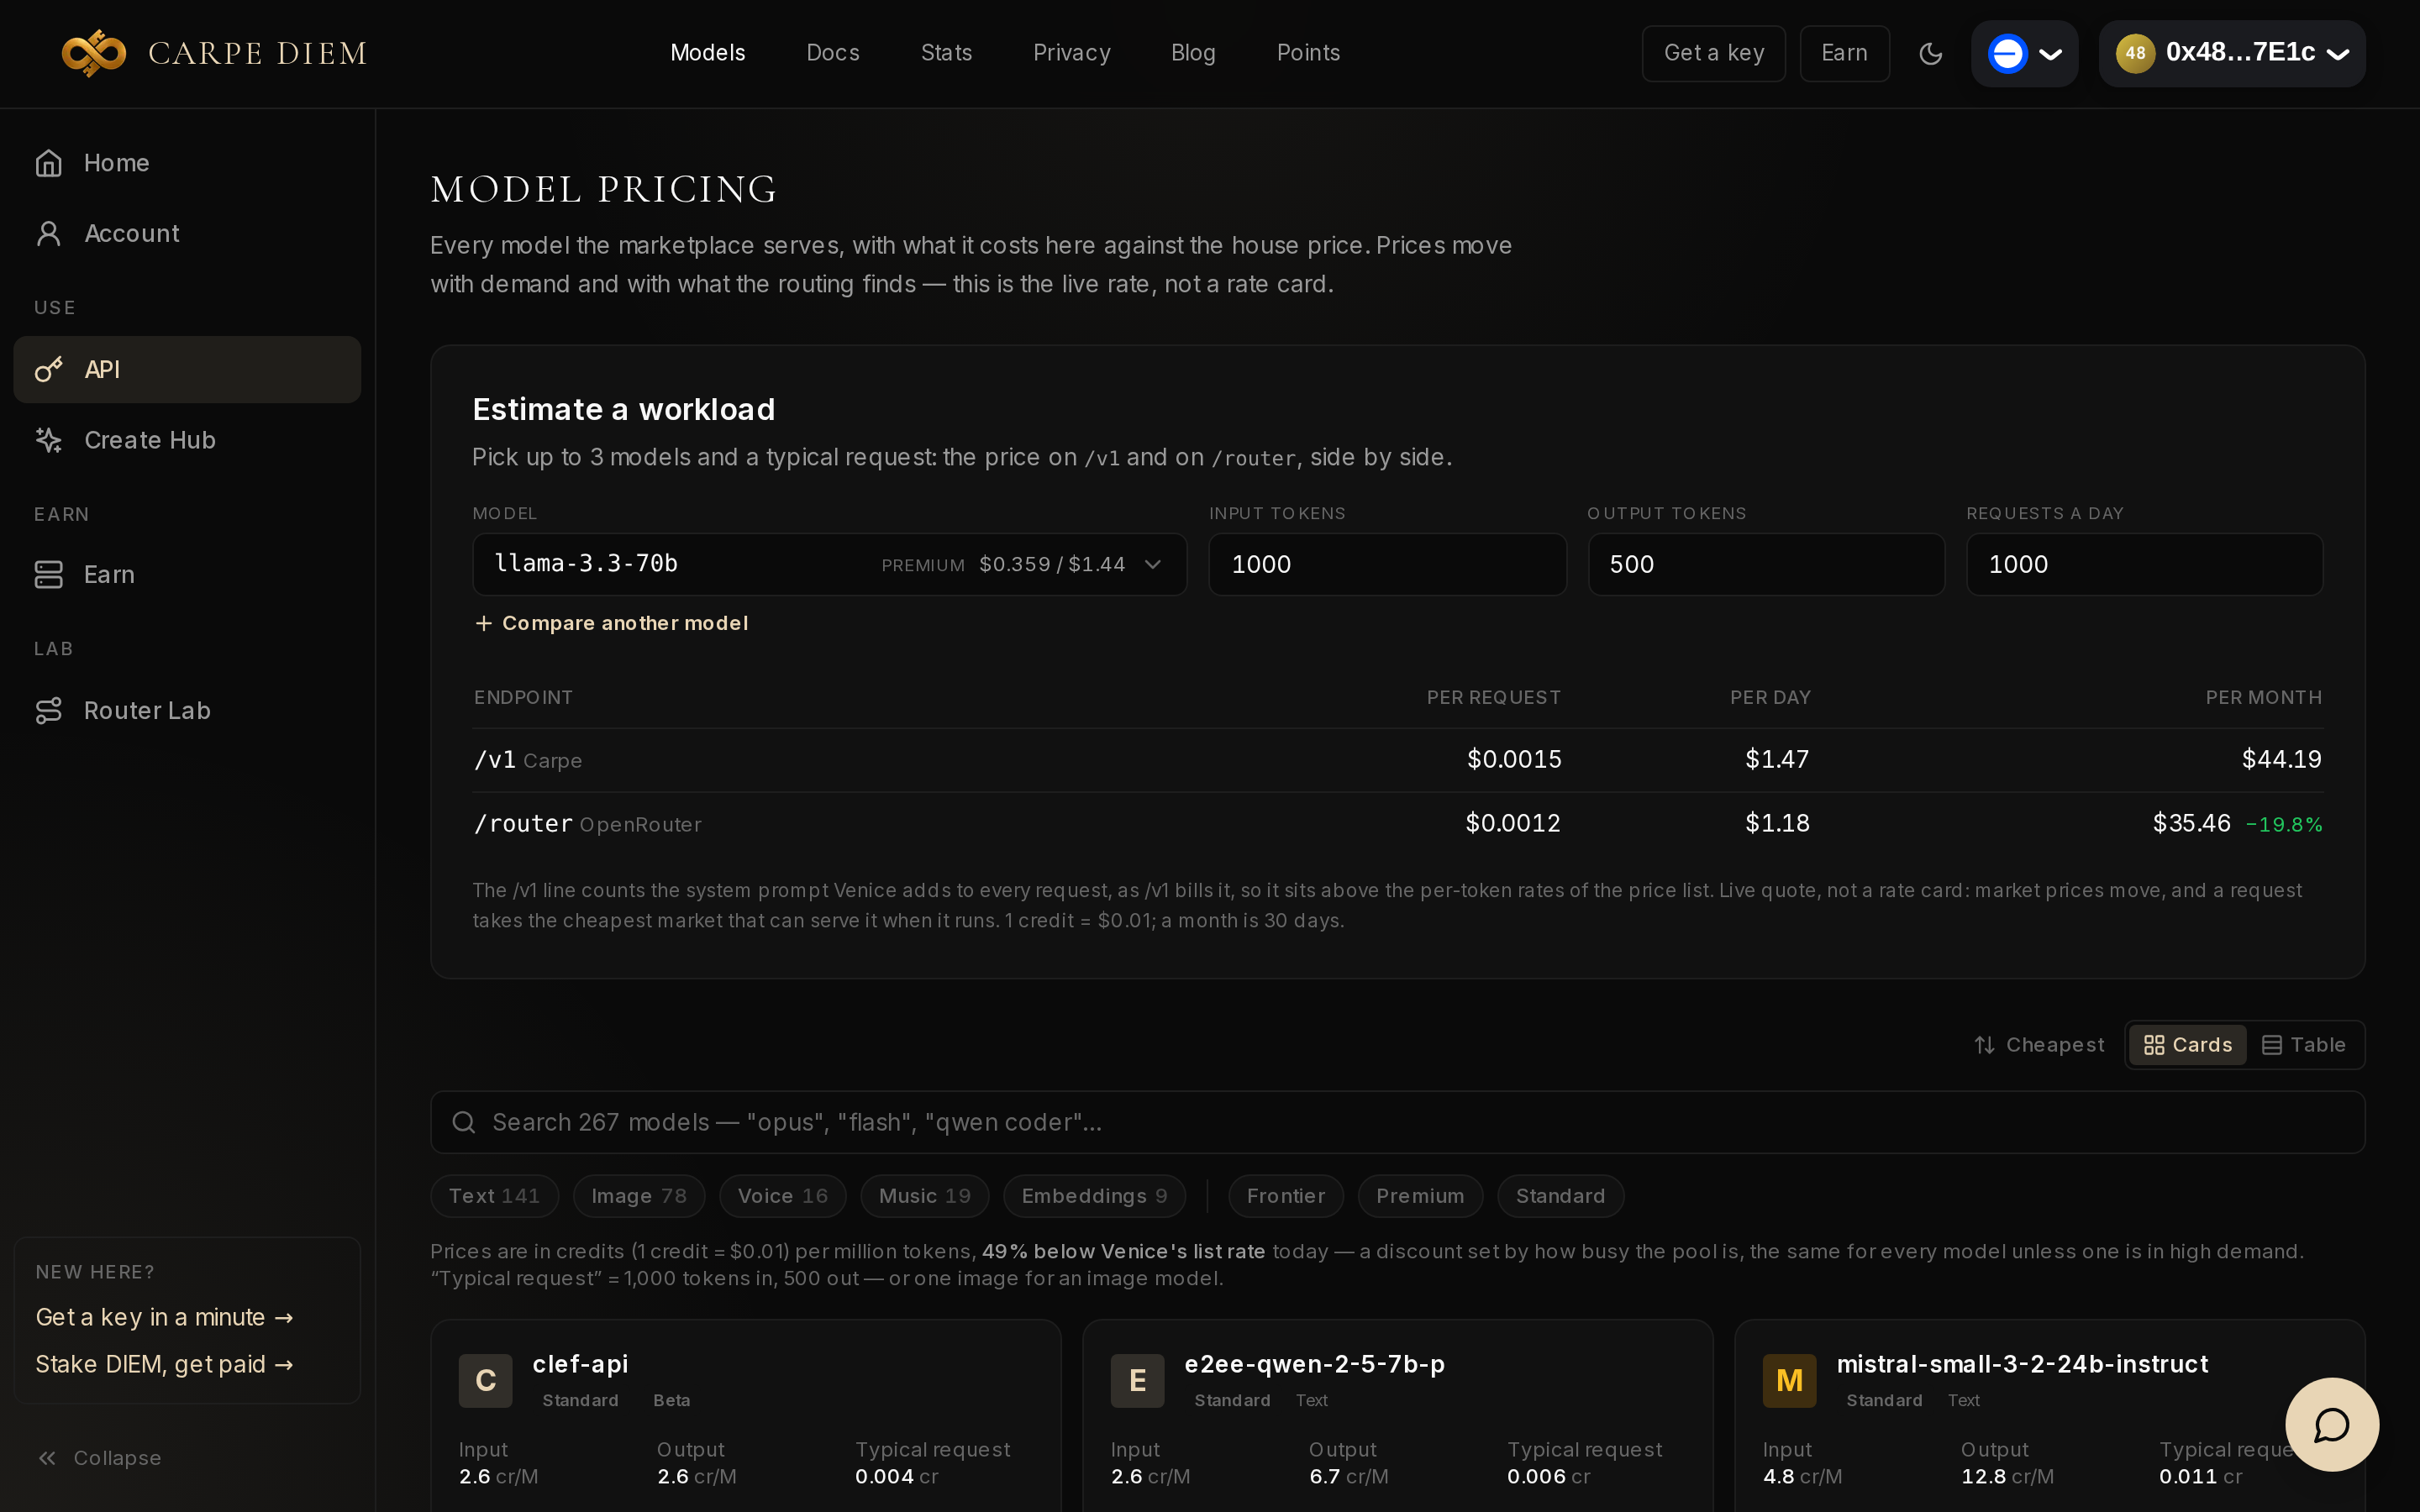
El bloque Estimate a workload viene rellenado: llama-3.3-70b, 1000 tokens de entrada, 500 de salida, 1000 peticiones al día. Para esa carga, /v1 mostraba 0,0015 $ por petición (44,19 $ al mes) y /router, que había elegido OpenRouter, 0,0012 $ (35,46 $ al mes, −19,8 %). Una nota indica que un mes son 30 días y que la línea /v1 incluye el prompt de sistema de Venice, facturado con la llamada.
Debajo del bloque, la cuadrícula se abre en tarjetas, ordenadas de más barato a más caro. Unas pastillas filtran por uso (texto, imagen, voz, música, embeddings) o por gama, y un botón pasa a la vista Table. El campo de búsqueda cubre el catálogo entero, 267 modelos aquel día.
Tres modelos, una misma carga
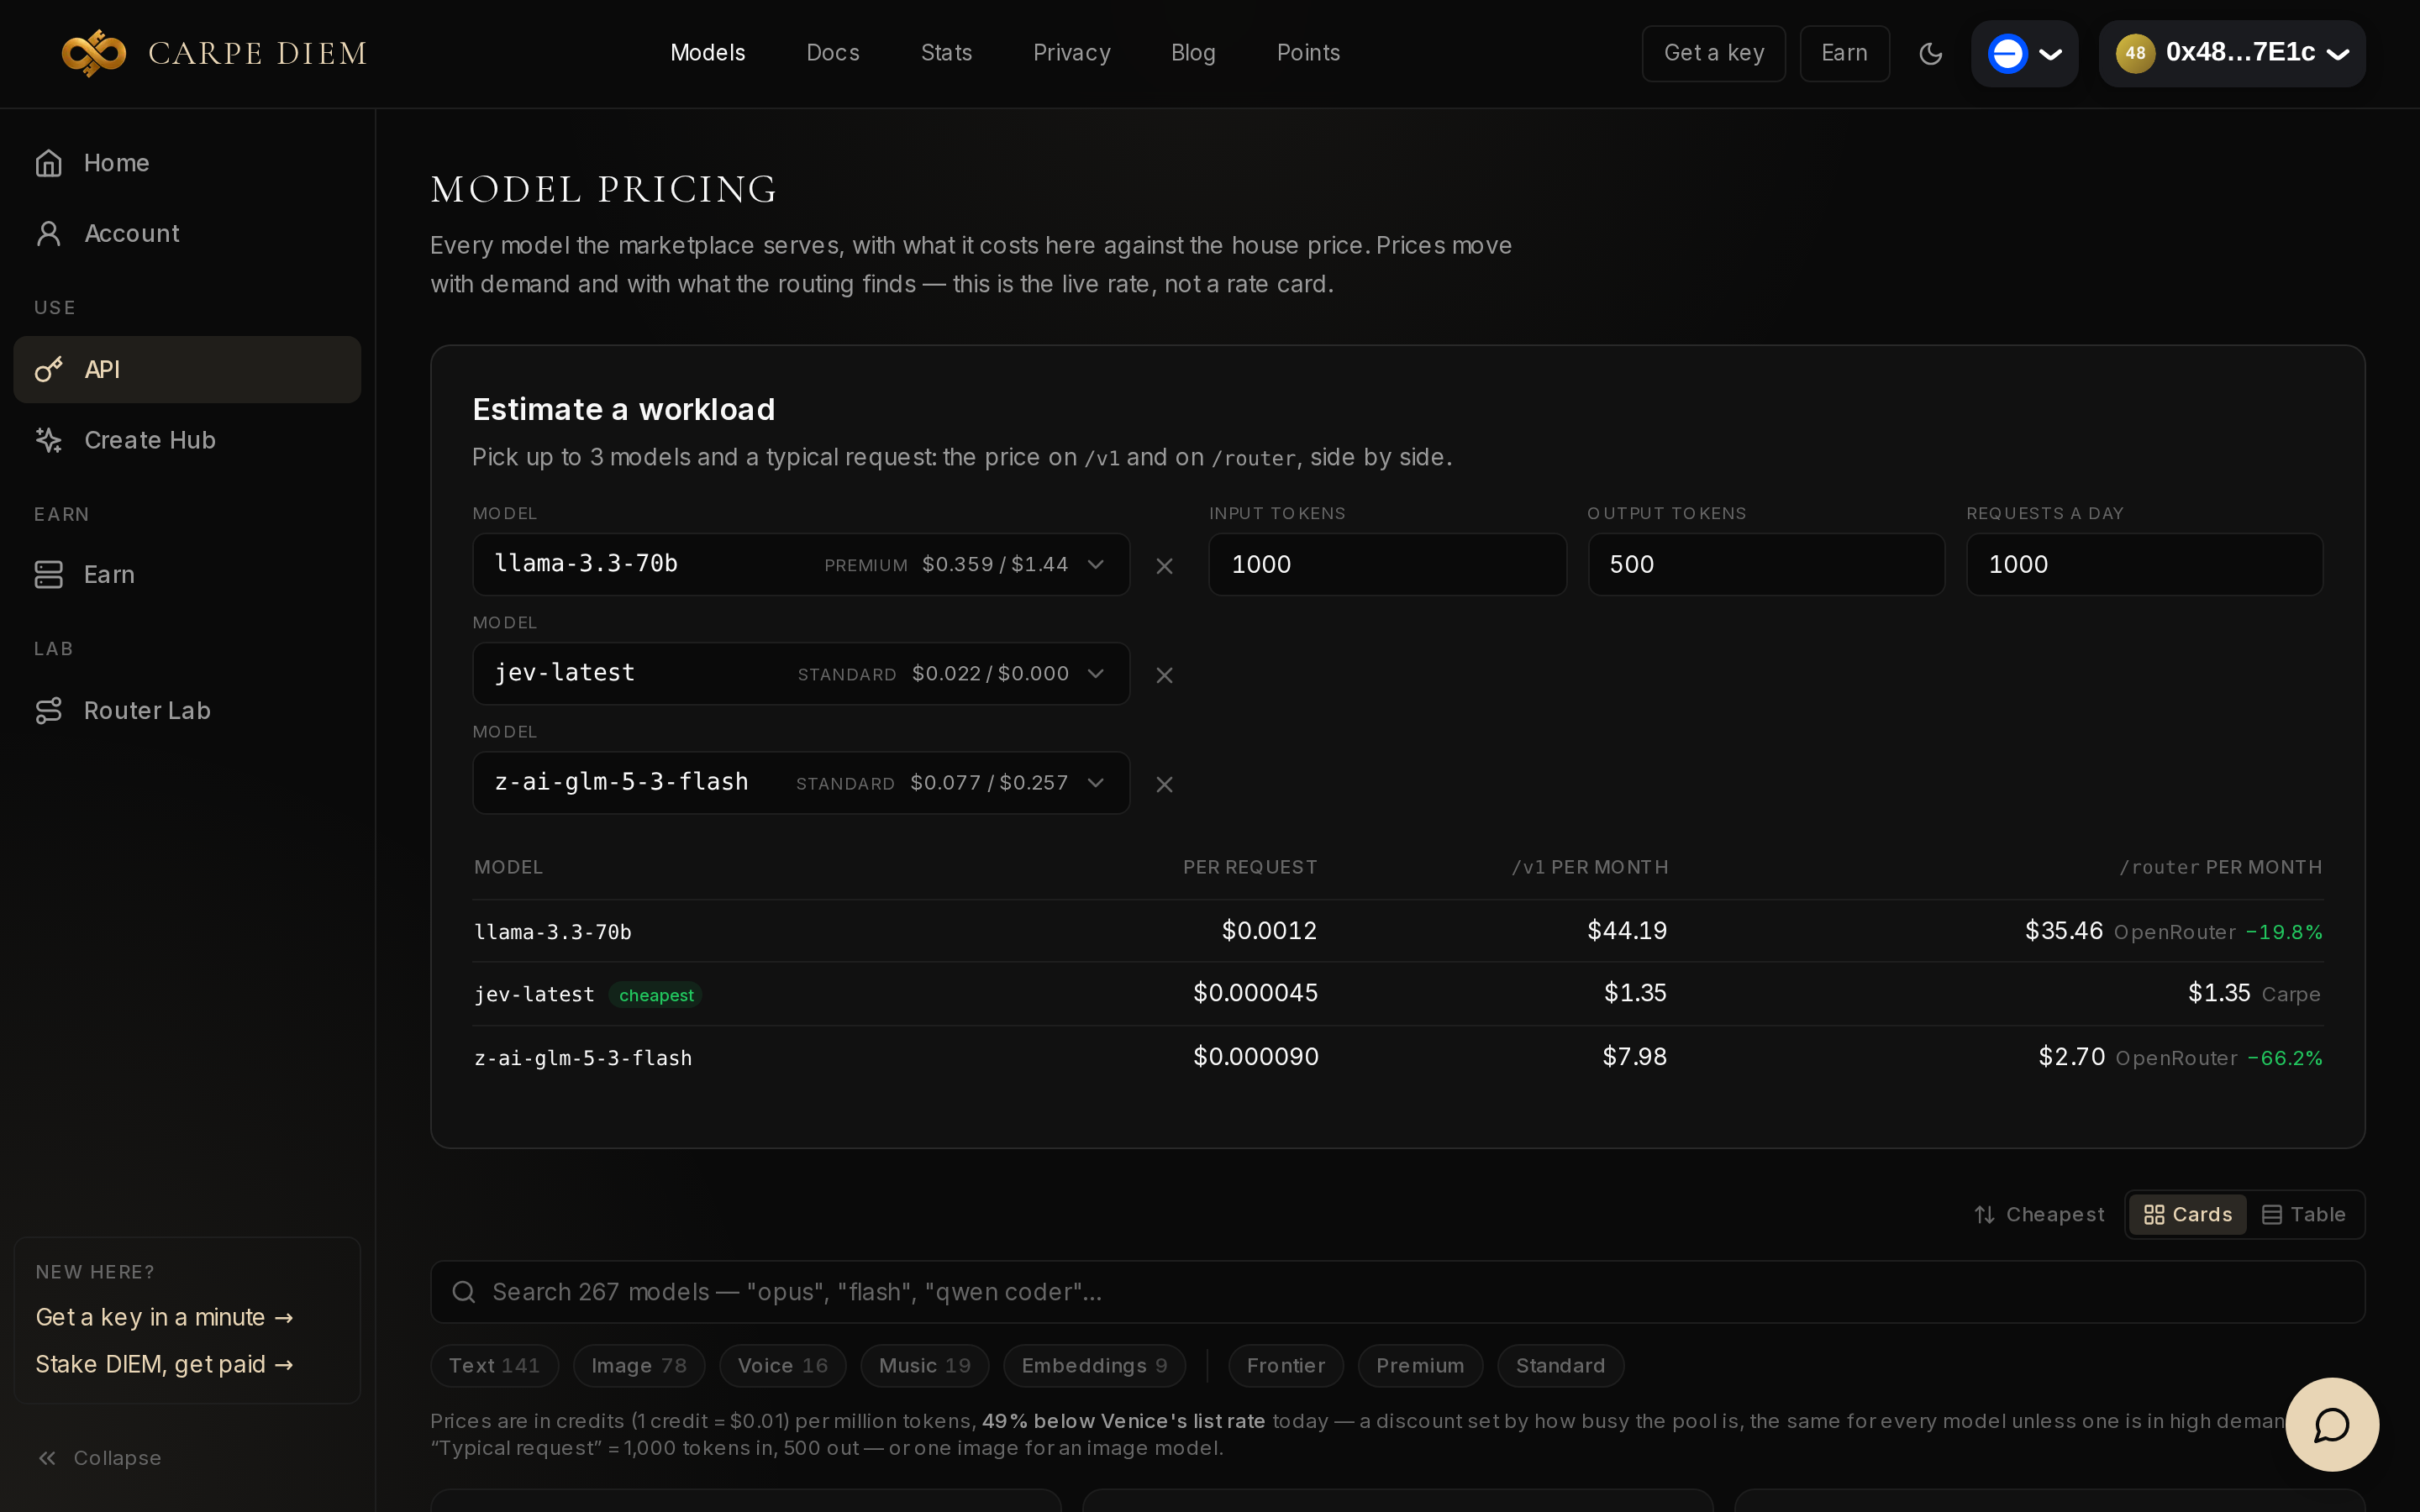
Mantuvimos la cesta por defecto y pulsamos dos veces Compare another model. La interfaz añadió jev-latest y luego z-ai-glm-5-3-flash. La tabla pasa a una fila por modelo.
| Modelo | /v1 al mes |
/router al mes |
|---|---|---|
llama-3.3-70b |
44,19 $ | 35,46 $ (OpenRouter) |
jev-latest (cheapest) |
1,35 $ | 1,35 $ (mercado Carpe) |
z-ai-glm-5-3-flash |
7,98 $ | 2,70 $ (OpenRouter) |
El distintivo cheapest señala el mes más barato entre las columnas mostradas, no el mejor modelo para su tarea. La diferencia de /router depende del modelo: −19,8 % en Llama, −66,2 % en GLM Flash, nada en jev-latest, ya servido al mejor precio por Carpe.
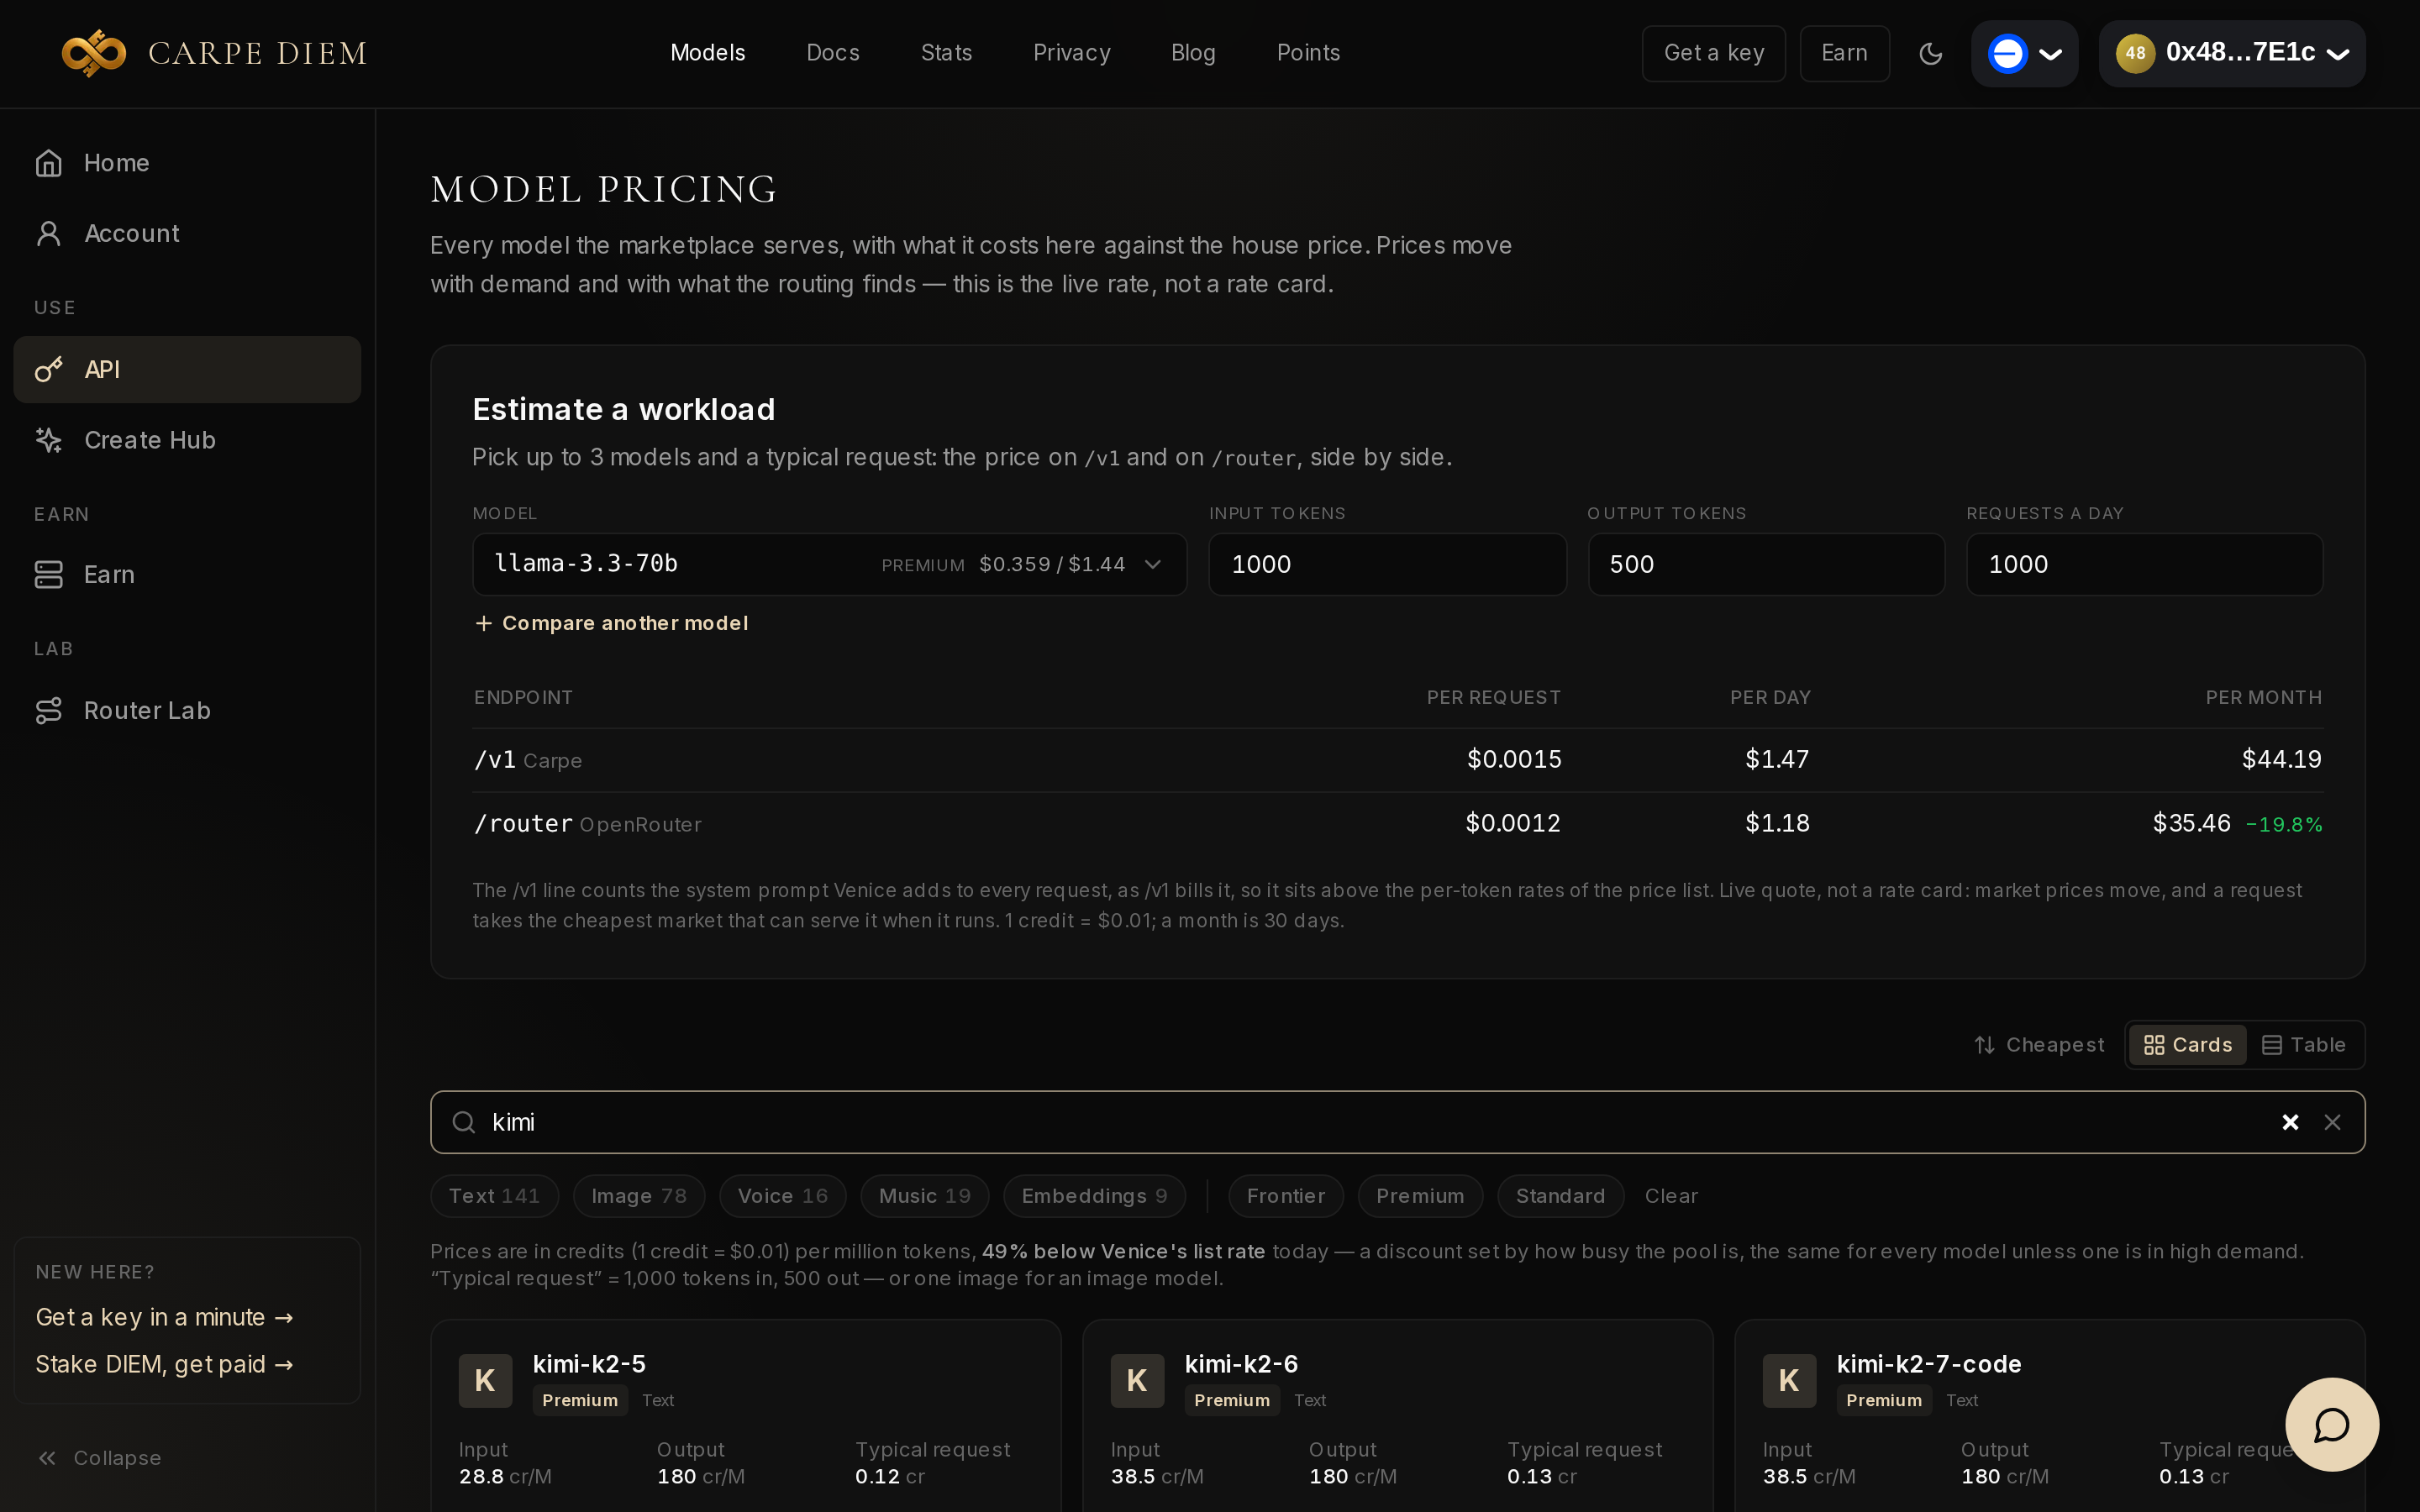
Para apuntar a un modelo concreto, la búsqueda funciona por palabras: « kimi » lista kimi-k2-5, kimi-k2-6 y kimi-k2-7-code. El botón Estimate de una tarjeta de texto lo añade al bloque de arriba, con un tope de 3.
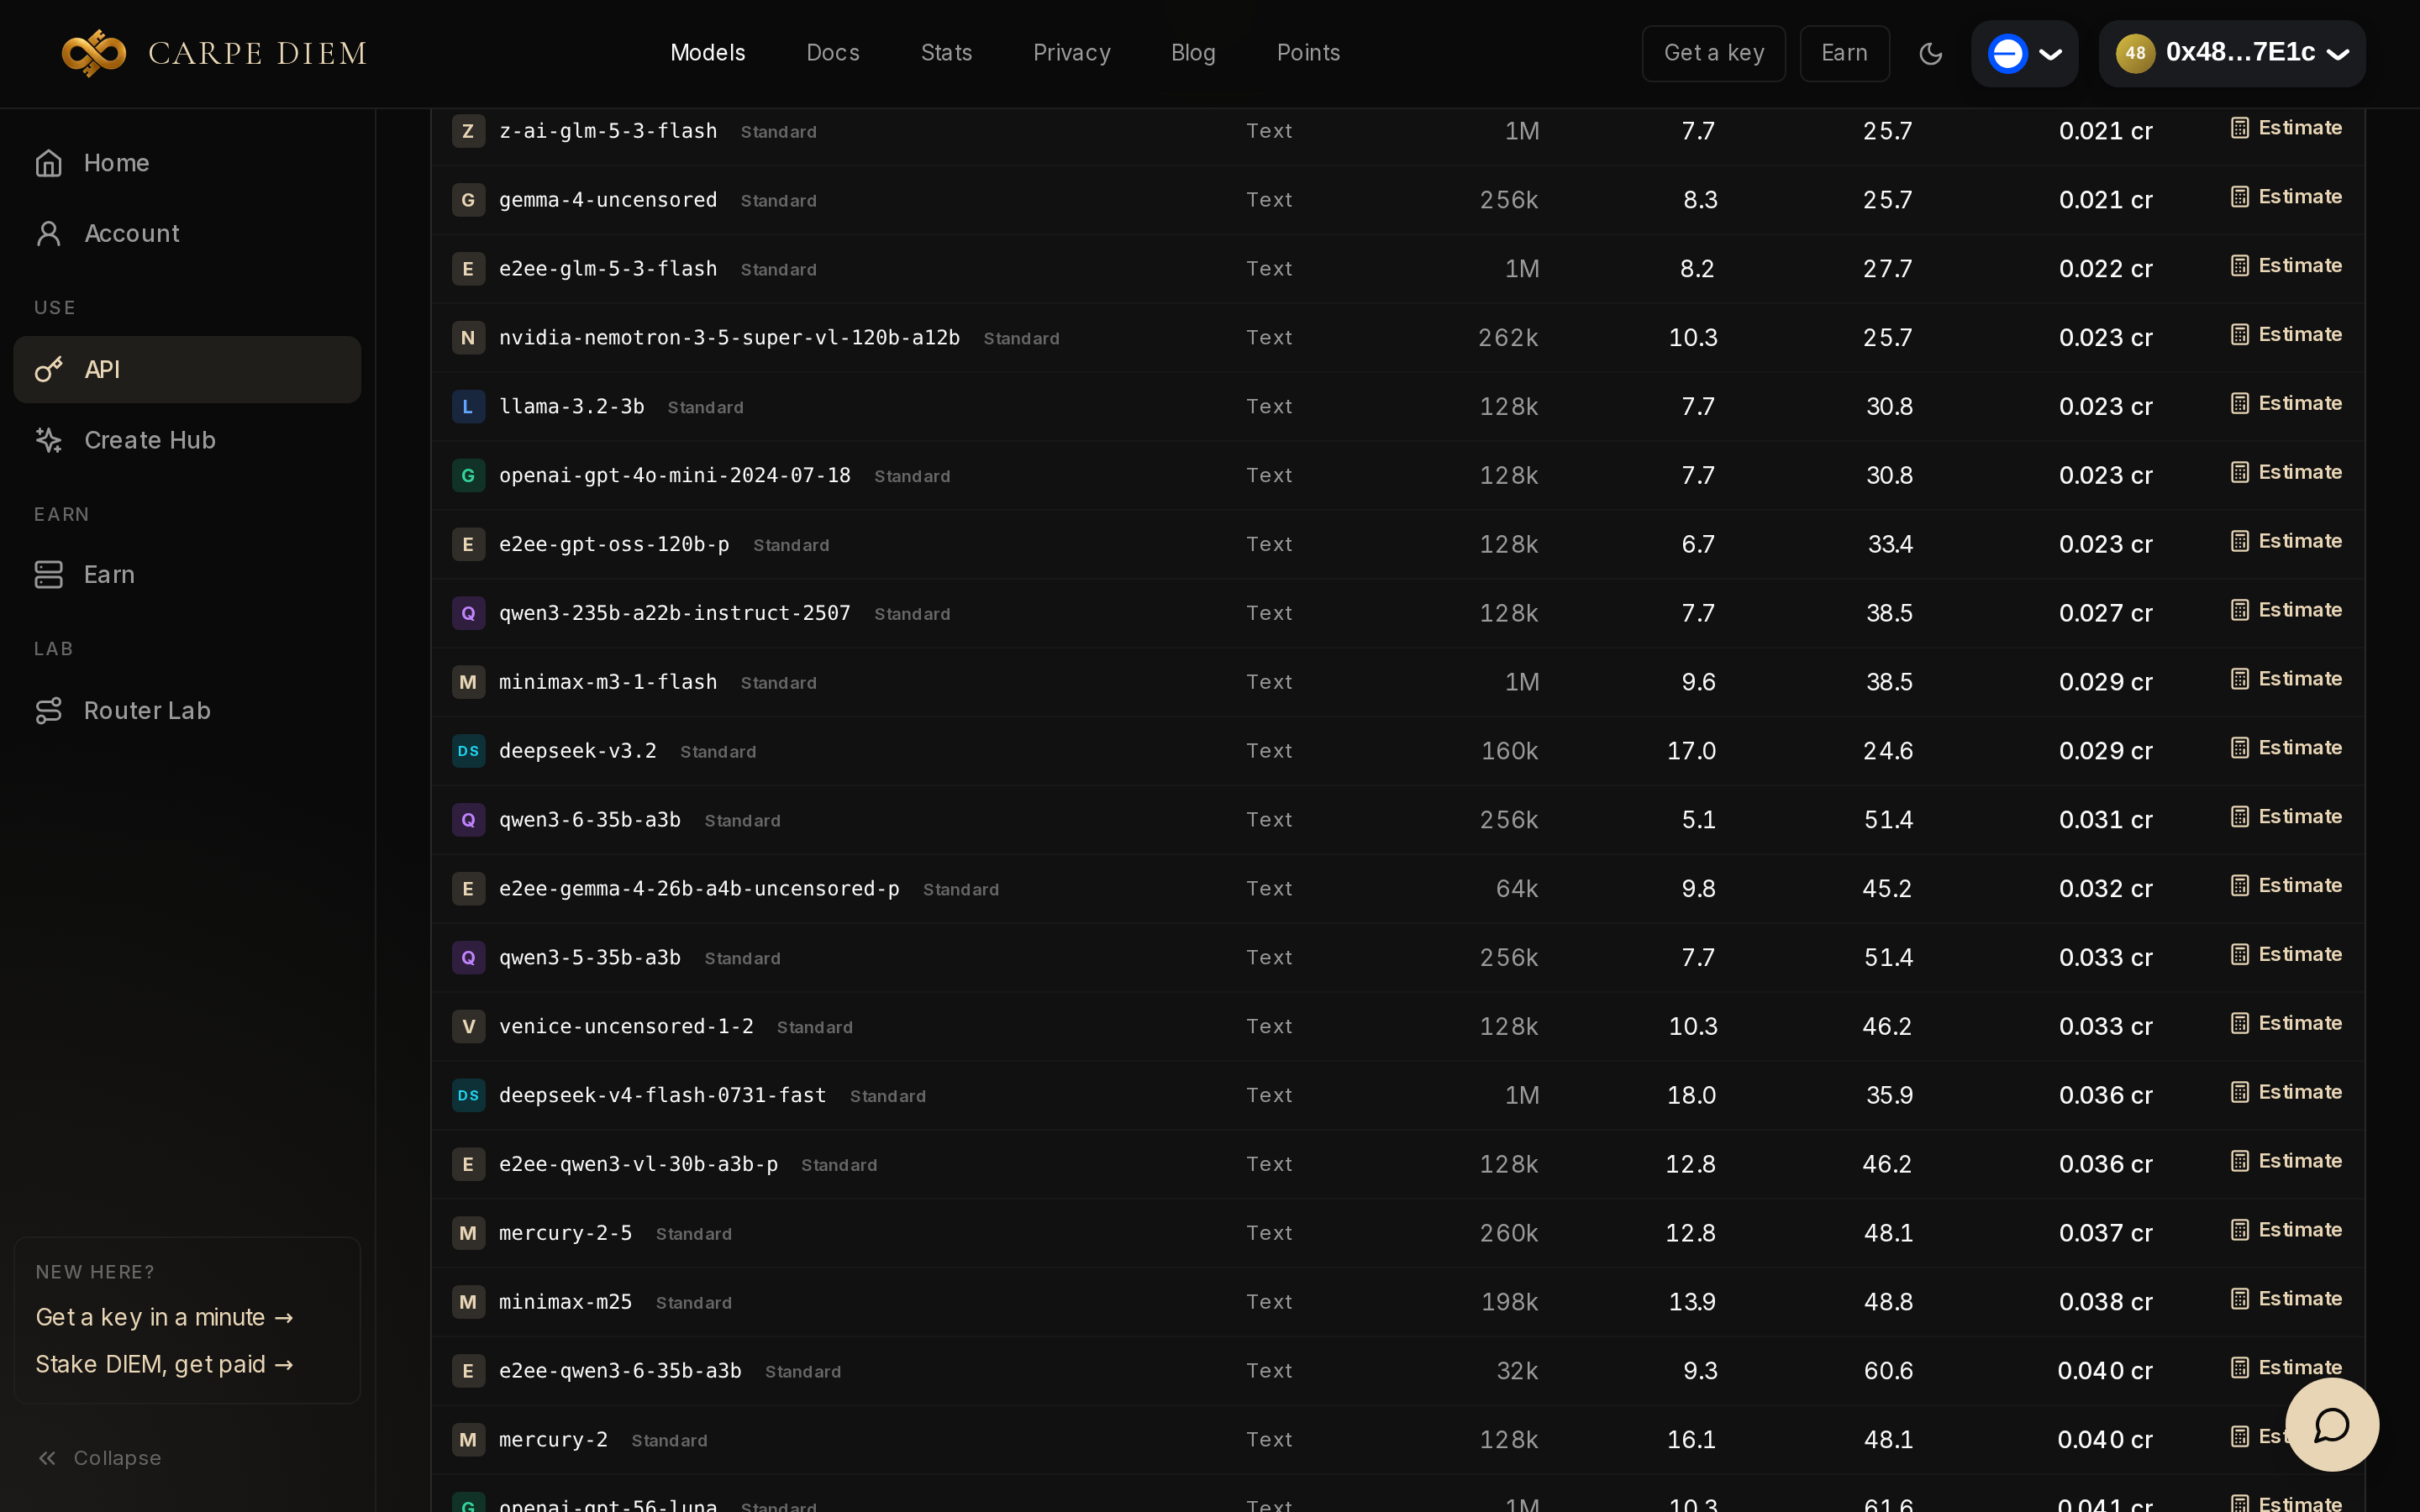
La vista Table alinea identificador, tipo, contexto, precios de entrada y salida en créditos por millón, y el coste de una petición tipo (1000 tokens de entrada, 500 de salida).
Qué hay que saber antes de fiarse
El estimador solo acepta modelos tarifados por token. Un modelo de imagen no tiene botón Estimate: una cesta de tokens no dice nada de una generación. El filtro Image muestra un precio Per image o Per edit, por ejemplo 0,51 crédito para lustify-sdxl y 1,54 crédito para flux-2-pro.
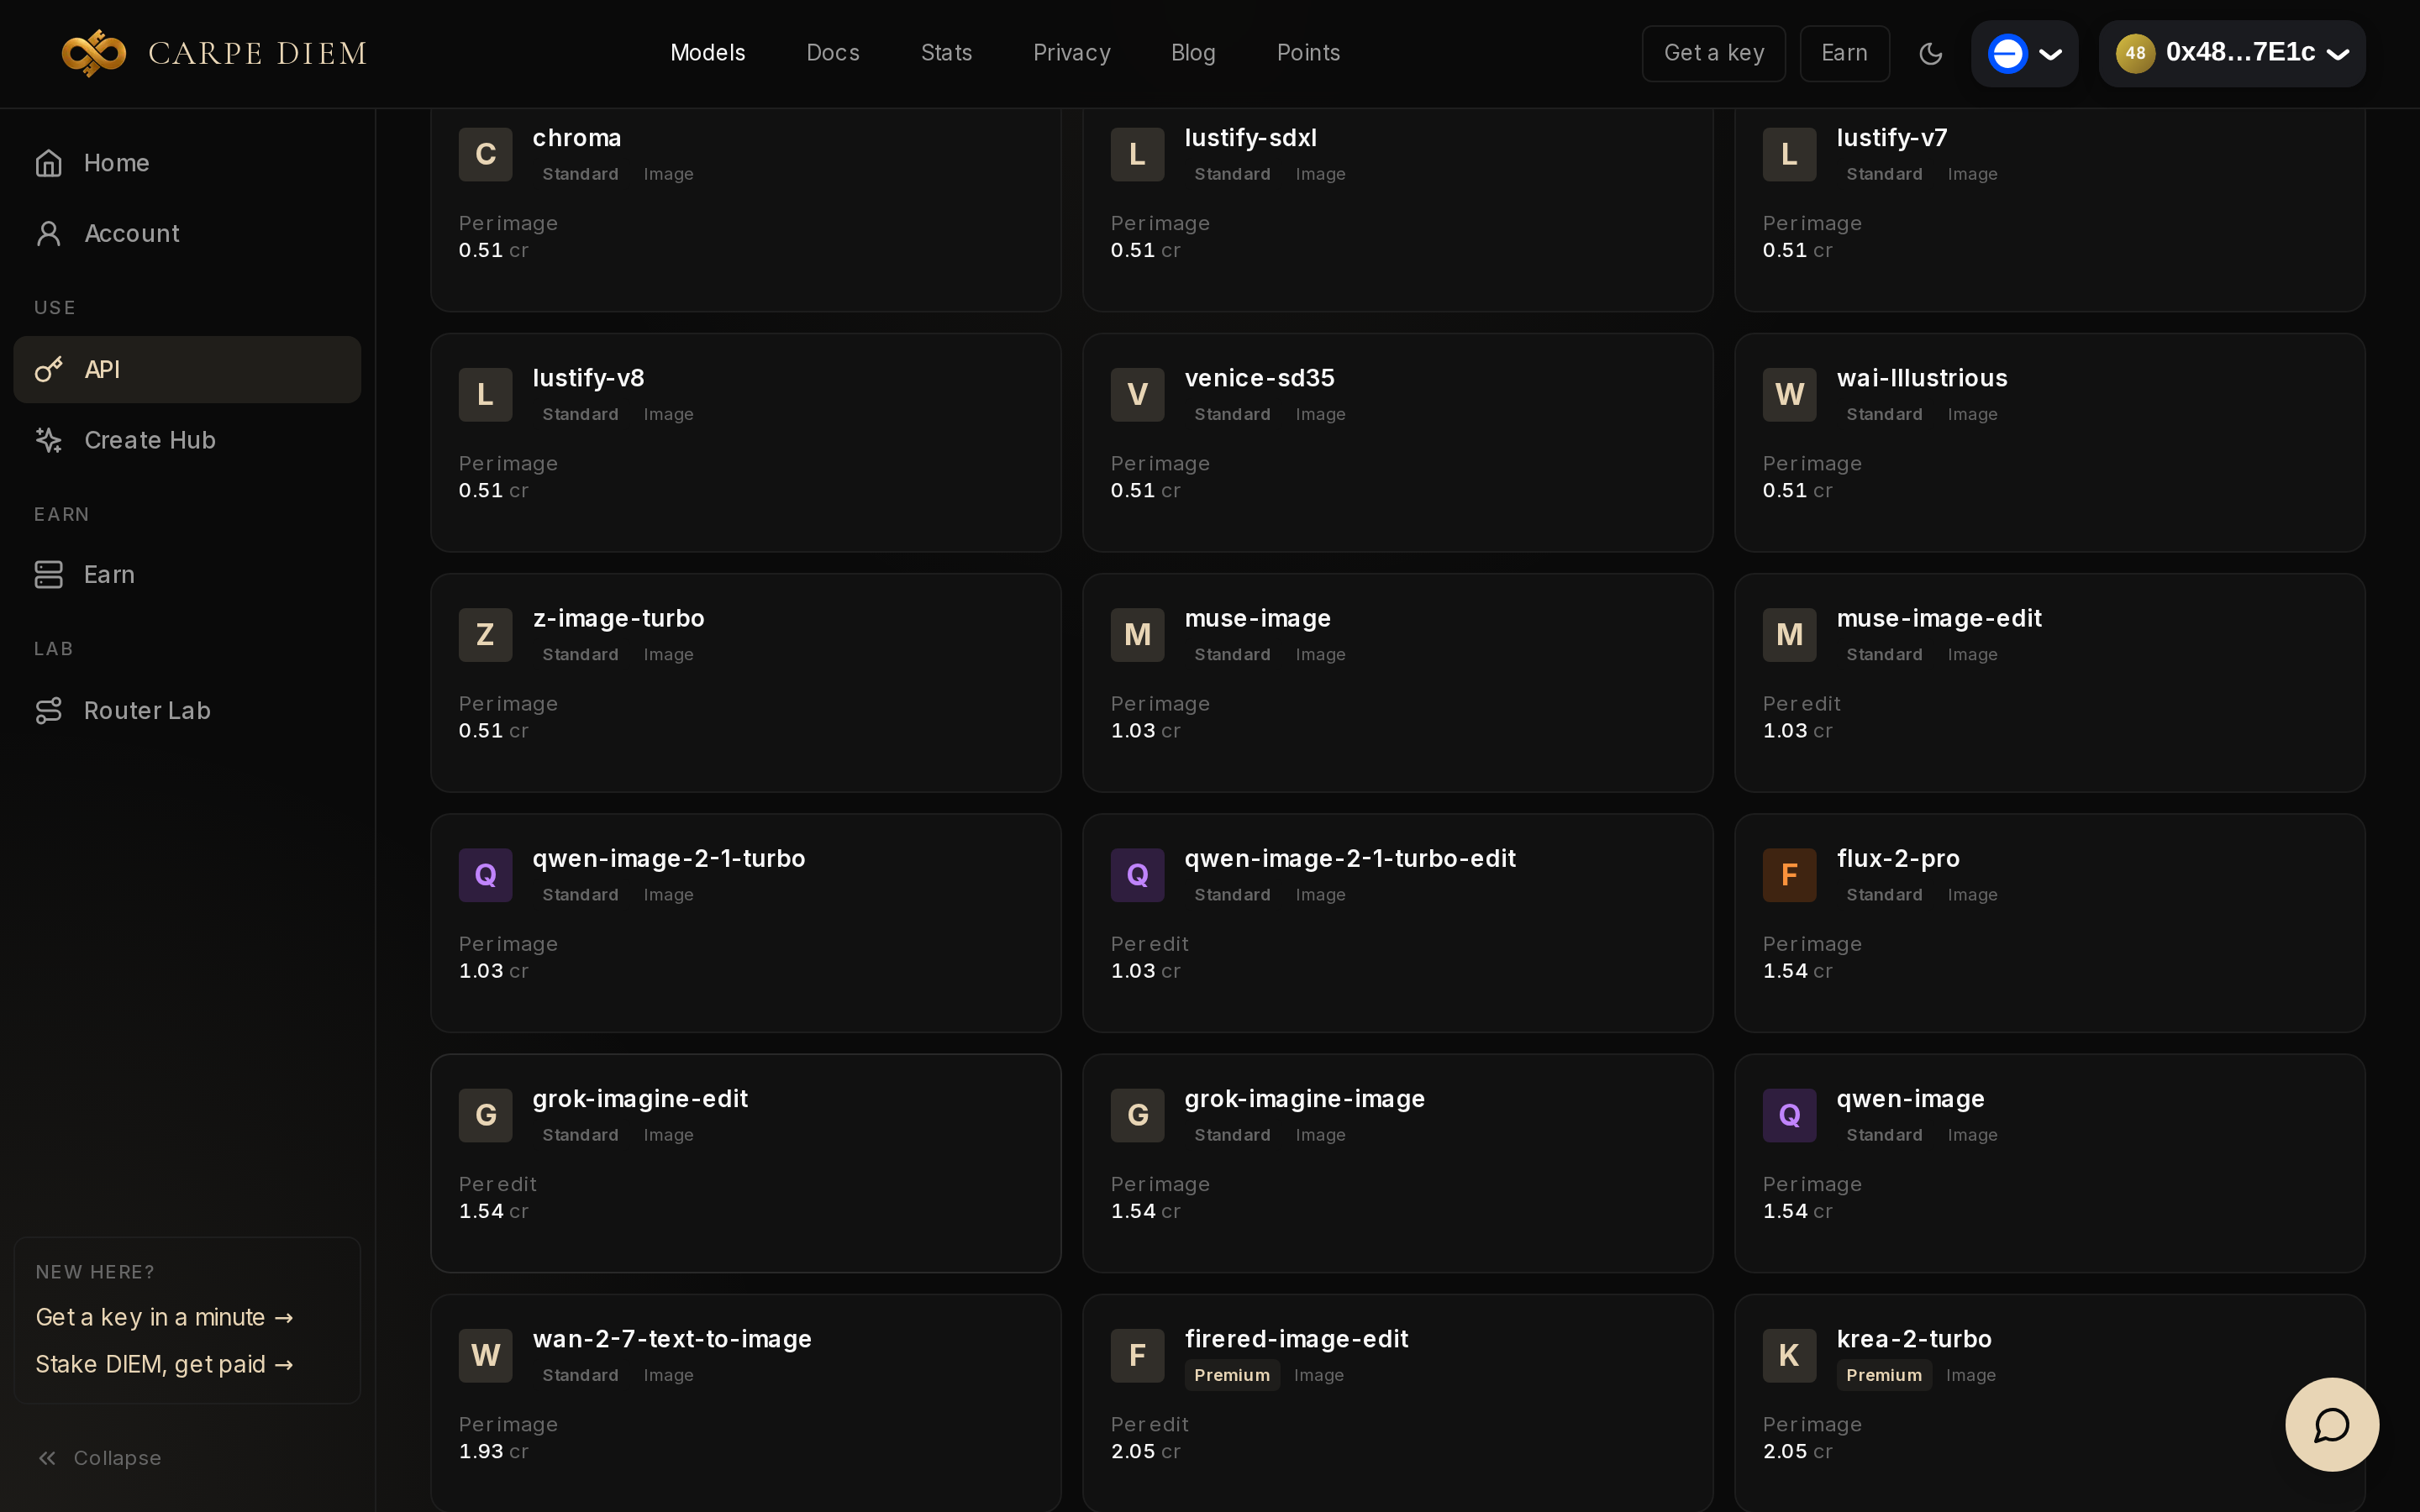
Para probar una imagen o un vídeo, pase por el Create Hub.
Los mercados se mueven, y una petición toma el más barato de los que pueden servirla en el momento en que sale. En una cuenta no conectada, la página muestra la cotización de los mercados y aclara que el enrutado real se ve al conectar; nosotros estábamos conectados.
Para llamadas cortas y numerosas, añada venice_parameters.include_venice_system_prompt: false: no pagará el prompt de sistema de Venice, unos 1 700 tokens por llamada. La línea /v1 del estimador ya lo cuenta, de ahí el desfase con un cálculo ingenuo sobre los precios por millón de la cuadrícula.
Cuánto cuesta
Los precios de la cuadrícula están en créditos por millón de tokens (1 crédito = 0,01 $). El estimador los convierte en dólares por petición, por día y por mes, pero no es un recibo: el importe facturado de una llamada real es el de la cabecera de respuesta o del Hub. Para enchufar después una clave cdm_, el SDK OpenAI Python y la prueba Kimi K3.1 Pro dan el base_url.
Procedimiento: prueba del 8 de noviembre de 2026, cuenta conectada, una sola ejecución ; los modelos de imagen, voz y música no se estimaron.
Abra Model pricing, lance Estimate a workload sobre sus tres candidatos, y no codee el base_url hasta después.