Comparar preços de modelos de IA: catálogo e estimativa
Comparar os preços dos modelos de IA começa muitas vezes pela tarifa do fornecedor, como no BenchLM. A página Model pricing da Carpe Diem mostra o preço em tempo real do marketplace, filtros por uso e um estimador de carga: até 3 modelos, com o custo de um pedido típico em /v1 e em /router. A página é pública: não precisa de wallet para ler os preços.
O que o Model pricing mostra
O banner avisa: é « the live rate, not a rate card ». As tarifas mexem com a procura e com o que o encaminhamento encontra. No momento do nosso ensaio, a página anunciava 49 % abaixo da tarifa de lista da Venice. Para llama-3.3-70b, o milhão de tokens de entrada / saída estava a 0,36 $ / 1,44 $ na Carpe Diem, contra 0,70 $ / 2,80 $ na Venice.
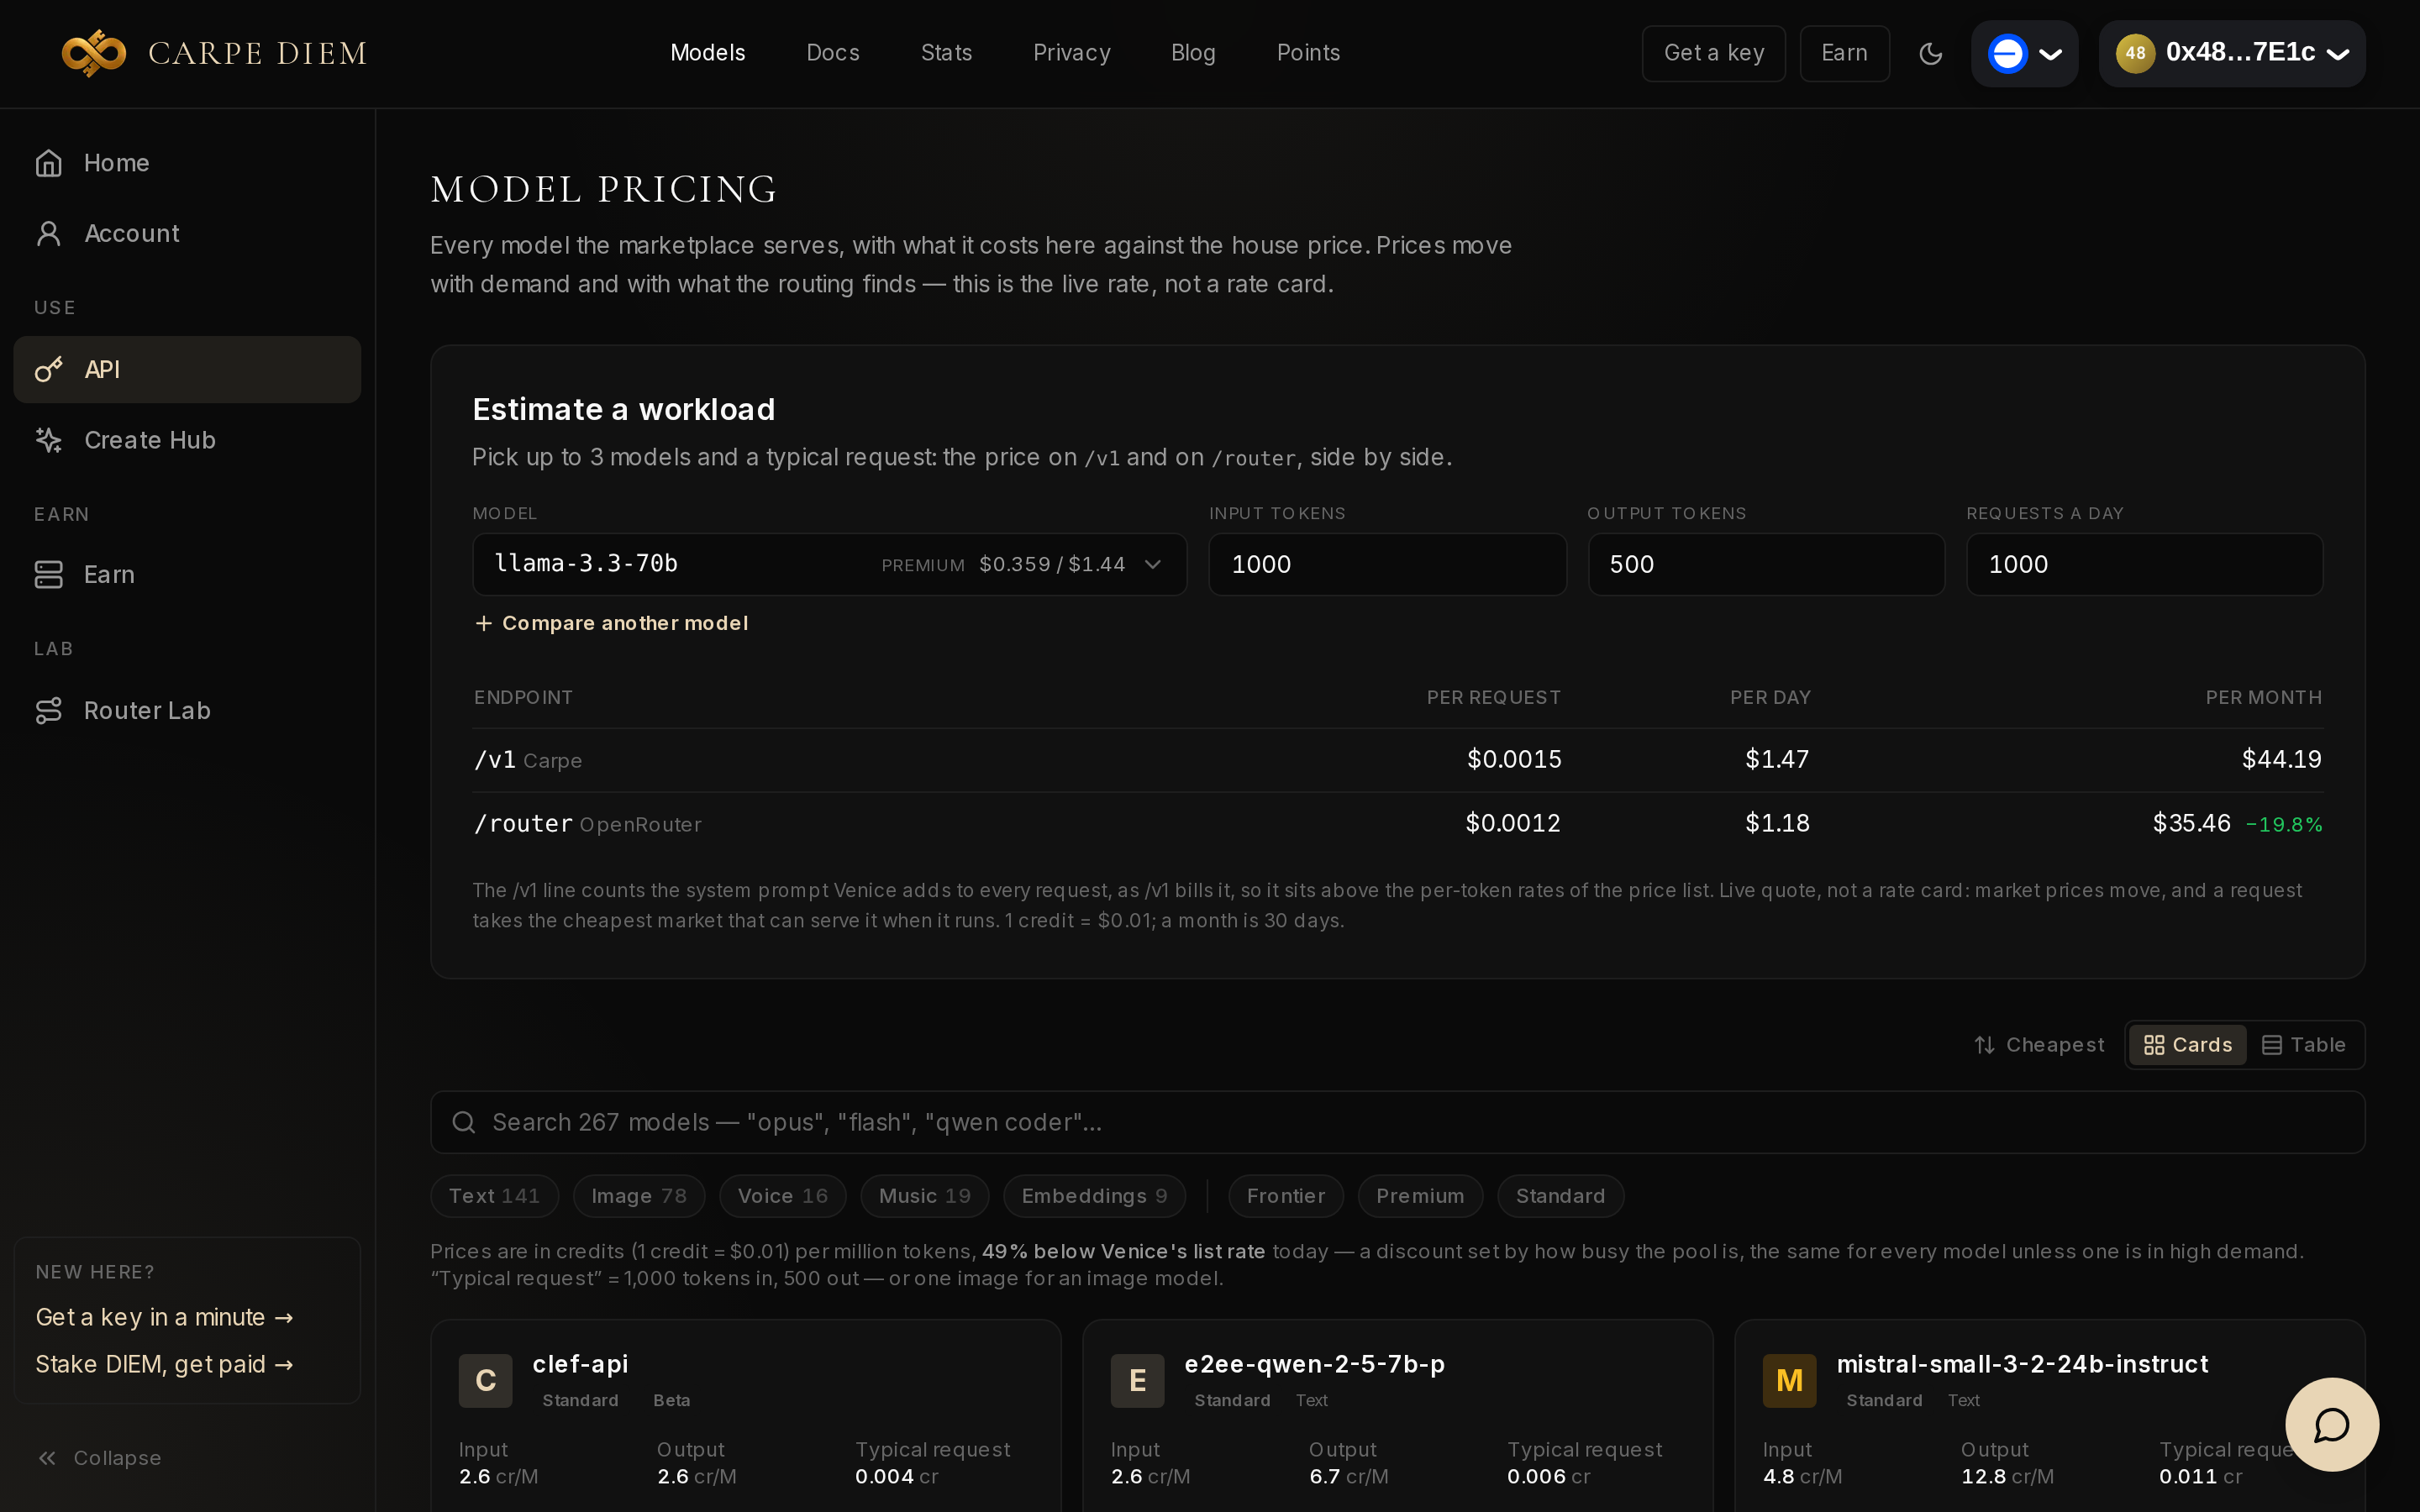
O bloco Estimate a workload vem preenchido: llama-3.3-70b, 1000 tokens de entrada, 500 de saída, 1000 pedidos por dia. Para essa carga, /v1 mostrava 0,0015 $ por pedido (44,19 $ por mês) e /router, que tinha escolhido OpenRouter, 0,0012 $ (35,46 $ por mês, −19,8 %). Uma nota diz que um mês conta 30 dias e que a linha /v1 inclui o prompt de sistema da Venice, faturado com o pedido.
Abaixo do bloco, a grelha abre-se em cartões, ordenados do mais barato ao mais caro. Pastilhas filtram por uso (texto, imagem, voz, música, embeddings) ou por gama, e um botão passa à vista Table. O campo de pesquisa cobre o catálogo inteiro, 267 modelos nesse dia.
Três modelos, a mesma carga
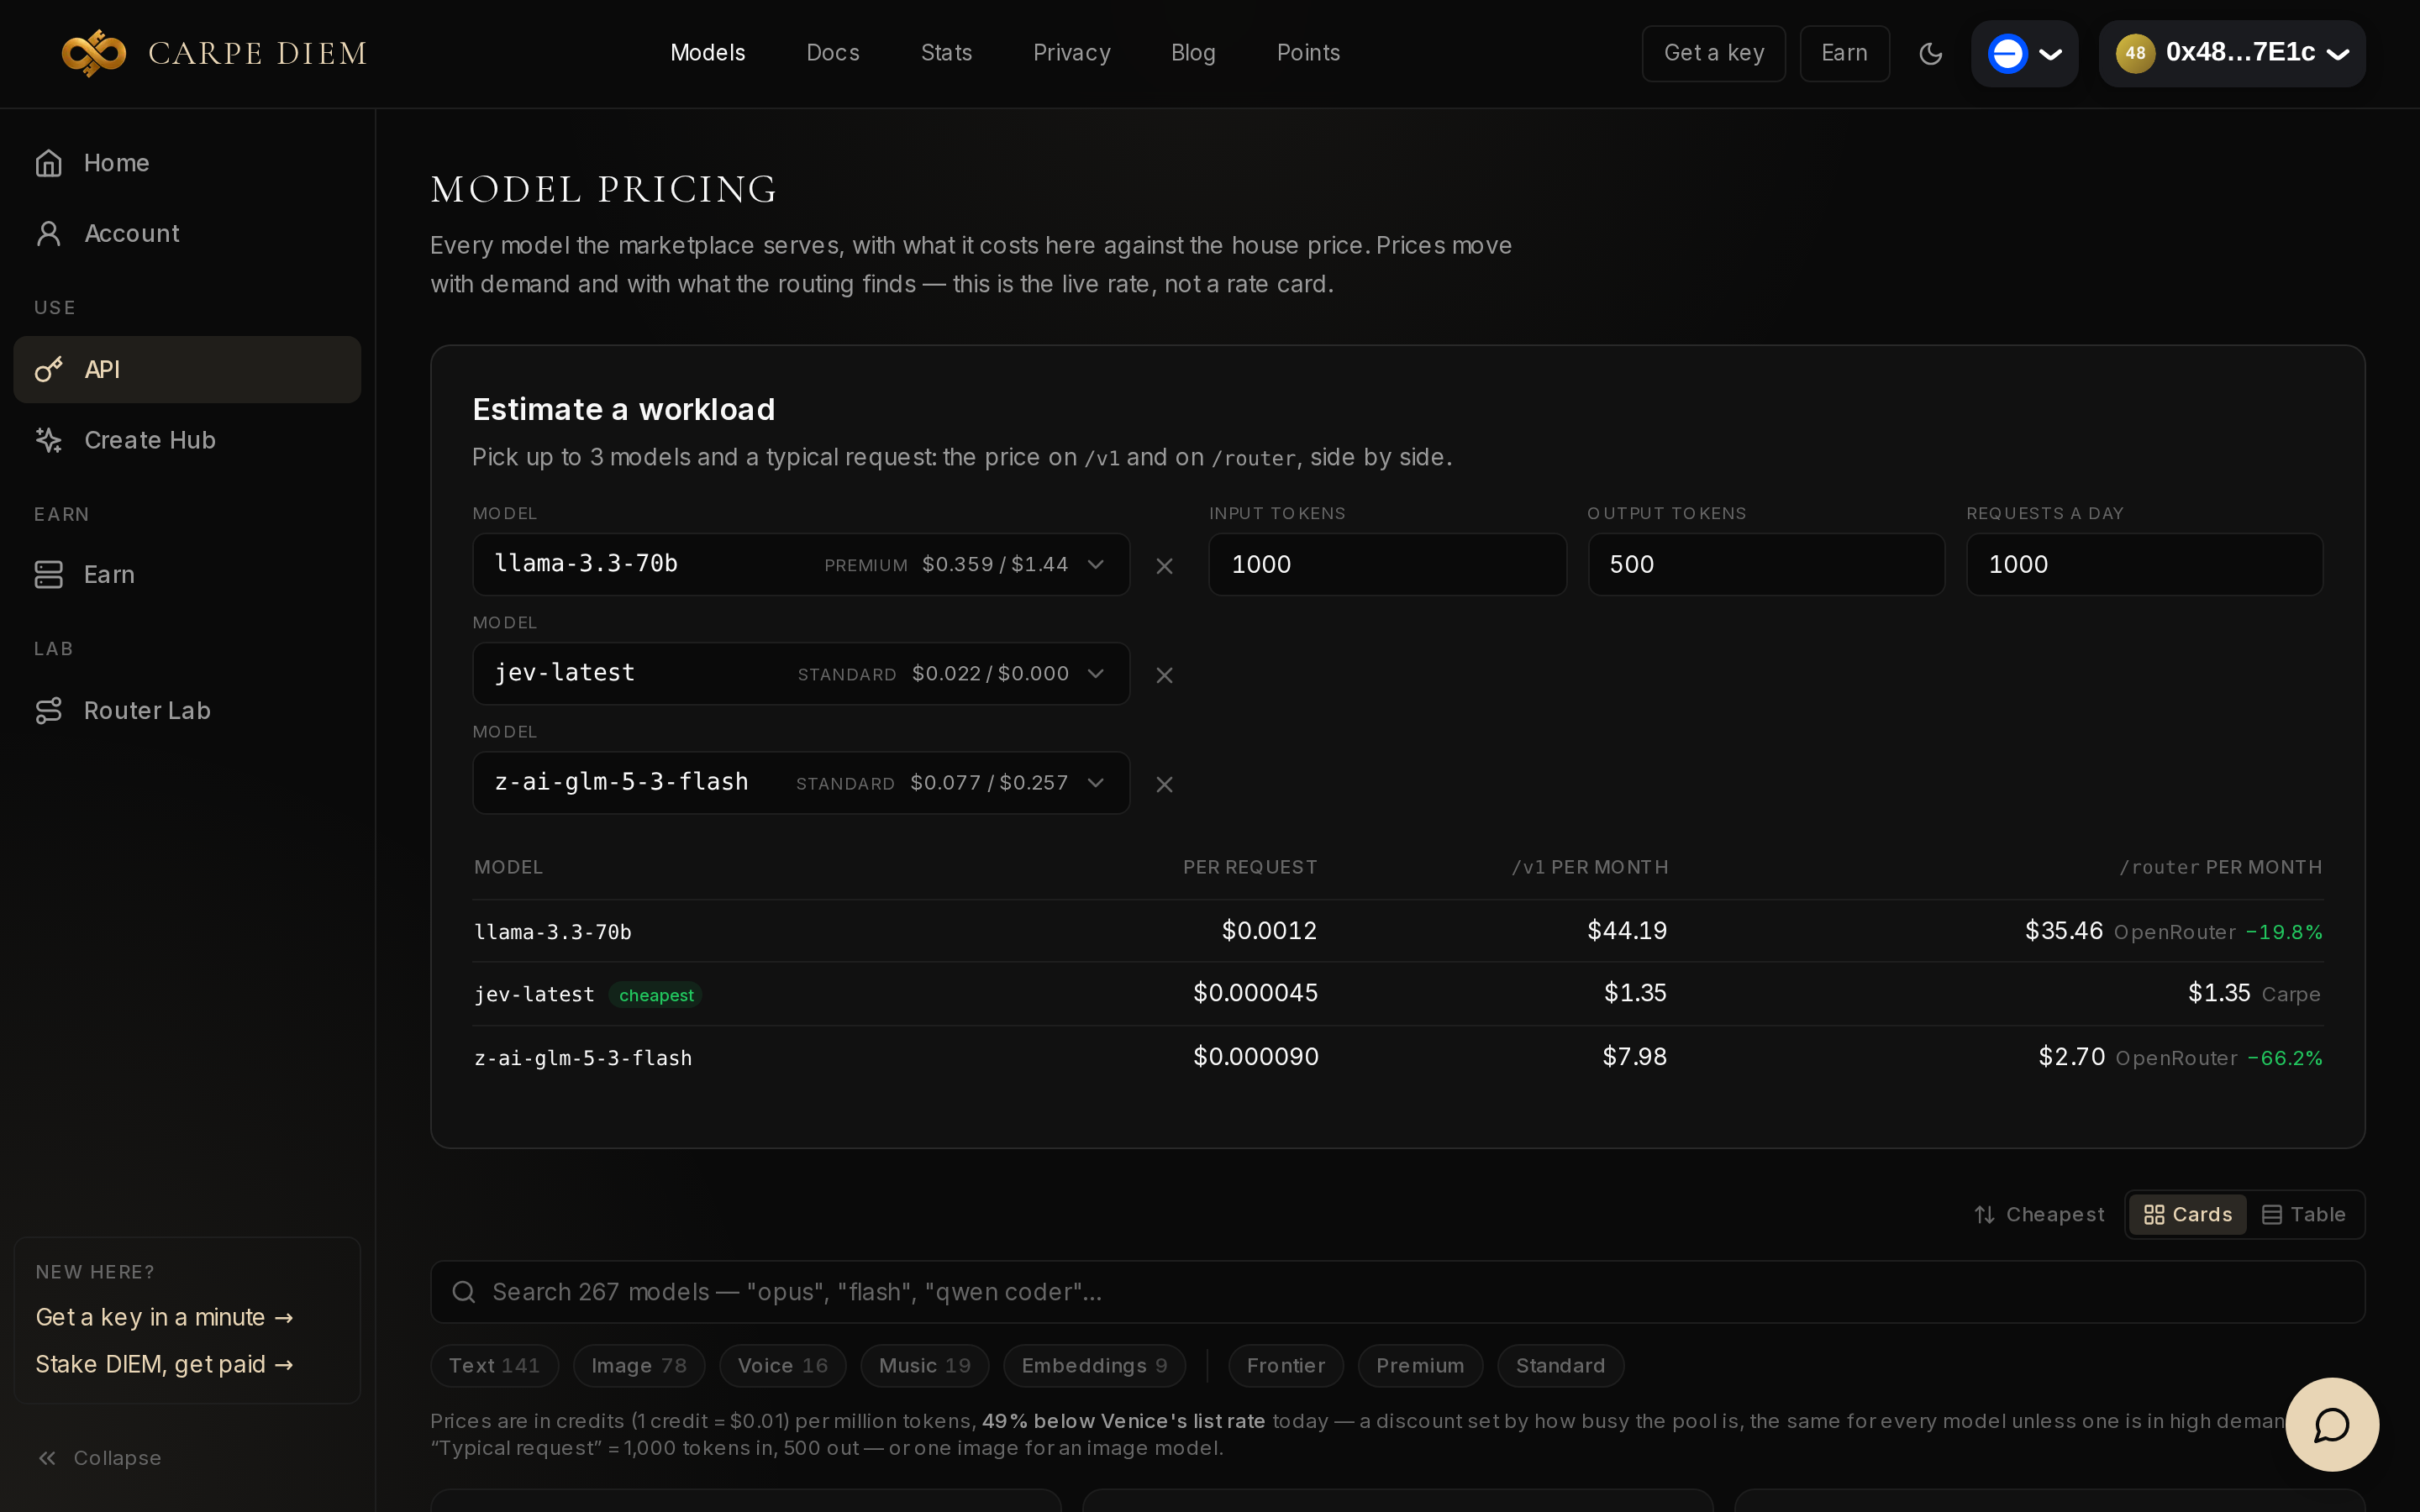
Mantivemos o cesto por omissão e clicámos duas vezes em Compare another model. A interface acrescentou jev-latest e depois z-ai-glm-5-3-flash. A tabela passa a uma linha por modelo.
| Modelo | /v1 por mês |
/router por mês |
|---|---|---|
llama-3.3-70b |
44,19 $ | 35,46 $ (OpenRouter) |
jev-latest (cheapest) |
1,35 $ | 1,35 $ (mercado Carpe) |
z-ai-glm-5-3-flash |
7,98 $ | 2,70 $ (OpenRouter) |
O distintivo cheapest marca o mês mais barato entre as colunas mostradas, não o melhor modelo para a sua tarefa. O desvio de /router depende do modelo: −19,8 % no Llama, −66,2 % no GLM Flash, nada no jev-latest, já servido ao melhor preço pela Carpe.
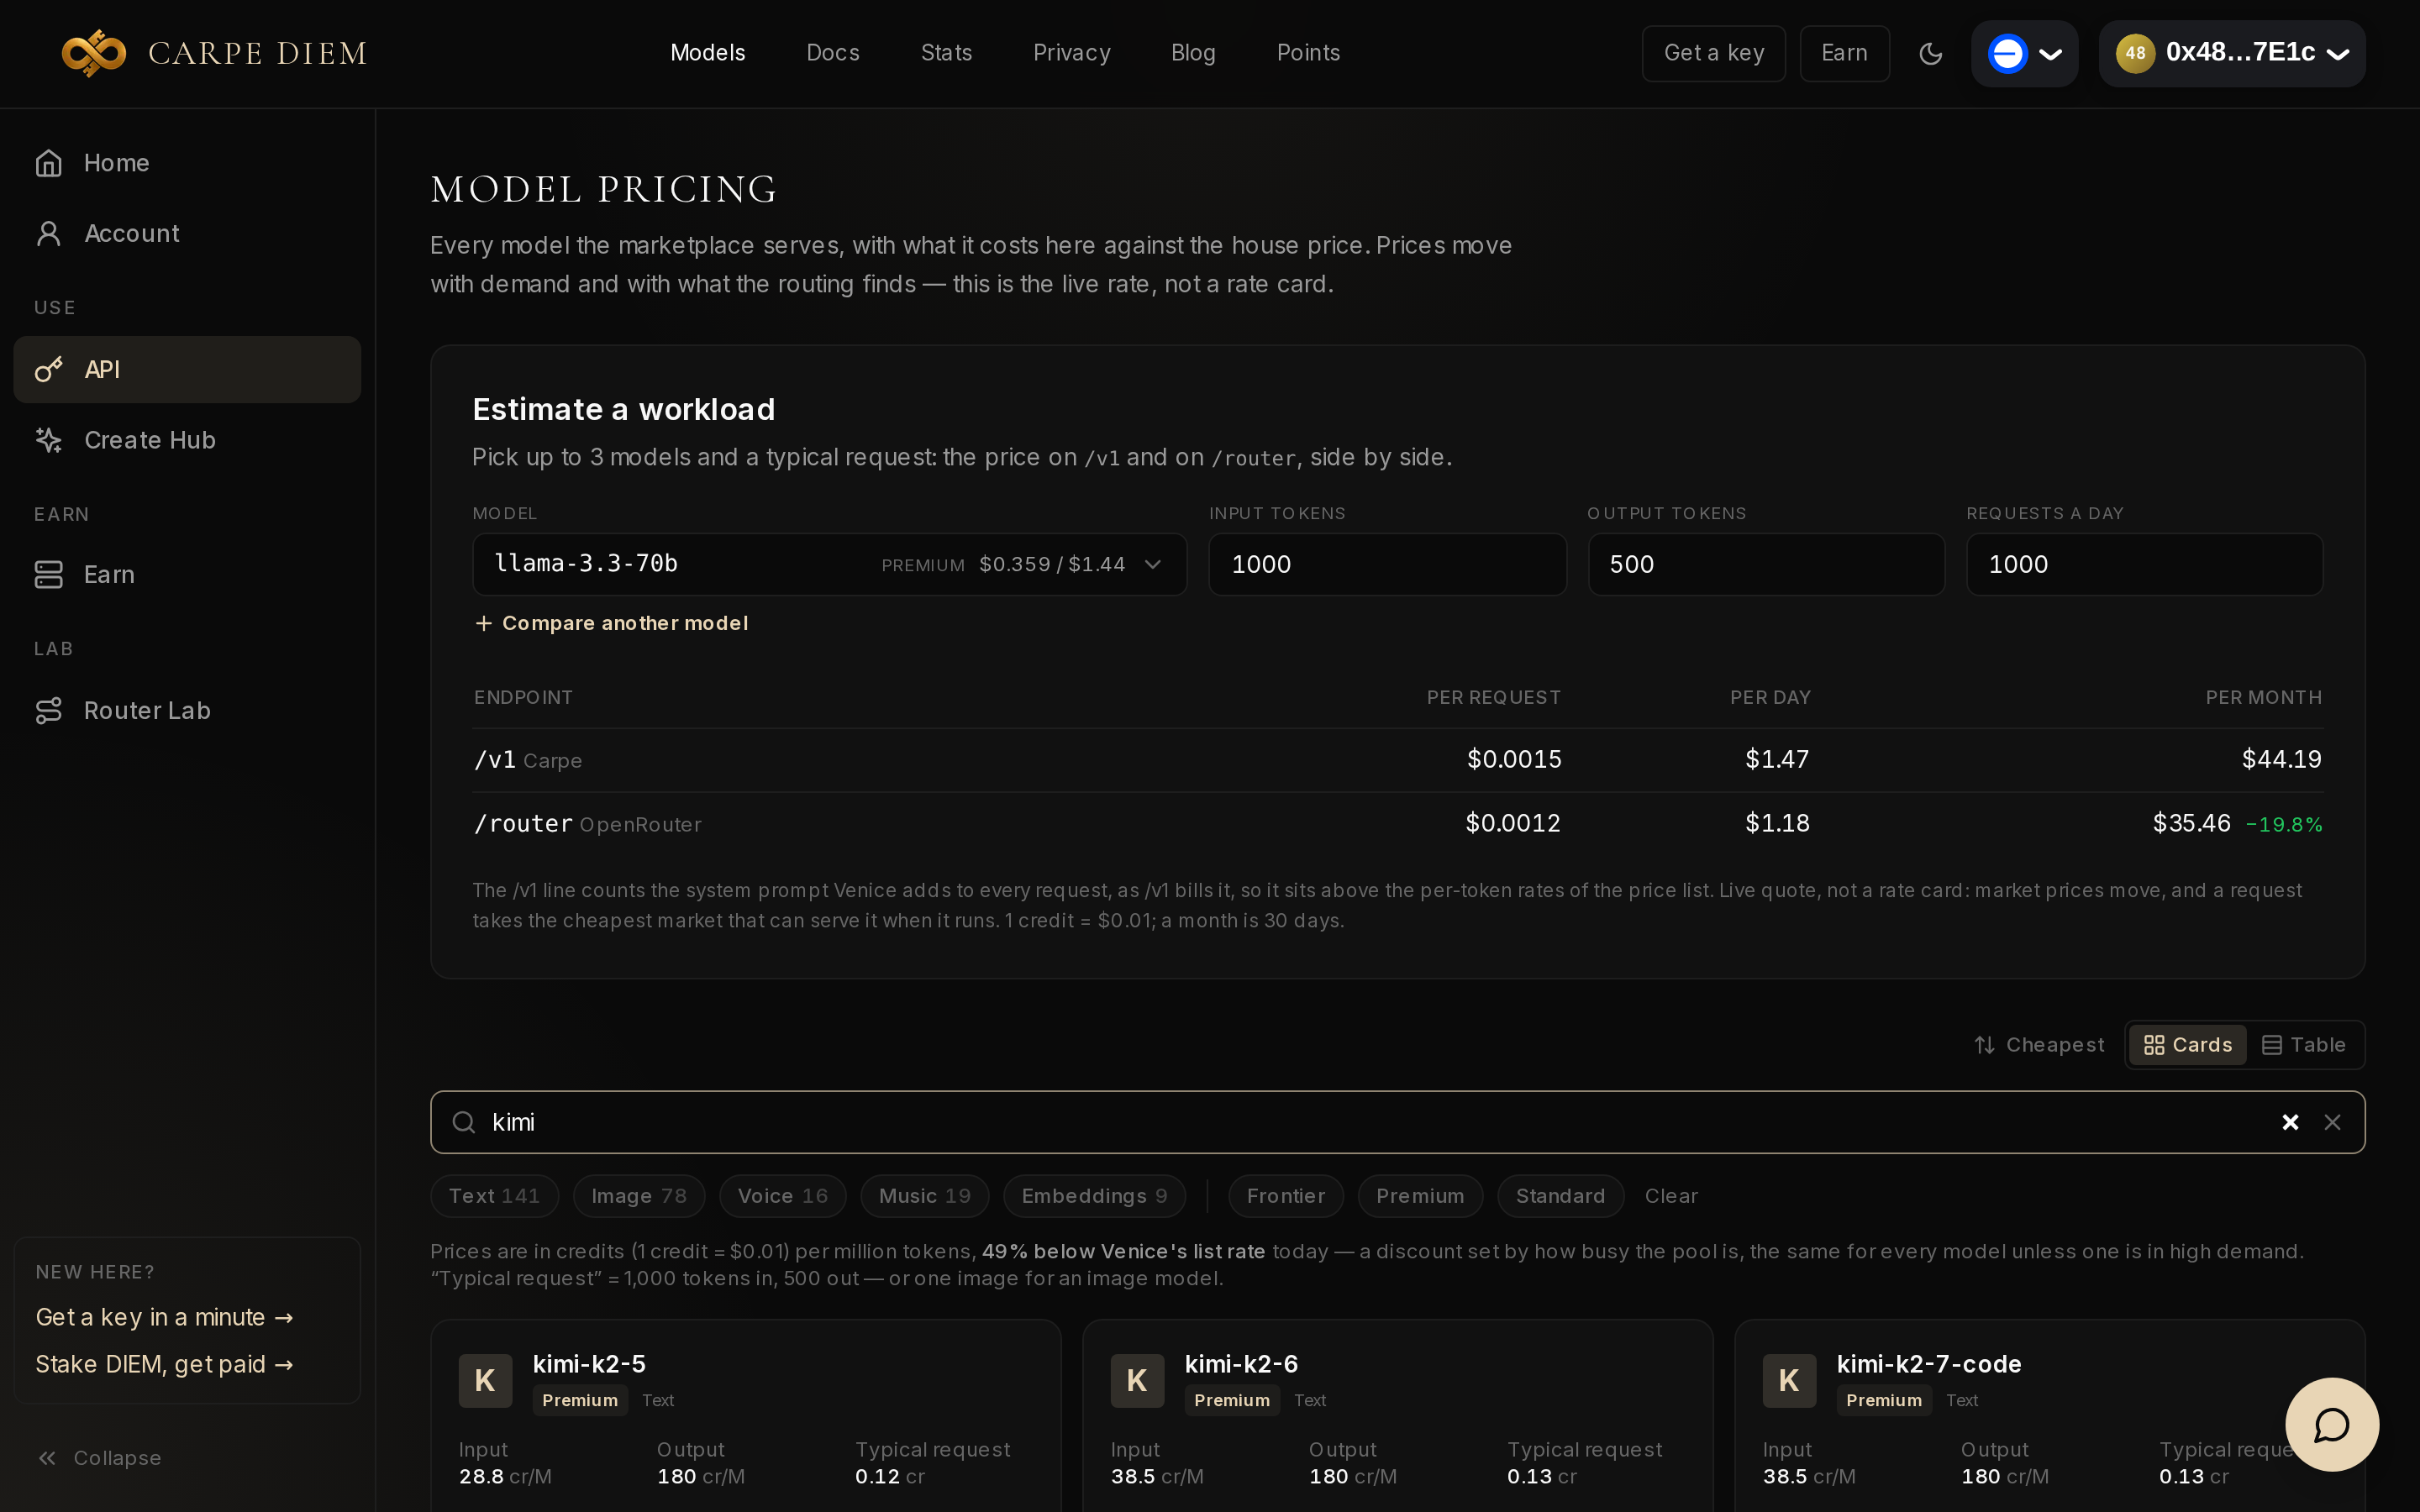
Para apontar a um modelo concreto, a pesquisa funciona por palavras: « kimi » lista kimi-k2-5, kimi-k2-6 e kimi-k2-7-code. O botão Estimate de um cartão de texto acrescenta-o ao bloco de cima, no limite de 3.
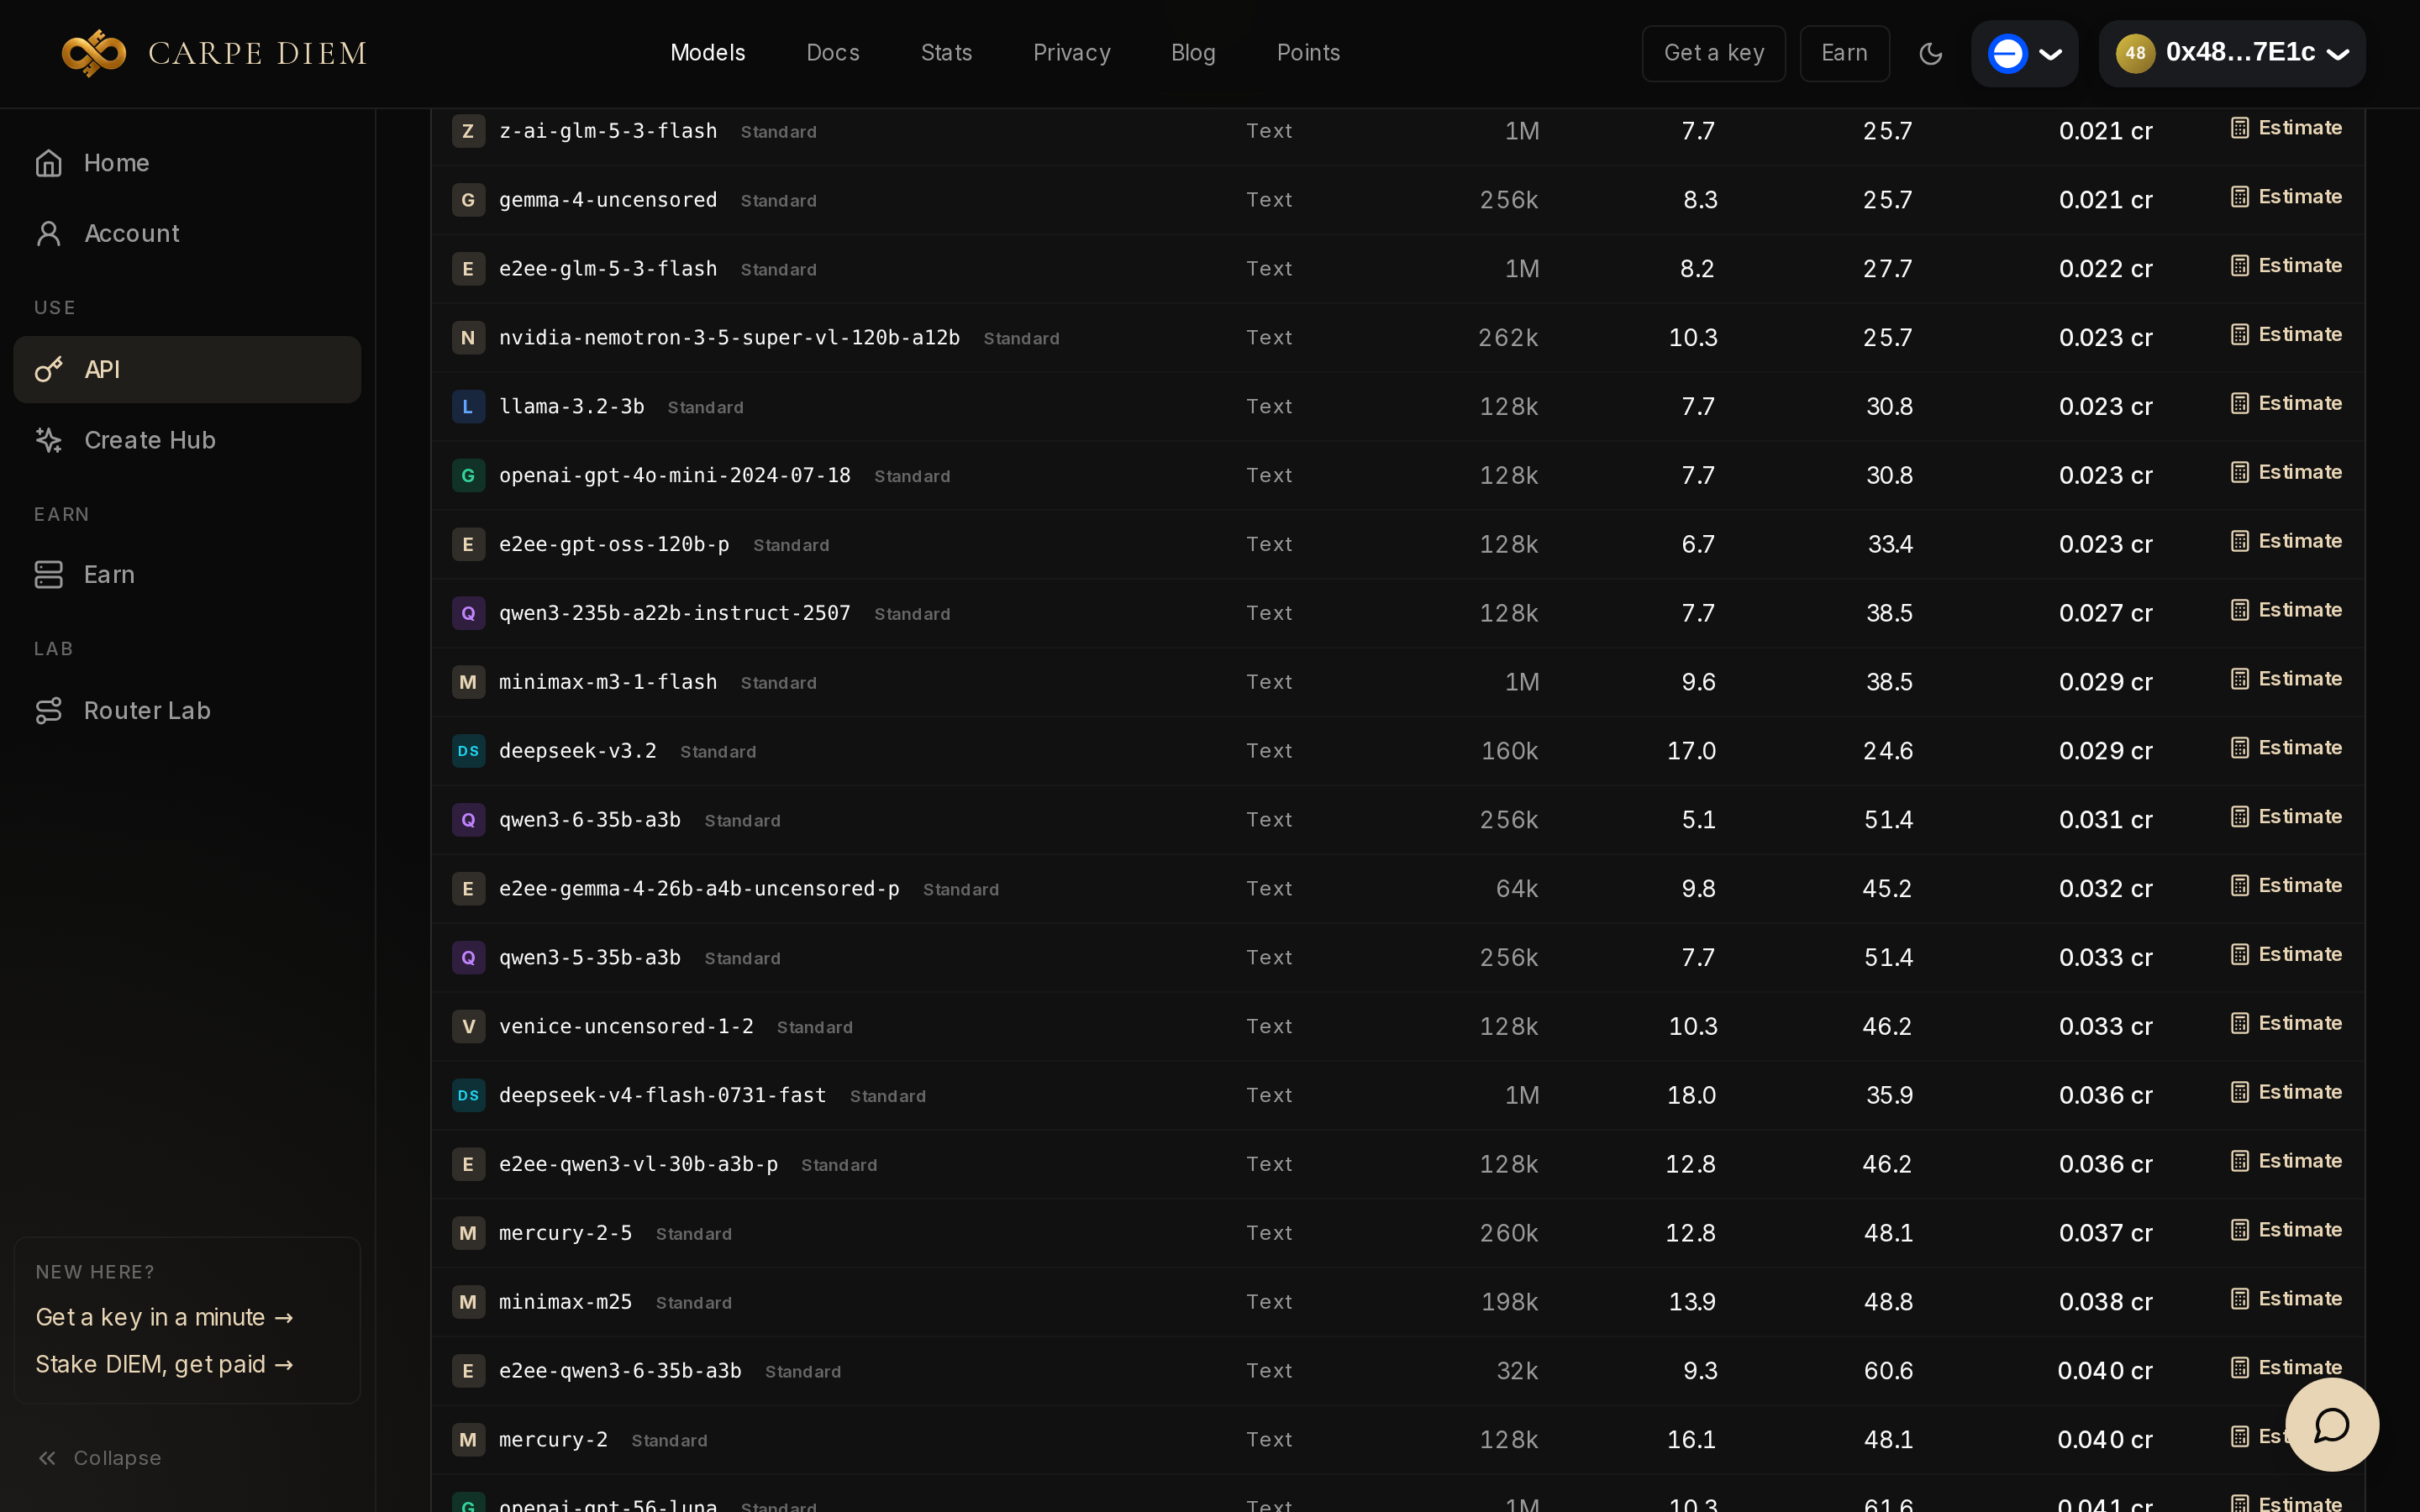
A vista Table alinha identificador, tipo, contexto, preços de entrada e saída em créditos por milhão, e o custo de um pedido típico (1000 tokens à entrada, 500 à saída).
O que é preciso saber antes de se fiar nisso
O estimador só aceita modelos tarifados ao token. Um modelo de imagem não tem botão Estimate: um cesto de tokens não diz nada de uma geração. O filtro Image mostra um preço Per image ou Per edit, por exemplo 0,51 crédito para lustify-sdxl e 1,54 crédito para flux-2-pro.
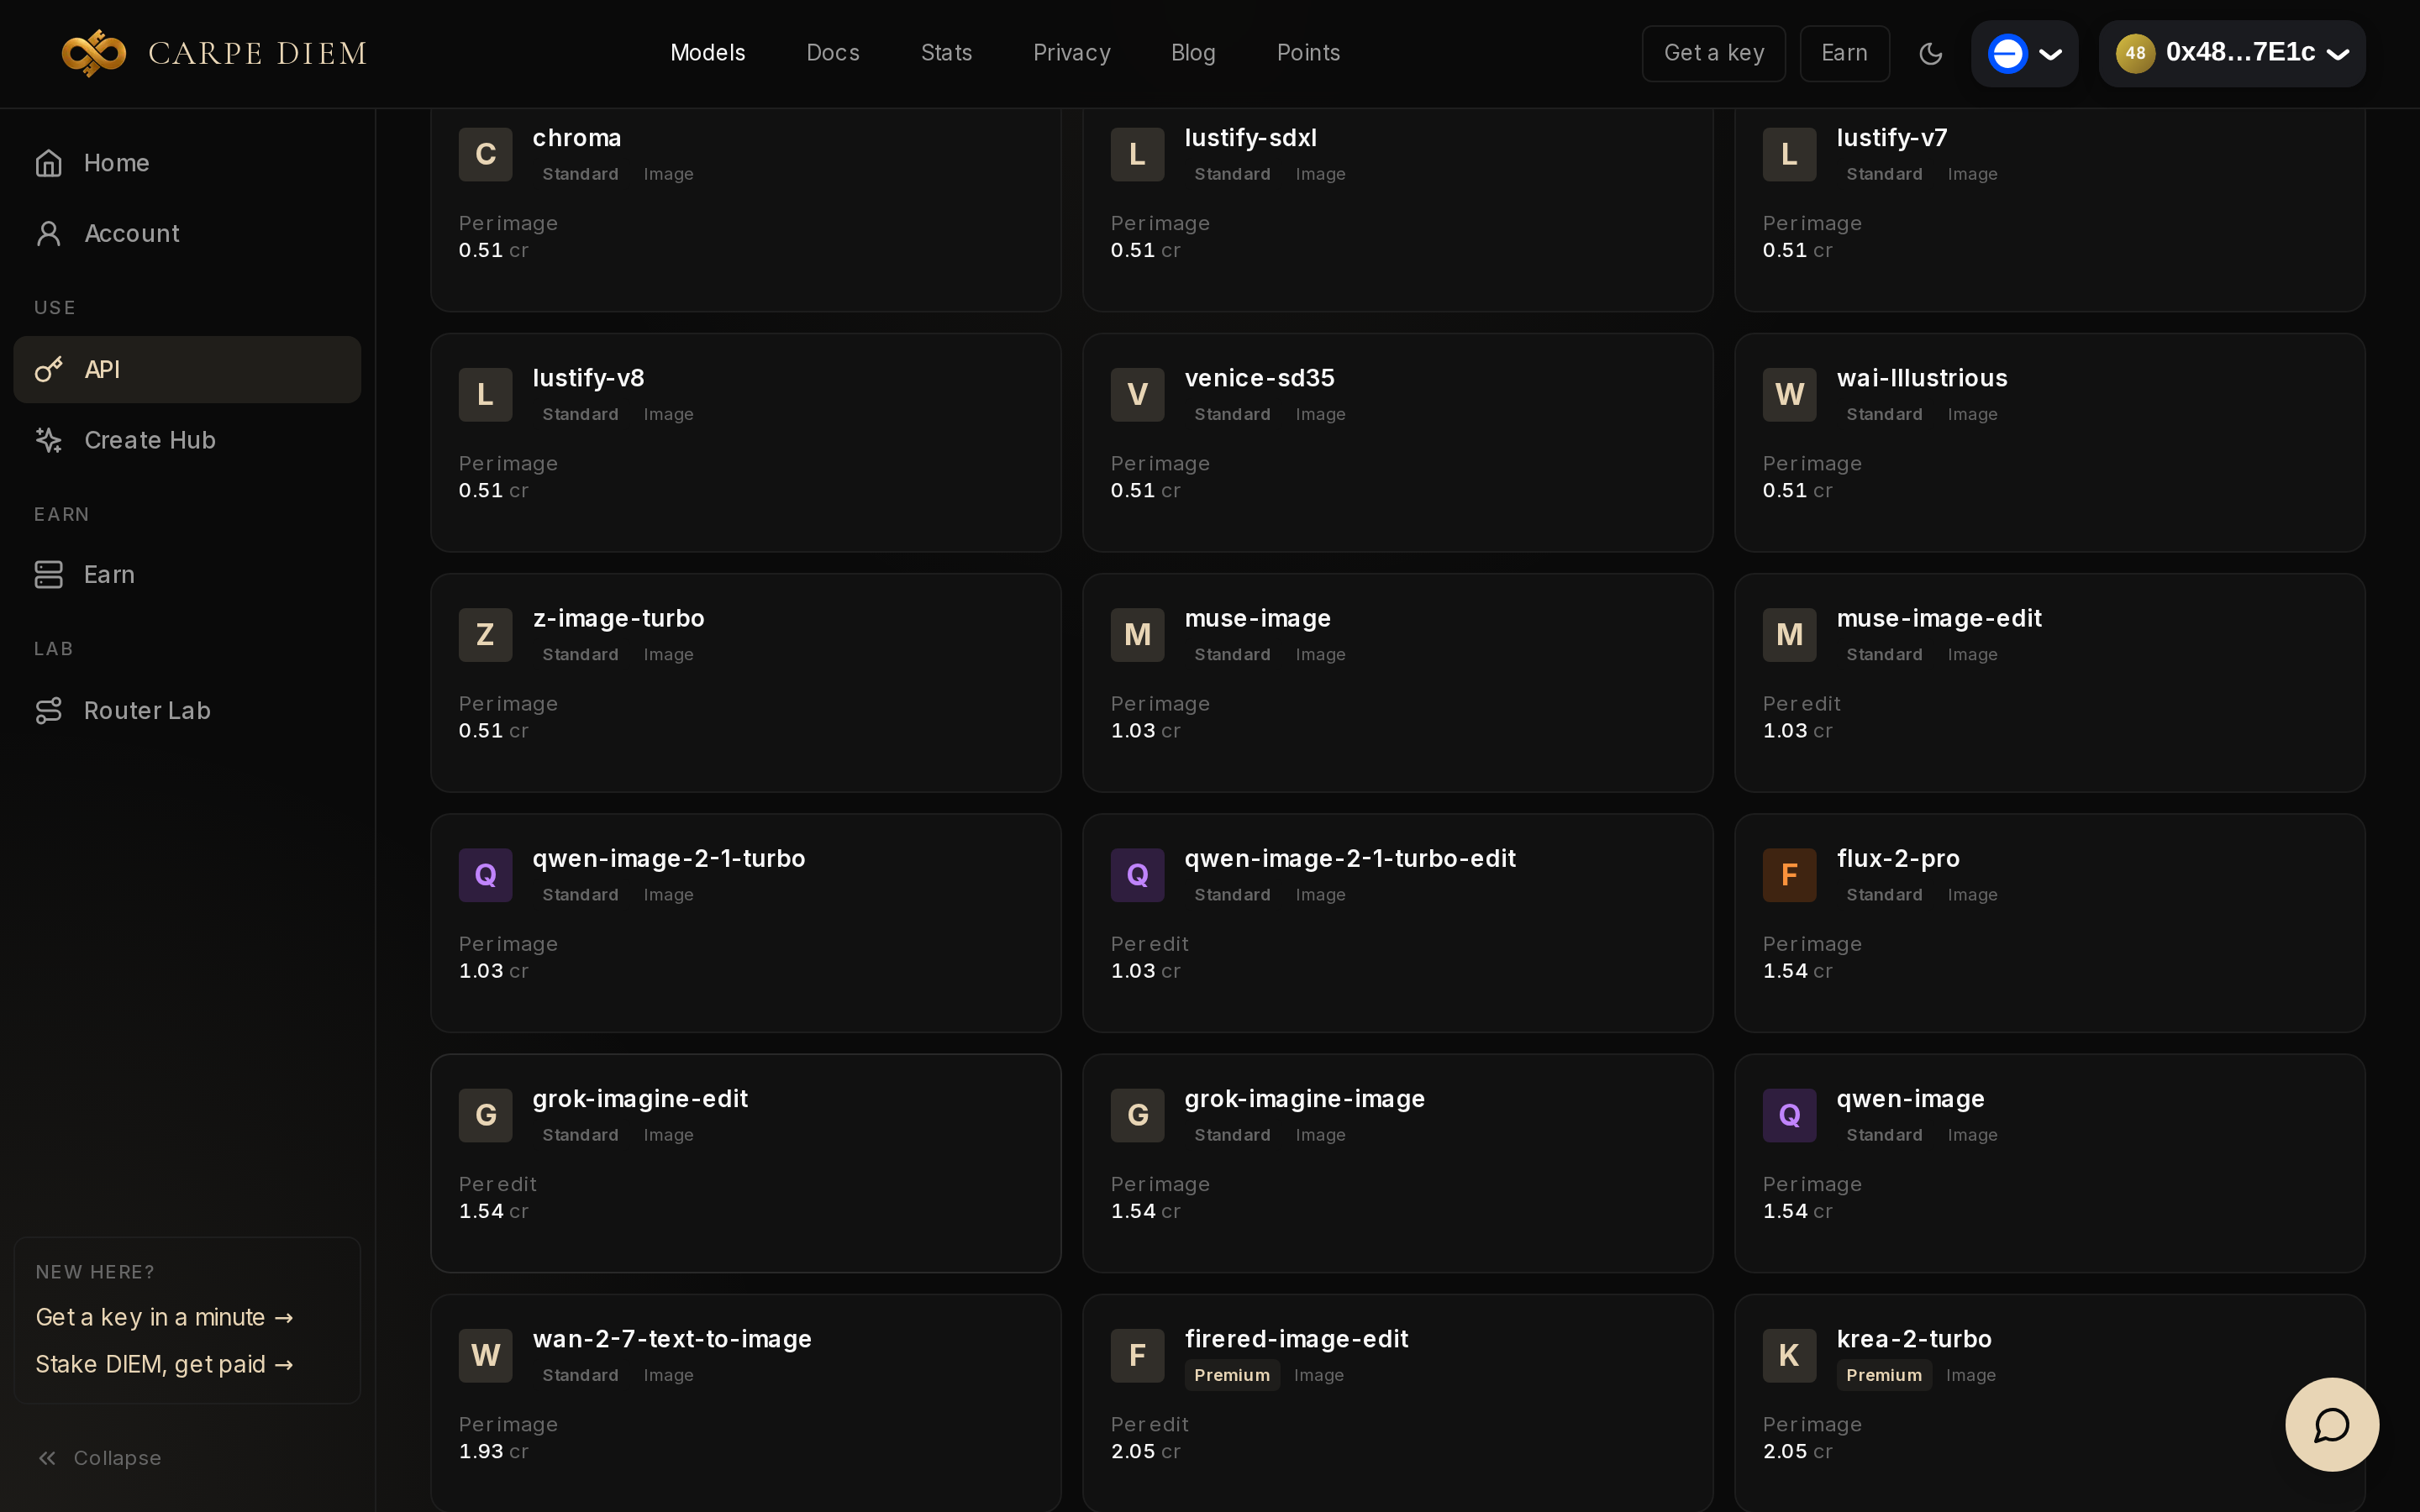
Para testar uma imagem ou um vídeo, passe pelo Create Hub.
Os mercados mexem, e um pedido toma o mais barato dos que o podem servir no momento em que parte. Numa conta não ligada, a página mostra a cotação dos mercados e diz que o encaminhamento real só se vê depois de ligar; estávamos ligados.
Para pedidos curtos e numerosos, acrescente venice_parameters.include_venice_system_prompt: false: não paga o prompt de sistema da Venice, cerca de 1 700 tokens por pedido. A linha /v1 do estimador já o conta, daí o desvio face a um cálculo ingénuo sobre os preços ao milhão da grelha.
Quanto custa
Os preços da grelha estão em créditos por milhão de tokens (1 crédito = 0,01 $). O estimador converte-os em dólares por pedido, por dia e por mês, mas não é um recibo: o montante faturado de um pedido real é o do cabeçalho de resposta ou do Hub. Para ligar depois uma chave cdm_, o SDK OpenAI Python e o ensaio Kimi K3.1 Pro dão o base_url.
Procedimento: ensaio de 8 de novembro de 2026, conta ligada, uma só execução; os modelos de imagem, voz e música não foram estimados.
Abra Model pricing, lance Estimate a workload nos seus três candidatos, e só depois escreva o base_url.