GPT-6.1 Terra: API-Preis, Benchmark und Einsatz
GPT-6.1 Terra steht auf Carpe Diem unter openai-gpt-61-terra, zu 0,5711 $ / 2,8557 $ je Million Tokens im Stand vom 28. Oktober, 43 % unter Venice (1 $ / 5 $). OpenAI stellt es als Mittelklasse-Modell vor, mit Vision und Bildschirmnutzung, angekündigt am 26. Oktober. Unser Benchmark vom 27. Oktober hat konformes JSON in 1,8 s geliefert und eine Schwellenrechnung korrekt in 3,8 s gelöst.
Illustration erzeugt mit seedream-v5-lite auf Carpe Diem.
Was Terra akzeptiert und wohin deine Daten gehen
Terra akzeptiert Text und Bilder und antwortet in Text. Audio und Video sind nicht unterstützt. Die OpenAI-Karte zielt auf visuelles Reasoning (ein Foto einer Produktkarte zuordnen, eine technische Zeichnung lesen) und Bildschirmnutzung. Der Katalog von Carpe Diem gibt ihm außerdem Reasoning, reasoning.effort, Tool-Aufrufe, ein Antwortschema, Websuche und 1 050 000 Tokens Kontext, wie die OpenAI-Karte. Die Kennung bei OpenAI ist gpt-6.1-terra; bei uns openai-gpt-61-terra.
Datenschutz anonymized: Venice leitet den Inhalt an OpenAI weiter, das ihn sieht und nach eigener Richtlinie verarbeitet. Details auf der Datenschutzseite. Wenn deine Prompts ein private-Modell nicht verlassen dürfen, ist Terra die falsche Wahl, auch 43 % unter Venice.
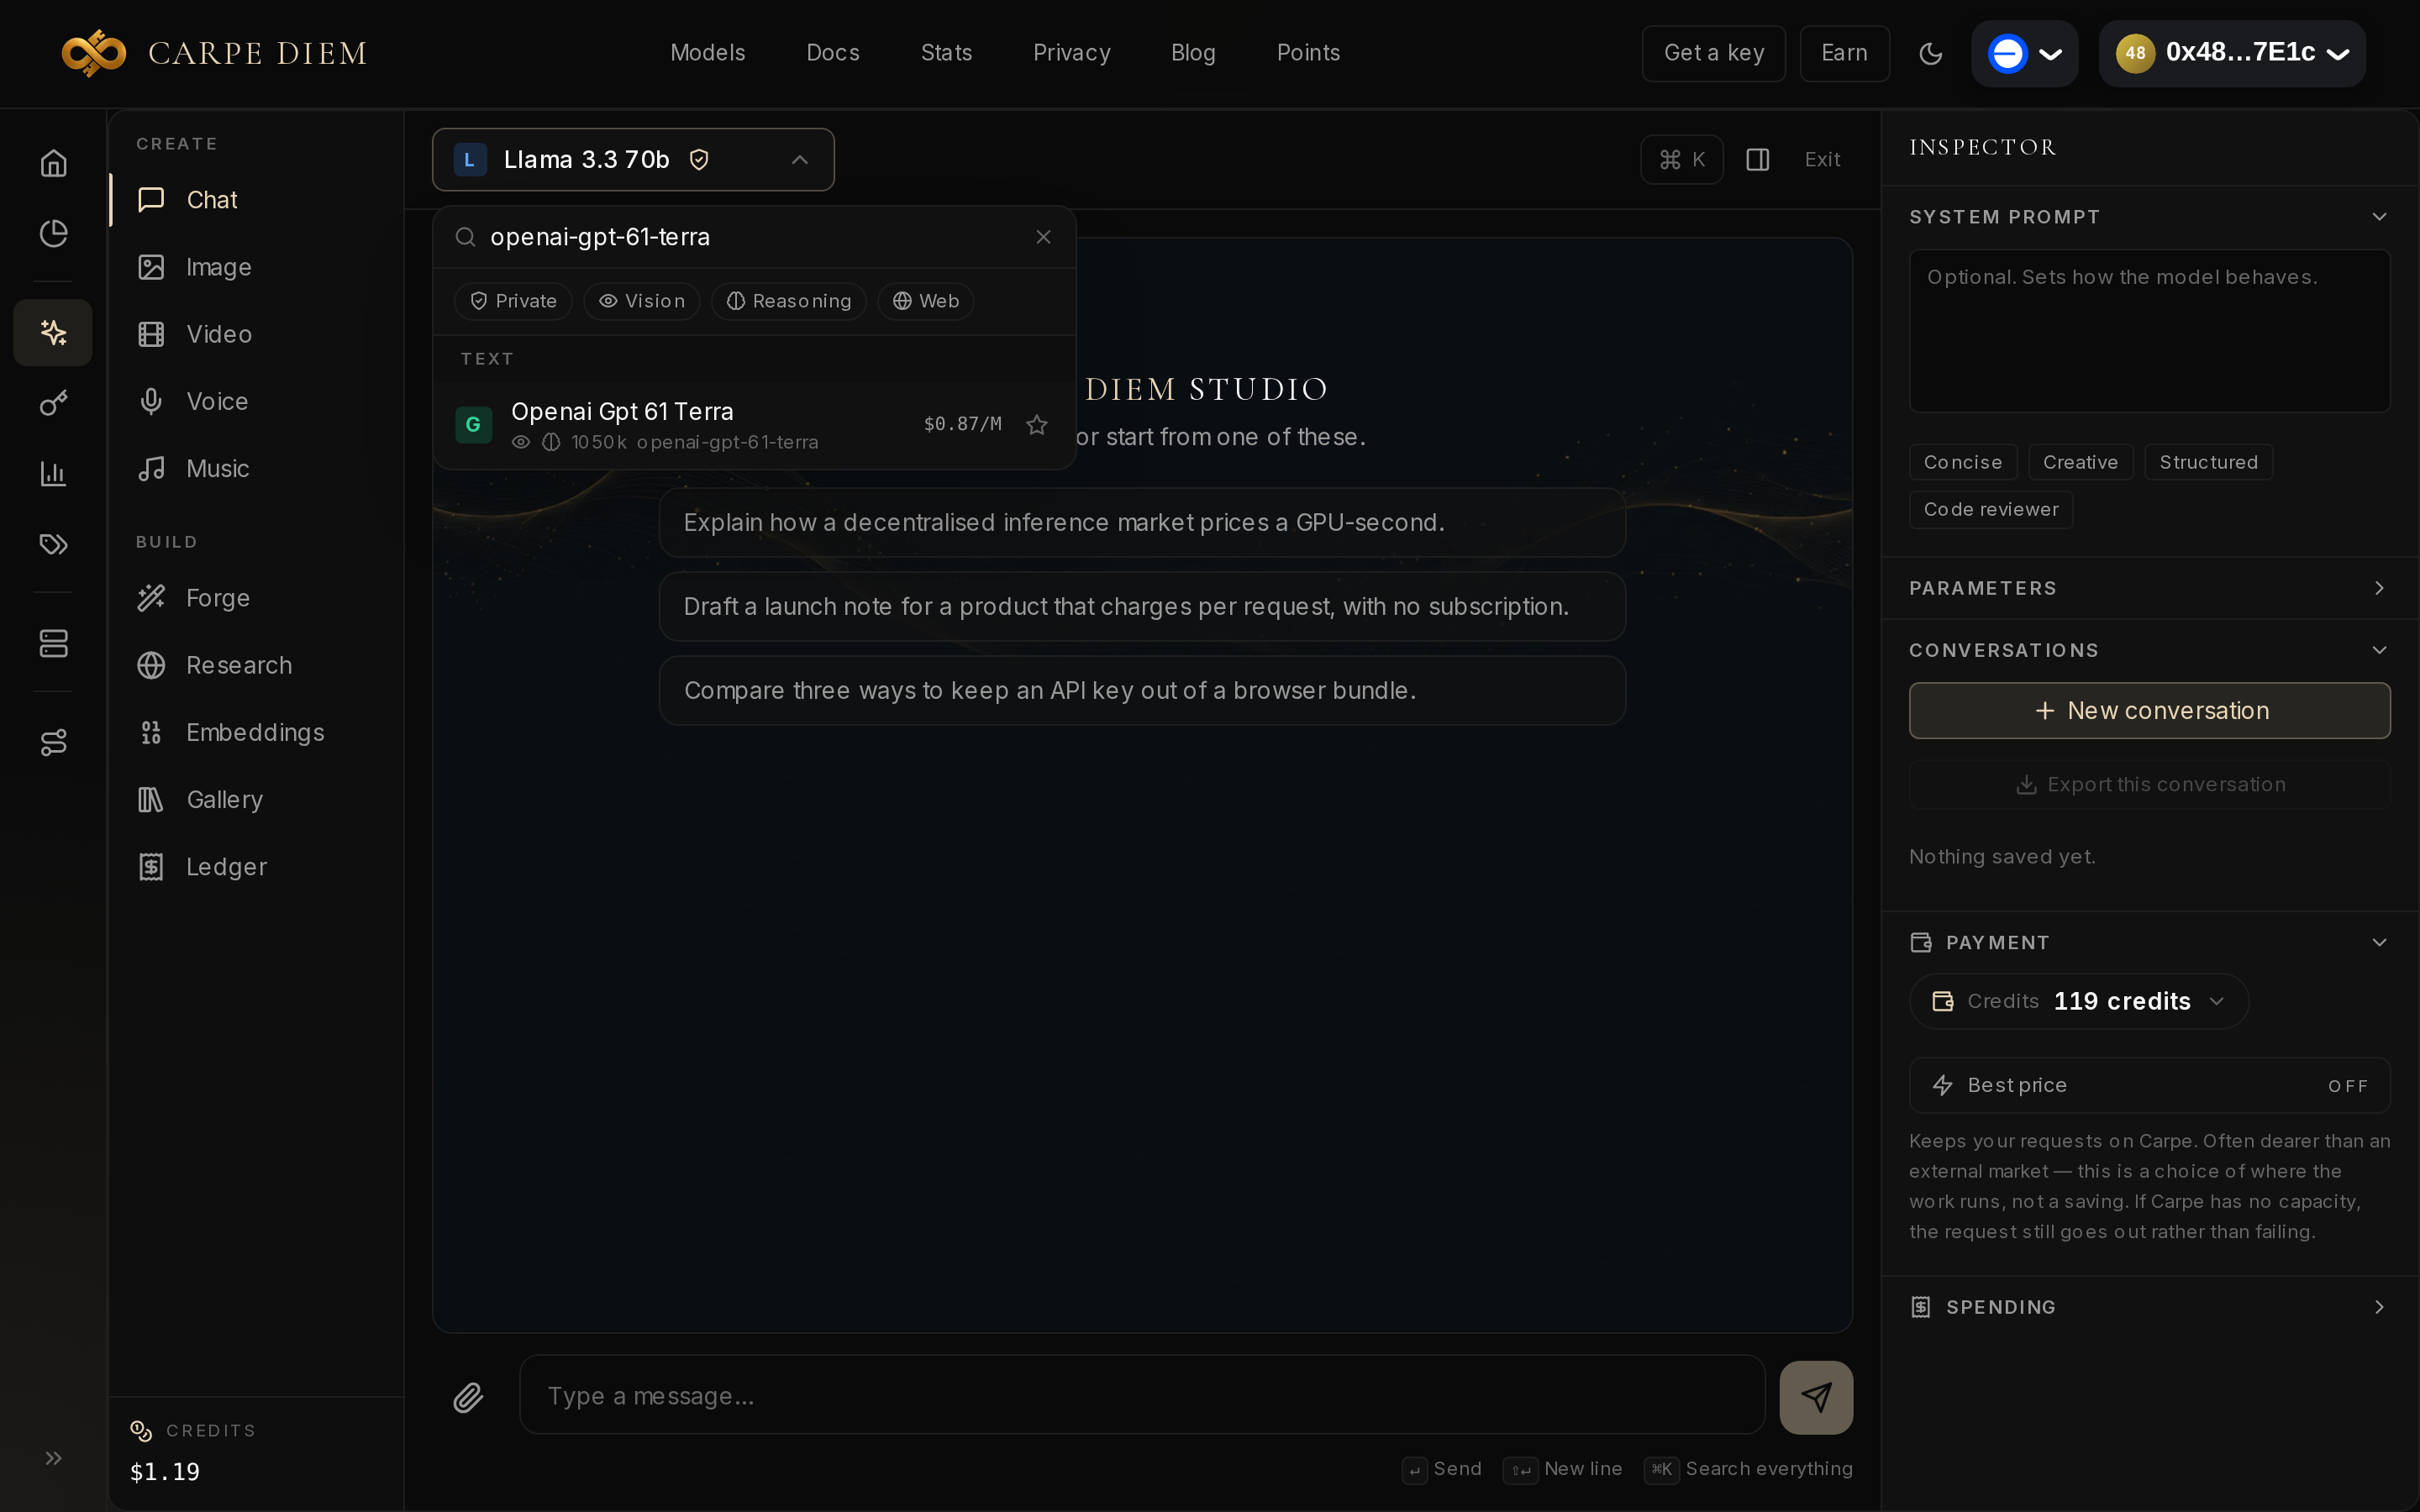 Hub-Wähler am 27. Oktober: 1 050 k Kontext. Die 0,87 $/M sind der Tagessatz, zu dem der Benchmark abgerechnet wurde.
Preise vom 28. Oktober: 0,57 $ / 2,86 $ je Million
Carpe Diem verkauft Inferenz über Venice weiter. Am 27. und 28. Oktober lag der Eingabeabstand zu Venice zwischen 13 % (0,8723 $, Benchmark-Tarif) und 48 % (0,5235 $). Im letzten Stand 0,5711 $ / 2,8557 $, also 43 % unter Venice. Tausend Anfragen mit 1 000 Eingabe- und 1 000 Ausgabetokens kosten 3,43 $ bei uns, 6,00 $ direkt bei Venice. Prüfe /models vor dem Budget: der Tarif bewegt sich von einem Tag zum nächsten.
| Eingabe / M | Ausgabe / M | 1 000 Anfragen (1k in / 1k out) | Kontext | Datenschutz | |
|---|---|---|---|---|---|
| GPT-6.1 Terra (Carpe Diem) | 0,5711 $ | 2,8557 $ | 3,43 $ | 1 050 000 | anonymized |
| GPT-6.1 Terra (Venice) | 1,0000 $ | 5,0000 $ | 6,00 $ | — | — |
| GPT-6.1 Sol | 1,1423 $ | 5,7115 $ | 6,85 $ | 1 050 000 | anonymized |
| GPT-5.6 Terra | 1,1423 $ | 6,8538 $ | 8,00 $ | 1 000 000 | anonymized |
| Mercury 3 | 0,0571 $ | 0,1999 $ | 0,26 $ | 1 000 000 | anonymized |
Ohne venice_parameters.include_venice_system_prompt: false stellt Venice seinen Systemprompt voran und rechnet ihn ab. Unser Satz « Reply with the single word ok. » ohne dieses Feld hat die Eingabe auf 1 689 Tokens aufgebläht. Mit dem Feld ging derselbe Prompt auf 13 Eingabetokens. In einem langen Chat gehen diese ~1 700 Tokens unter. Bei tausend Ein-Satz-Aufrufen werden sie der Hauptposten: schneide das Präfix beim ersten Versuch weg.
Benchmark vom 27. Oktober: konformes JSON in 1,8 s
Eine Ausführung pro Prüfung, abgerechnet zum Tarif vom 27. Oktober (0,8723 $ / 4,3616 $ je Million), dieselbe Batterie wie im Artikel zu Mercury 3. Wir haben weder Vision noch Tools noch reasoning.effort noch das Fenster von 1 050 000 Tokens geprüft: der Benchmark ist kurzer Text. Die Nadel lag in etwa 2 500 Wörtern. Die Code-Prüfung wurde nicht bewertet: unser Harness fand seine Testdatei nicht. Terra hat trotzdem eine Funktion compressRanges in JavaScript geliefert; wir haben sie nicht ausgeführt.
| openai-gpt-61-terra | |
|---|---|
| Erster Token | 1 029 ms |
| Reasoning | OK, 40000 · 3,8 s |
| JSON | konform · 1,8 s |
| Nadel (~2 500 Wörter) | gefunden · 1,7 s |
| FR-Text | 87 Wörter · 2,5 s |
| Benchmark-Kosten | 0,00625 $ |
Der erste Token kam in 1 029 ms, akzeptabel für Chat, nicht für Autovervollständigung. Das Reasoning fragte, ab wie vielen Anfragen ein Abo mit 12 $ Monatsgebühr, aber 0,30 $ weniger je Tausend, sich lohnt. Erwartete Antwort: 40000. Terra antwortete 40000, in 3,8 s, für 0,00088 $.
Das JSON enthielt vendor, amount_usdc 42.50, date 2026-03-03 und die zwei Artikelzeilen, in 1,8 s für 0,00032 $. Die Nadel 7319-KESTREL kam unverändert; es ist die teuerste Prüfung des Benchmarks (0,00365 $ von 0,00625 $), wegen des Eingabegewichts. Der französische Text, nach Lektüre beurteilt, ist korrekt, flüssig, ohne Fehler: 87 Wörter über die Rolle eines Modell-Routers.
Wann du Terra statt Mercury 3 nimmst
Mercury 3 für kurze JSON-Extraktion und Rechnung: dasselbe konforme JSON in 0,9 s (gegen 1,8 s) und dieselben 40000 in 1,5 s (gegen 3,8 s) in unserem Benchmark vom 23. Oktober, zu 0,0571 $ / 0,1999 $ je Million, etwa ein Zehntel des Terra-Preises. Diese Abstände beruhen auf einer Ausführung pro Modell, fünf Tage auseinander. Mercury 3 ist ebenfalls anonymized: das ist nicht die private Alternative.
Terra, wenn du Vision brauchst (der Katalog gibt sie Mercury 3 nicht) oder ein OpenAI-Modell, das schon in deinem Stack liegt. GPT-5.6 Terra, darüber in der OpenAI-Reihe, steht bei uns bei 1,1423 $ / 6,8538 $ je Million, ohne dass wir es gemessen haben. Sol kostet das Doppelte von GPT-6.1 Terra (1,1423 $ / 5,7115 $) und wir haben es nicht durch den Benchmark geschickt. Wenn Daten private bleiben müssen, weder Terra noch Mercury 3: der Inhalt geht zum Hersteller.
Ein Python-Aufruf, der den Venice-Prompt abschneidet
Lege einen cdm_-Key im Dashboard an. Exportiere CARPE_API_KEY=cdm_your_key_here und OPENAI_BASE_URL=https://carpe-diem.xyz/api/operator/v1. Der Ausschnitt installiert nichts: urllib reicht. Er schneidet den Venice-Systemprompt ab und gibt Antwort und Tokens aus.
import json
import os
import urllib.request

url = os.environ["OPENAI_BASE_URL"].rstrip("/") + "/chat/completions"
req = urllib.request.Request(
    url,
    data=json.dumps(
        {
            "model": "openai-gpt-61-terra",
            "messages": [{"role": "user", "content": "Reply with the single word ok."}],
            "venice_parameters": {"include_venice_system_prompt": False},
        }
    ).encode(),
    headers={
        "Authorization": "Bearer " + os.environ["CARPE_API_KEY"],
        "Content-Type": "application/json",
    },
    method="POST",
)
with urllib.request.urlopen(req, timeout=60) as resp:
    body = json.loads(resp.read().decode())

print(body["choices"][0]["message"]["content"])
usage = body.get("usage") or {}
print("prompt_tokens", usage.get("prompt_tokens"))
print("completion_tokens", usage.get("completion_tokens"))
ok
prompt_tokens 13
completion_tokens 5
Der Hub steht im Artikel Create Hub; die API im Python-SDK. Lege einen Key an, starte den Ausschnitt, ersetze dann den Prompt durch eine echte JSON-Extraktion: unser Benchmark vom 27. Oktober hat 0,00625 $ gekostet.