GPT-6.1 Terra: precio API, banco de pruebas y usos
GPT-6.1 Terra está en Carpe Diem como openai-gpt-61-terra, a 0,5711 $ / 2,8557 $ el millón de tokens en la lectura del 28 de octubre, 43 % bajo Venice (1 $ / 5 $). OpenAI lo presenta como un modelo de gama media, con visión y uso de pantalla, anunciado el 26 de octubre. Nuestro banco del 27 de octubre devolvió JSON conforme en 1,8 s y resolvió bien un cálculo de umbral de rentabilidad en 3,8 s.
Ilustración generada con seedream-v5-lite en Carpe Diem.
Qué acepta Terra y adónde van sus datos
Terra acepta texto e imágenes, y responde en texto. Audio y vídeo no están cubiertos. La ficha OpenAI lo destina al razonamiento visual (emparejar una foto con una ficha de producto, leer un dibujo técnico) y al uso de pantalla. El catálogo de Carpe Diem le da también el razonamiento, reasoning.effort, la llamada a herramientas, un esquema de respuesta, la búsqueda web y 1 050 000 tokens de contexto, como la ficha OpenAI. El identificador en OpenAI es gpt-6.1-terra; en Carpe Diem, openai-gpt-61-terra.
Privacidad anonymized: Venice transmite el contenido a OpenAI, que lo ve y lo trata según su propia política. Detalle en la página de privacidad. Si sus prompts no deben salir de un modelo private, Terra no es la elección adecuada, ni siquiera al 43 % bajo Venice.
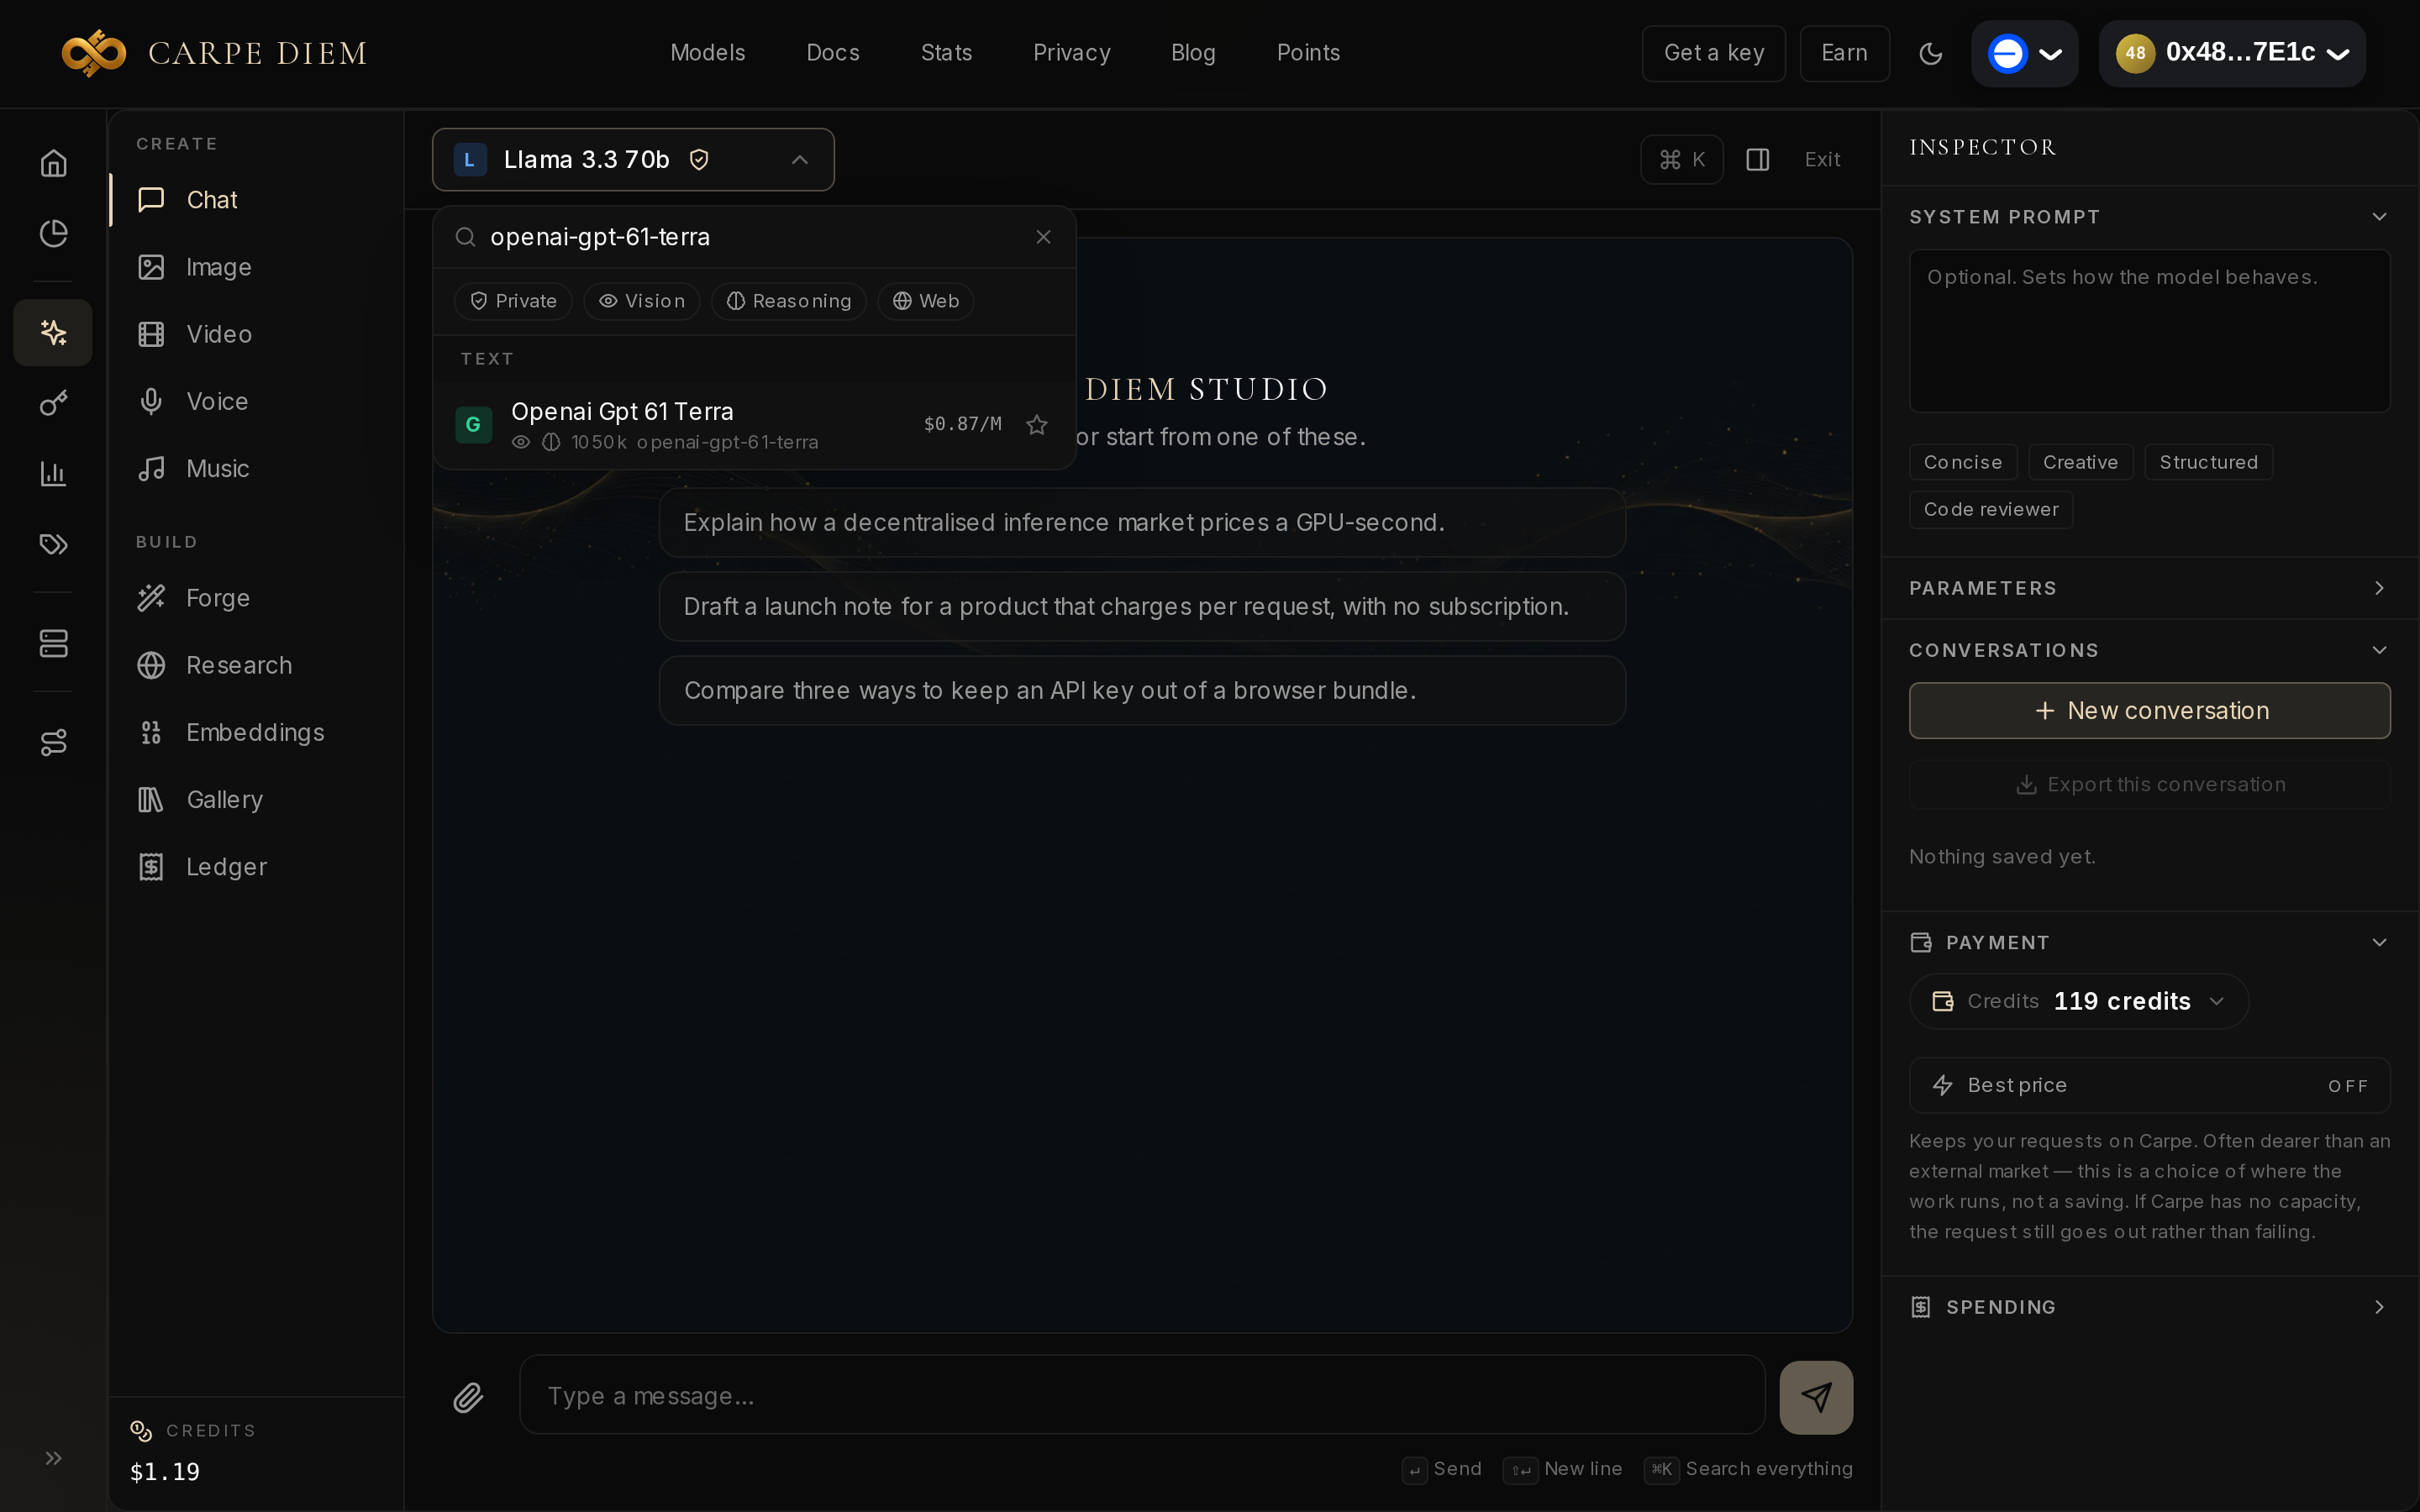 Selector del Hub el 27 de octubre: 1 050 k de contexto. El 0,87 $/M mostrado es la tarifa de ese día, a la que se facturó el banco de pruebas.
Precios del 28 de octubre: 0,57 $ / 2,86 $ el millón
Carpe Diem revende la inferencia a través de Venice. Los días 27 y 28 de octubre, el descuento de entrada frente a Venice fue del 13 % (0,8723 $, tarifa del banco) al 48 % (0,5235 $). En la última lectura, 0,5711 $ / 2,8557 $, un 43 % bajo Venice. Mil peticiones de 1 000 tokens de entrada y 1 000 de salida cuestan 3,43 $ aquí, 6,00 $ en Venice directo. Compruebe /models antes de presupuestar: la tarifa cambia de un día a otro.
| Entrada / M | Salida / M | 1 000 peticiones (1k in / 1k out) | Contexto | Privacidad | |
|---|---|---|---|---|---|
| GPT-6.1 Terra (Carpe Diem) | 0,5711 $ | 2,8557 $ | 3,43 $ | 1 050 000 | anonymized |
| GPT-6.1 Terra (Venice) | 1,0000 $ | 5,0000 $ | 6,00 $ | — | — |
| GPT-6.1 Sol | 1,1423 $ | 5,7115 $ | 6,85 $ | 1 050 000 | anonymized |
| GPT-5.6 Terra | 1,1423 $ | 6,8538 $ | 8,00 $ | 1 000 000 | anonymized |
| Mercury 3 | 0,0571 $ | 0,1999 $ | 0,26 $ | 1 000 000 | anonymized |
Salvo venice_parameters.include_venice_system_prompt: false, Venice antepone su prompt de sistema y lo factura. Nuestra frase « Reply with the single word ok. » sin ese campo infló la entrada a 1 689 tokens. Con el campo, el mismo prompt pasó a 13 tokens de entrada. En un chat largo, esos ~1 700 tokens se diluyen. En mil llamadas de una frase, se convierten en la partida principal: corte el prefijo ya en el primer ensayo.
Banco del 27 de octubre: JSON conforme en 1,8 s
Una sola ejecución por prueba, facturada a la tarifa del 27 de octubre (0,8723 $ / 4,3616 $ el millón), la misma batería que en el artículo Mercury 3. No hemos puesto a prueba ni la visión, ni las herramientas, ni reasoning.effort, ni la ventana de 1 050 000 tokens: el banco es texto corto. La aguja estaba en unas 2 500 palabras. La prueba de código no se puntuó: nuestro entorno de pruebas no encontró su archivo de tests. Aun así, Terra devolvió una función compressRanges en JavaScript; no la hemos ejecutado.
| openai-gpt-61-terra | |
|---|---|
| Primer token | 1 029 ms |
| Razonamiento | OK, 40000 · 3,8 s |
| JSON | conforme · 1,8 s |
| Aguja (~2 500 palabras) | encontrada · 1,7 s |
| Redacción FR | 87 palabras · 2,5 s |
| Coste del banco | 0,00625 $ |
El primer token llegó en 1 029 ms, aceptable para chat, no para autocompletado. El razonamiento preguntaba a partir de cuántas peticiones una tarifa plana de 12 $ de cuota mensual, pero 0,30 $ menos por mil, resulta rentable. Respuesta esperada: 40000. Terra respondió 40000, en 3,8 s, por 0,00088 $.
El JSON contenía vendor, amount_usdc 42.50, date 2026-03-03 y las dos líneas de artículos, en 1,8 s por 0,00032 $. La aguja 7319-KESTREL salió tal cual; es la prueba más cara del banco (0,00365 $ de 0,00625 $), por el peso de la entrada. La redacción francesa, juzgada a la lectura, es correcta, fluida, sin falta: 87 palabras sobre el papel de un enrutador de modelos.
Cuándo elegir Terra frente a Mercury 3
Mercury 3 para la extracción JSON y el cálculo cortos: el mismo JSON conforme en 0,9 s (frente a 1,8 s) y el mismo 40000 en 1,5 s (frente a 3,8 s) en nuestro banco del 23 de octubre, a 0,0571 $ / 0,1999 $ el millón, unas diez veces menos que Terra. Esas diferencias se basan en una sola ejecución por modelo, con cinco días de diferencia. Mercury 3 también es anonymized: no es la alternativa privada.
Terra si necesita la visión (el catálogo no se la da a Mercury 3) o un modelo OpenAI que ya esté en su pila. GPT-5.6 Terra, por encima en la gama OpenAI, está a 1,1423 $ / 6,8538 $ el millón aquí, sin que lo hayamos medido. Sol cuesta el doble de GPT-6.1 Terra (1,1423 $ / 5,7115 $) y no lo hemos pasado por el banco. Si los datos deben quedarse en private, ni Terra ni Mercury 3: el contenido va al fabricante.
Una llamada Python que corta el prompt de Venice
Cree una clave cdm_ en el panel. Exporte CARPE_API_KEY=cdm_your_key_here y OPENAI_BASE_URL=https://carpe-diem.xyz/api/operator/v1. El fragmento no instala nada: basta urllib. Corta el prompt de sistema de Venice y muestra la respuesta y los tokens.
import json
import os
import urllib.request

url = os.environ["OPENAI_BASE_URL"].rstrip("/") + "/chat/completions"
req = urllib.request.Request(
    url,
    data=json.dumps(
        {
            "model": "openai-gpt-61-terra",
            "messages": [{"role": "user", "content": "Reply with the single word ok."}],
            "venice_parameters": {"include_venice_system_prompt": False},
        }
    ).encode(),
    headers={
        "Authorization": "Bearer " + os.environ["CARPE_API_KEY"],
        "Content-Type": "application/json",
    },
    method="POST",
)
with urllib.request.urlopen(req, timeout=60) as resp:
    body = json.loads(resp.read().decode())

print(body["choices"][0]["message"]["content"])
usage = body.get("usage") or {}
print("prompt_tokens", usage.get("prompt_tokens"))
print("completion_tokens", usage.get("completion_tokens"))
ok
prompt_tokens 13
completion_tokens 5
El Hub está descrito en el artículo Create Hub; la API, en el SDK Python. Cree una clave, ejecute el fragmento y sustituya el prompt por una extracción JSON real: nuestro banco de pruebas del 27 de octubre costó 0,00625 $.