Vercel AI SDK : chat streaming Next.js sur Carpe Diem
Vous avez un dashboard Next.js et vous voulez qu'un utilisateur pose une question et voie la réponse s'écrire dans la page, mot après mot. Le Vercel AI SDK est la boîte à outils TypeScript qui fait ça sans que vous écriviez ni le HTTP ni le parseur SSE. Ce tuto la branche sur Carpe Diem, du premier appel en terminal jusqu'à la page de chat.
Illustration générée avec seedream-v5-lite sur Carpe Diem.
Ce que le SDK vous épargne
Côté serveur, generateText renvoie un texte d'un bloc et streamText un flux jeton par jeton. Côté navigateur, le hook useChat tient la liste des messages, l'état de la requête et met la bulle à jour à chaque fragment reçu.
Dans notre appli, la page appelle useChat, qui poste sur une route /api/chat. La route appelle streamText, et createOpenAICompatible envoie la requête à https://carpe-diem.xyz/api/operator/v1. Vous changez de modèle en changeant une chaîne.
Nous l'avons essayé avec deepseek-v4-1-flash. Un pong a coûté 0,000033 $ (1 592 jetons lus en cache) ; un haiku streamé, environ 0,0004 $.
Ce qu'il vous faut
- Un compte Carpe Diem avec des crédits ou un compte prepaid, et une clé
cdm_(onglet API Keys du tableau de bord acheteur). - Node.js 22 et
npm.
Les versions exactes figurent dans les commandes npm install plus bas. Sans Next.js, les deux scripts hello.mjs et stream.mjs suffisent pour un essai en terminal. Pour un script Python, le tutoriel SDK OpenAI Python fait le même branchement avec base_url.
Étape 1 : créer une clé cdm_
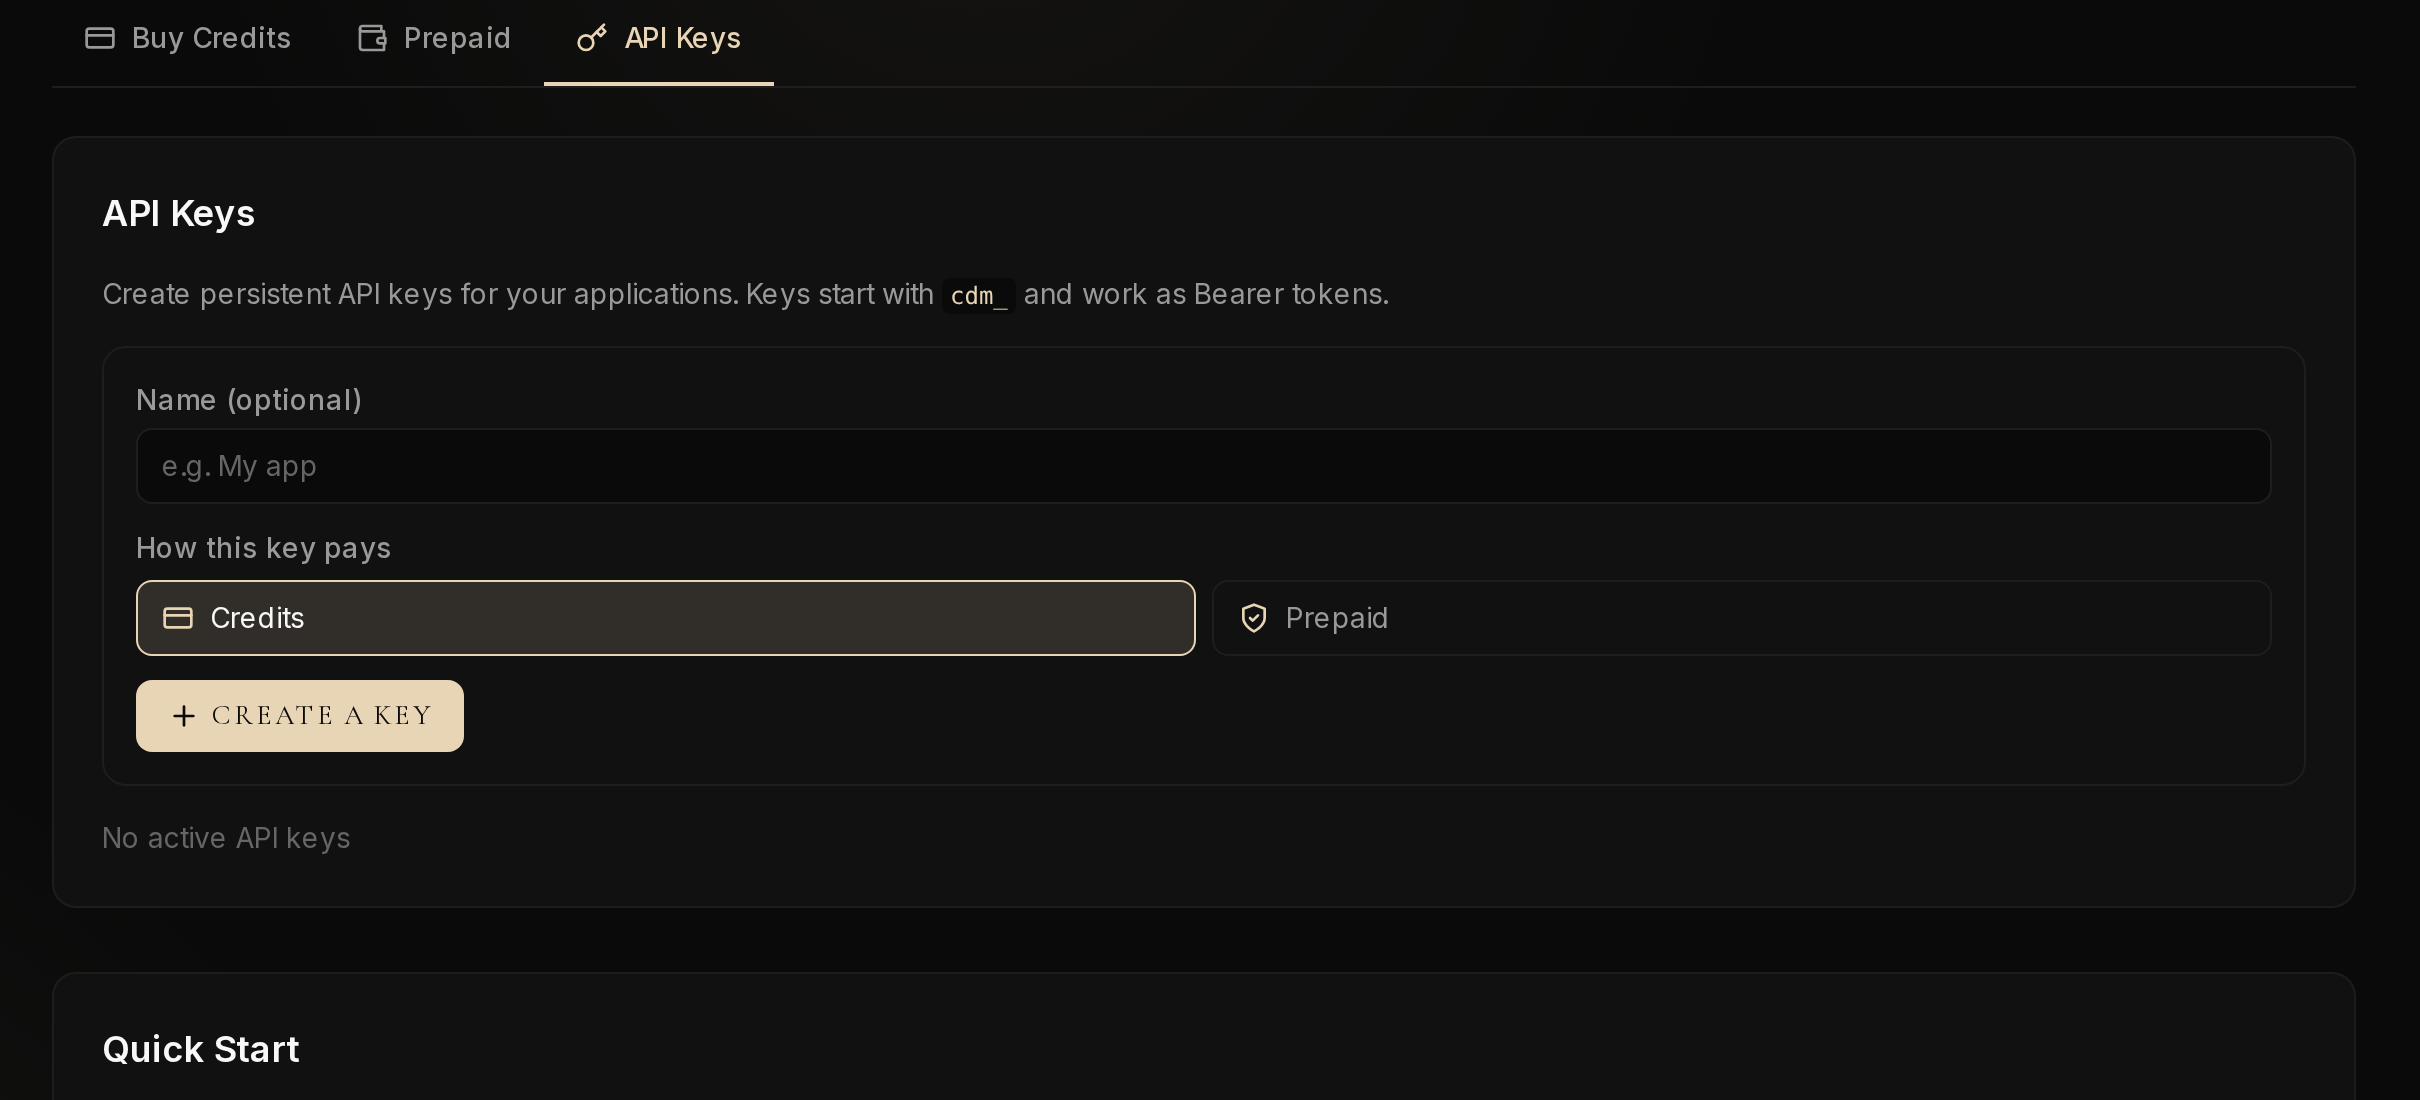
Ouvrez Credits & keys, onglet API Keys. Choisissez ce qui paie la clé (Credits ou Prepaid), donnez-lui éventuellement un nom, puis cliquez sur Create a key. Credits est un solde d'usage non retirable ; Prepaid est un compte que vous détenez et dont vous pouvez retirer le solde (détail des paiements).
La clé commence par cdm_ et ne s'affiche qu'une fois : copiez-la tout de suite.
Dans le shell du tutoriel :
export OPENAI_API_KEY=cdm_your_key_here
Étape 2 : installer l'AI SDK et le provider compatible OpenAI
npm install ai@7.0.157 @ai-sdk/openai-compatible@3.0.81
createOpenAICompatible envoie POST /chat/completions sous baseURL. Pour Carpe Diem, baseURL doit donc déjà contenir /v1 : https://carpe-diem.xyz/api/operator/v1. Sans lui, nous avons reçu un 404 Not Found, comme le rappelle le guide SDK en tête de page.
Étape 3 : un premier appel avec generateText, et son coût
Hors streaming, Carpe Diem écrit le coût dans les en-têtes X-Carpe-*, pas dans le usage du SDK. Le fetch personnalisé du fichier hello.mjs les lit au passage.
Le plafond maxOutputTokens: 64 a suffi pour pong. À 16, un de nos passages n'a renvoyé que du raisonnement : texte vide, finishReason: length. Prévoyez de la marge, car ce modèle raisonne avant de répondre.
import { createOpenAICompatible } from "@ai-sdk/openai-compatible";
import { generateText } from "ai";

const carpe = createOpenAICompatible({
  name: "carpe-diem",
  apiKey: process.env.OPENAI_API_KEY,
  baseURL: "https://carpe-diem.xyz/api/operator/v1",
  fetch: async (url, init) => {
    const res = await fetch(url, init);
    console.log("x-carpe-cost-usdc-micro:", res.headers.get("x-carpe-cost-usdc-micro"));
    console.log("x-carpe-input-tokens:", res.headers.get("x-carpe-input-tokens"));
    console.log("x-carpe-output-tokens:", res.headers.get("x-carpe-output-tokens"));
    return res;
  },
});

const { text, usage, finishReason } = await generateText({
  model: carpe("deepseek-v4-1-flash"),
  prompt: "Reply with the exact word: pong",
  maxOutputTokens: 64,
});

console.log("text:", text);
console.log("finishReason:", finishReason);
console.log("usage:", JSON.stringify(usage));
node hello.mjs
Sortie obtenue :
x-carpe-cost-usdc-micro: 33
x-carpe-input-tokens: 1722
x-carpe-output-tokens: 4
text: pong
finishReason: stop
usage: {"inputTokens":1722,...,"outputTokens":4,...,"totalTokens":1726}
L'en-tête donne le coût en millionièmes de dollar : 33, soit 0,000033 $. C'est faible parce que 1 592 jetons d'entrée ont été lus en cache. Sans lecture en cache, le même appel coûte davantage. Ces 1 700 jetons d'entrée viennent du prompt système que Venice ajoute à chaque requête. Ajoutez venice_parameters.include_venice_system_prompt: false au corps de la requête pour ne pas le payer sur des appels courts et nombreux.
Pour changer de modèle, copiez un identifiant depuis /models et remplacez la chaîne passée à carpe("…"). Ni baseURL ni le fetch ne bougent.
Étape 4 : streamText, jeton par jeton
Avec includeUsage: true, le flux transporte les comptes de jetons, et c'est ce qui fait apparaître carpe_cost_usdc_micro dans usage.raw. Fichier stream.mjs :
import { createOpenAICompatible } from "@ai-sdk/openai-compatible";
import { streamText } from "ai";

const carpe = createOpenAICompatible({
  name: "carpe-diem",
  apiKey: process.env.OPENAI_API_KEY,
  baseURL: "https://carpe-diem.xyz/api/operator/v1",
  includeUsage: true,
});

const result = streamText({
  model: carpe("deepseek-v4-1-flash"),
  prompt: "Write a haiku about the sea.",
  maxOutputTokens: 128,
});

process.stdout.write("text: ");
for await (const part of result.textStream) {
  process.stdout.write(part);
}
process.stdout.write("\n");

const usage = await result.usage;
const finishReason = await result.finishReason;
console.log("finishReason:", finishReason);
console.log("usage:", JSON.stringify(usage));
node stream.mjs
Sortie obtenue :
text: Salt wind on my skin,
the tide pulls its slow breathing —
moonlight drowns in foam.
finishReason: stop
usage: {"inputTokens":1723,"outputTokens":119,"raw":{"prompt_tokens":1723,"completion_tokens":119,"carpe_cost_usdc_micro":393}}
Ce haiku a coûté environ 0,0004 $. Il a consommé 119 jetons de sortie pour une dizaine de mots, signe que le raisonnement mange une bonne part du plafond. Notez aussi que carpe_cost_usdc_micro se trouve dans usage.raw, pas au premier niveau de usage.
Étape 5 : la route /api/chat et la page de chat
La clé reste côté serveur : route.js ne part jamais dans le bundle du navigateur. Pour next dev, mettez-la dans .env.local :
OPENAI_API_KEY=cdm_your_key_here
npm install next@16.4.3 react@19.3.1 react-dom@19.3.1 @ai-sdk/react@4.0.161
Le fichier app/layout.js (App Router) :
export default function RootLayout({ children }) {
  return (
    <html lang="en">
      <body>{children}</body>
    </html>
  );
}
La route app/api/chat/route.js reçoit les messages de la page, les convertit et renvoie le flux. maxDuration = 30 limite la durée de la fonction sur Vercel, et 512 jetons de sortie laissent de la place au raisonnement.
import {
  convertToModelMessages,
  createUIMessageStreamResponse,
  streamText,
  toUIMessageStream,
} from "ai";
import { createOpenAICompatible } from "@ai-sdk/openai-compatible";

const carpe = createOpenAICompatible({
  name: "carpe-diem",
  apiKey: process.env.OPENAI_API_KEY,
  baseURL: "https://carpe-diem.xyz/api/operator/v1",
  includeUsage: true,
});

export const maxDuration = 30;

export async function POST(req) {
  const { messages } = await req.json();
  const result = streamText({
    model: carpe("deepseek-v4-1-flash"),
    messages: await convertToModelMessages(messages),
    maxOutputTokens: 512,
  });
  return createUIMessageStreamResponse({
    stream: toUIMessageStream({ stream: result.stream }),
  });
}
La page app/page.js : useChat poste sur /api/chat et affiche message.parts. Ces extraits sont en JavaScript ; la version TypeScript se trouve dans le guide officiel de l'AI SDK.
"use client";

import { useChat } from "@ai-sdk/react";
import { DefaultChatTransport } from "ai";
import { useState } from "react";

export default function Chat() {
  const { messages, sendMessage, status } = useChat({
    transport: new DefaultChatTransport({ api: "/api/chat" }),
  });
  const [input, setInput] = useState("");

  return (
    <div>
      {messages.map((message) => (
        <div key={message.id}>
          {message.role === "user" ? "User: " : "AI: "}
          {message.parts.map((part, i) =>
            part.type === "text" ? <span key={i}>{part.text}</span> : null,
          )}
        </div>
      ))}
      <form
        onSubmit={(e) => {
          e.preventDefault();
          if (input.trim()) {
            sendMessage({ text: input });
            setInput("");
          }
        }}
      >
        <input
          value={input}
          onChange={(e) => setInput(e.target.value)}
          disabled={status !== "ready"}
          placeholder="Say something..."
        />
        <button type="submit" disabled={status !== "ready"}>
          Send
        </button>
      </form>
    </div>
  );
}
Le champ status de useChat vaut ready, submitted, streaming ou error. Le bouton Send reste désactivé tant que ce n'est pas ready, et si la route lève une erreur (401, 400, 404 ou panne en cours de flux), status passe à error.
Lancez npx next dev, puis interrogez la route directement :
curl -sS -N http://localhost:3000/api/chat \
  -H "content-type: application/json" \
  -d '{"messages":[{"id":"1","role":"user","parts":[{"type":"text","text":"Reply with the exact word: pong"}]}]}'
Sortie du flux UI :
data: {"type":"start"}
data: {"type":"start-step"}
data: {"type":"text-start","id":"txt-0"}
data: {"type":"text-delta","id":"txt-0","delta":"p"}
data: {"type":"text-delta","id":"txt-0","delta":"ong"}
data: {"type":"text-end","id":"txt-0"}
data: {"type":"finish-step"}
data: {"type":"finish","finishReason":"stop"}
data: [DONE]
Le mot arrive en deux deltas, p puis ong, et useChat les concatène dans message.parts.
Si ça ne marche pas
401 Unauthorized. Avec OPENAI_API_KEY=cdm_invalid, l'AI SDK lève AI_APICallError: Unauthorized (code AUTH_REQUIRED). La clé est incomplète, mal copiée, ou la variable n'est pas exportée dans ce shell.
400 Bad Request. carpe("deepseek-v4-1-flash-typo") a renvoyé le message This model is no longer available upstream (code MODEL_ERROR). Vérifiez l'identifiant sur /models.
404 Not Found. baseURL ne se termine pas par /v1. Remettez-le.
Réponse vide, finishReason: length. Le raisonnement a consommé tout le plafond : augmentez maxOutputTokens.
Méthode : essai du 29 octobre 2026 avec ai@7.0.157 et Next.js 16.4.3, une exécution par extrait ; chaque script a tourné tel quel. Vision, outils et déploiement sur Vercel non testés.
Aller plus loin
Pour tester un modèle sans écrire de code, le Create Hub sert de bac à sable. Pour passer à autre chose que deepseek-v4-1-flash, il suffit de changer la chaîne dans carpe("…"). Créez une clé, lancez npx next dev et envoyez votre premier message depuis la page.