Vercel AI SDK: chat con streaming en Next.js sobre Carpe Diem
Tiene un dashboard Next.js y quiere que un usuario formule una pregunta y vea la respuesta escribirse en la página, palabra a palabra. El Vercel AI SDK es la caja de herramientas TypeScript que lo hace sin que usted escriba el HTTP ni el analizador SSE. Este tutorial lo apunta a Carpe Diem, desde la primera llamada en terminal hasta la página de chat.
Ilustración generada con seedream-v5-lite en Carpe Diem.
Lo que el SDK le ahorra
En el servidor, generateText devuelve un texto de una pieza y streamText un flujo token a token. En el navegador, el hook useChat mantiene la lista de mensajes, el estado de la petición y actualiza la burbuja con cada fragmento recibido.
En nuestra app, la página llama a useChat, que hace POST a una ruta /api/chat. La ruta llama a streamText, y createOpenAICompatible envía la petición a https://carpe-diem.xyz/api/operator/v1. Se cambia de modelo cambiando una cadena.
Lo hemos probado con deepseek-v4-1-flash. Un pong costó 0,000033 $ (1 592 tokens de entrada leídos en caché); un haiku en streaming, unos 0,0004 $.
Qué necesita
- Una cuenta Carpe Diem con créditos o una cuenta prepaid, y una clave
cdm_(pestaña API Keys del panel del comprador). - Node.js 22 y
npm.
Las versiones exactas están en los npm install más abajo. Sin Next.js, los dos scripts hello.mjs y stream.mjs bastan para una prueba en terminal. Para un script Python, el tutorial SDK OpenAI Python hace el mismo enlace con base_url.
Paso 1: crear una clave cdm_
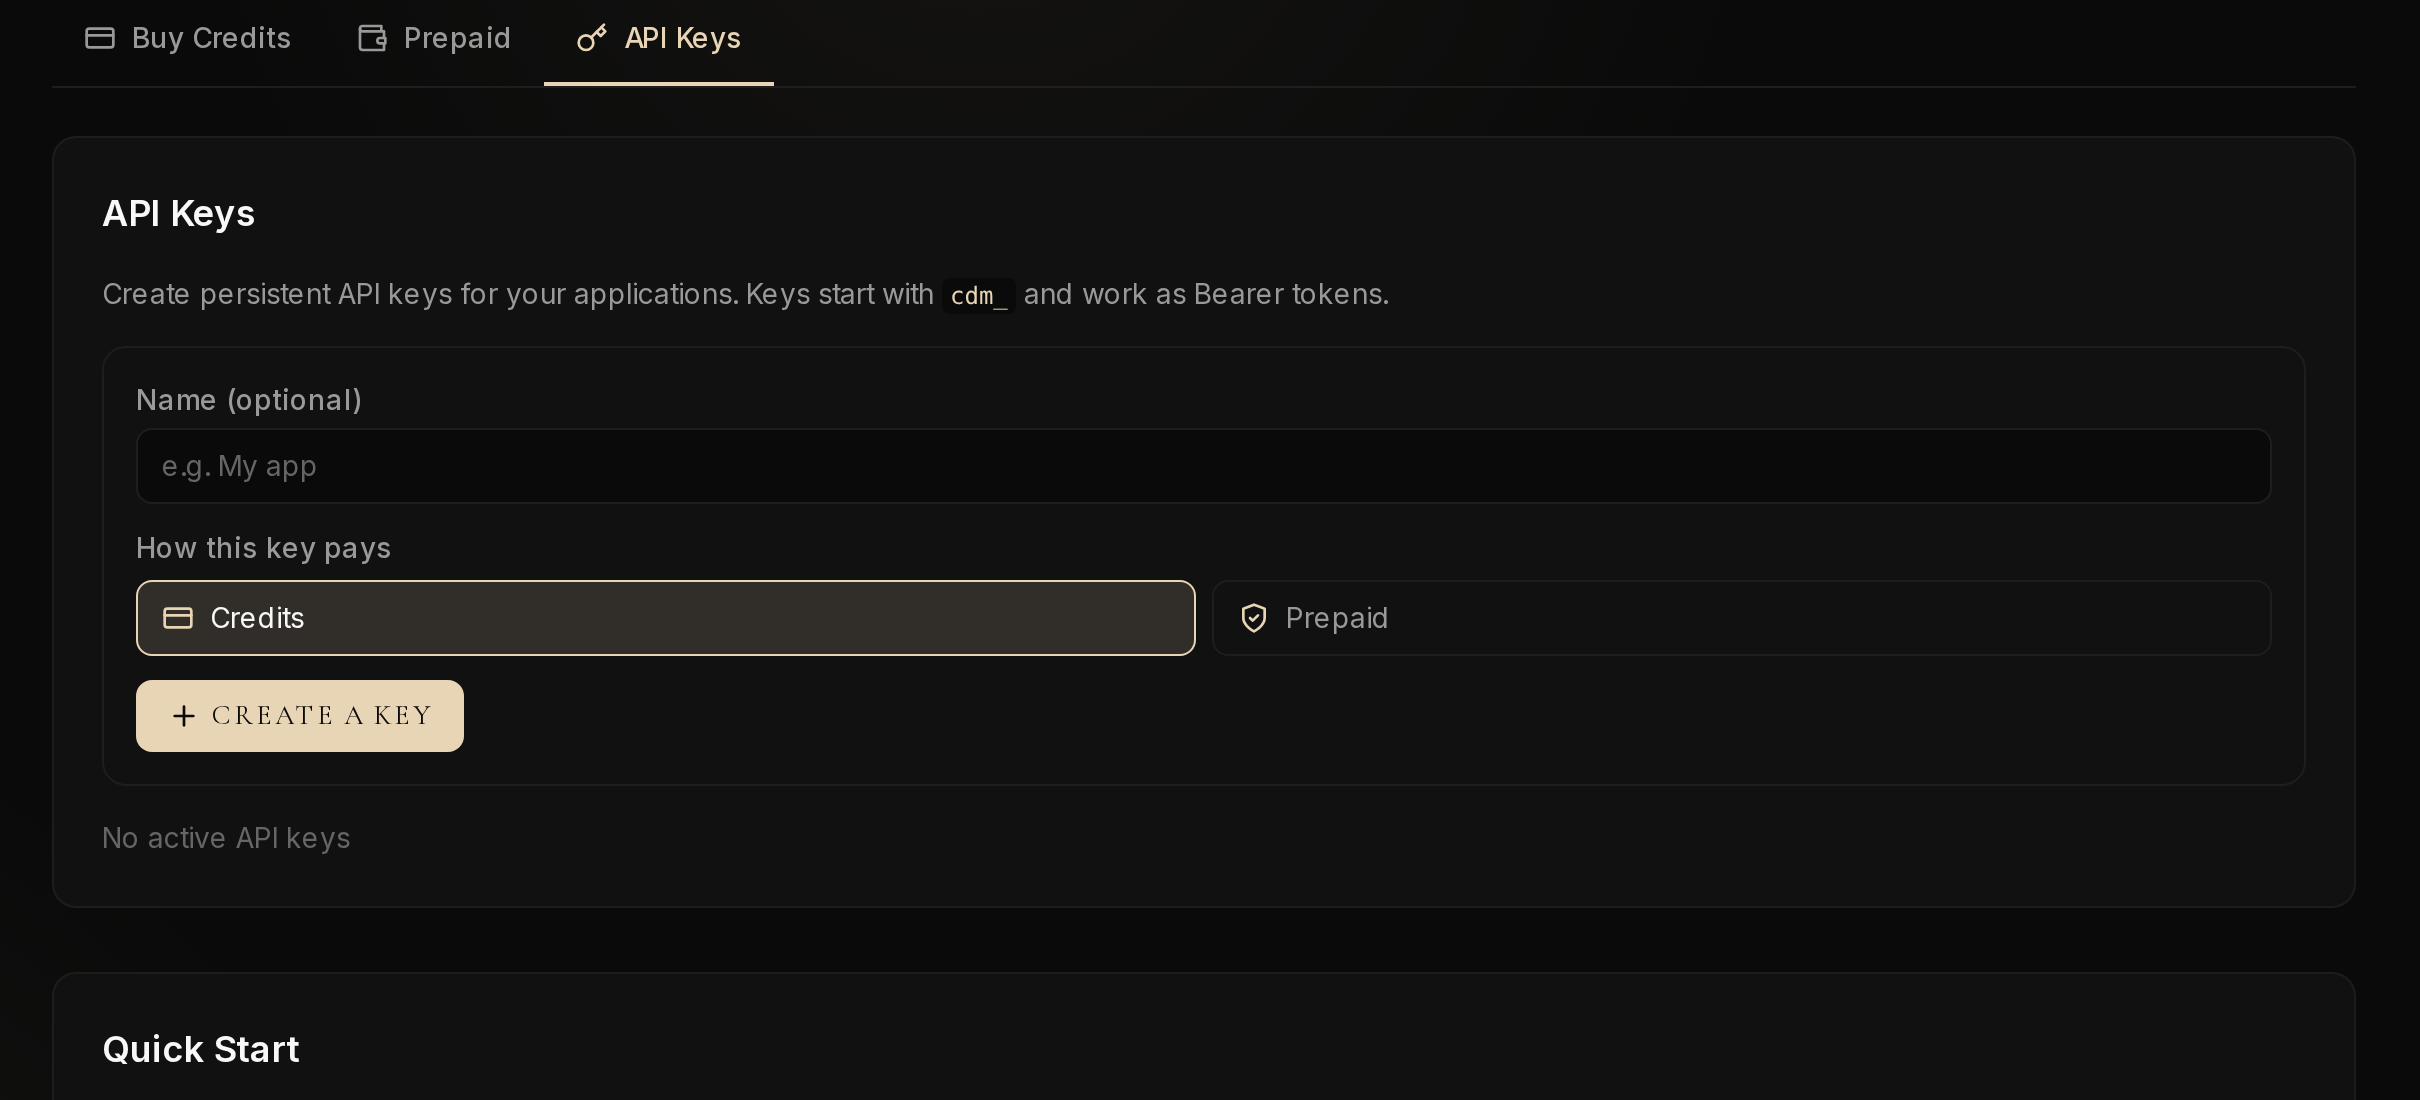
Abra Credits & keys, pestaña API Keys. Elija cómo paga la clave (Credits o Prepaid), póngale un nombre si quiere, luego pulse Create a key. Credits es un saldo de uso no retirable; Prepaid es una cuenta que usted posee y de la que puede retirar el saldo (detalle de los pagos).
La clave empieza por cdm_ y solo se muestra una vez: cópiela enseguida.
En el shell del tutorial:
export OPENAI_API_KEY=cdm_your_key_here
Paso 2: instalar el AI SDK y el provider compatible OpenAI
npm install ai@7.0.157 @ai-sdk/openai-compatible@3.0.81
createOpenAICompatible envía POST /chat/completions bajo baseURL. Para Carpe Diem, baseURL debe contener ya /v1: https://carpe-diem.xyz/api/operator/v1. Sin él, recibimos un 404 Not Found, como recuerda la guía SDK al inicio de la página.
Paso 3: una primera llamada con generateText, y su coste
Fuera del streaming, Carpe Diem escribe el coste en las cabeceras X-Carpe-*, no en el usage del SDK. El fetch personalizado de hello.mjs las lee al paso.
El techo maxOutputTokens: 64 bastó para pong. A 16, uno de nuestros pases solo devolvió razonamiento: texto vacío, finishReason: length. Deje margen, porque este modelo razona antes de responder.
import { createOpenAICompatible } from "@ai-sdk/openai-compatible";
import { generateText } from "ai";

const carpe = createOpenAICompatible({
  name: "carpe-diem",
  apiKey: process.env.OPENAI_API_KEY,
  baseURL: "https://carpe-diem.xyz/api/operator/v1",
  fetch: async (url, init) => {
    const res = await fetch(url, init);
    console.log("x-carpe-cost-usdc-micro:", res.headers.get("x-carpe-cost-usdc-micro"));
    console.log("x-carpe-input-tokens:", res.headers.get("x-carpe-input-tokens"));
    console.log("x-carpe-output-tokens:", res.headers.get("x-carpe-output-tokens"));
    return res;
  },
});

const { text, usage, finishReason } = await generateText({
  model: carpe("deepseek-v4-1-flash"),
  prompt: "Reply with the exact word: pong",
  maxOutputTokens: 64,
});

console.log("text:", text);
console.log("finishReason:", finishReason);
console.log("usage:", JSON.stringify(usage));
node hello.mjs
Salida obtenida:
x-carpe-cost-usdc-micro: 33
x-carpe-input-tokens: 1722
x-carpe-output-tokens: 4
text: pong
finishReason: stop
usage: {"inputTokens":1722,...,"outputTokens":4,...,"totalTokens":1726}
La cabecera da el coste en millonésimas de dólar: 33, es decir 0,000033 $. Es bajo porque 1 592 tokens de entrada se leyeron en caché. Sin lectura en caché, la misma llamada cuesta más. Esos 1 700 tokens de entrada vienen del prompt de sistema que Venice añade a cada petición. Añada venice_parameters.include_venice_system_prompt: false al cuerpo de la petición para no pagarlo en llamadas cortas y numerosas.
Para cambiar de modelo, copie un identificador desde /models y sustituya la cadena pasada a carpe("…"). Ni baseURL ni el fetch se mueven.
Paso 4: streamText, token a token
Con includeUsage: true, el flujo transporta los recuentos de tokens, y eso es lo que hace aparecer carpe_cost_usdc_micro en usage.raw. Archivo stream.mjs:
import { createOpenAICompatible } from "@ai-sdk/openai-compatible";
import { streamText } from "ai";

const carpe = createOpenAICompatible({
  name: "carpe-diem",
  apiKey: process.env.OPENAI_API_KEY,
  baseURL: "https://carpe-diem.xyz/api/operator/v1",
  includeUsage: true,
});

const result = streamText({
  model: carpe("deepseek-v4-1-flash"),
  prompt: "Write a haiku about the sea.",
  maxOutputTokens: 128,
});

process.stdout.write("text: ");
for await (const part of result.textStream) {
  process.stdout.write(part);
}
process.stdout.write("\n");

const usage = await result.usage;
const finishReason = await result.finishReason;
console.log("finishReason:", finishReason);
console.log("usage:", JSON.stringify(usage));
node stream.mjs
Salida obtenida:
text: Salt wind on my skin,
the tide pulls its slow breathing —
moonlight drowns in foam.
finishReason: stop
usage: {"inputTokens":1723,"outputTokens":119,"raw":{"prompt_tokens":1723,"completion_tokens":119,"carpe_cost_usdc_micro":393}}
Este haiku costó unos 0,0004 $. Consumió 119 tokens de salida para una decena de palabras: el razonamiento se come buena parte del techo. Note también que carpe_cost_usdc_micro está en usage.raw, no en el primer nivel de usage.
Paso 5: la ruta /api/chat y la página de chat
La clave se queda en el servidor: route.js no entra nunca en el bundle del navegador. Para next dev, póngala en .env.local:
OPENAI_API_KEY=cdm_your_key_here
npm install next@16.4.3 react@19.3.1 react-dom@19.3.1 @ai-sdk/react@4.0.161
El archivo app/layout.js (App Router):
export default function RootLayout({ children }) {
  return (
    <html lang="en">
      <body>{children}</body>
    </html>
  );
}
La ruta app/api/chat/route.js recibe los mensajes de la página, los convierte y devuelve el flujo. maxDuration = 30 limita la duración de la función en Vercel, y 512 tokens de salida dejan sitio al razonamiento.
import {
  convertToModelMessages,
  createUIMessageStreamResponse,
  streamText,
  toUIMessageStream,
} from "ai";
import { createOpenAICompatible } from "@ai-sdk/openai-compatible";

const carpe = createOpenAICompatible({
  name: "carpe-diem",
  apiKey: process.env.OPENAI_API_KEY,
  baseURL: "https://carpe-diem.xyz/api/operator/v1",
  includeUsage: true,
});

export const maxDuration = 30;

export async function POST(req) {
  const { messages } = await req.json();
  const result = streamText({
    model: carpe("deepseek-v4-1-flash"),
    messages: await convertToModelMessages(messages),
    maxOutputTokens: 512,
  });
  return createUIMessageStreamResponse({
    stream: toUIMessageStream({ stream: result.stream }),
  });
}
La página app/page.js: useChat publica en /api/chat y muestra message.parts. Estos extractos están en JavaScript; la versión TypeScript está en la guía oficial del AI SDK.
"use client";

import { useChat } from "@ai-sdk/react";
import { DefaultChatTransport } from "ai";
import { useState } from "react";

export default function Chat() {
  const { messages, sendMessage, status } = useChat({
    transport: new DefaultChatTransport({ api: "/api/chat" }),
  });
  const [input, setInput] = useState("");

  return (
    <div>
      {messages.map((message) => (
        <div key={message.id}>
          {message.role === "user" ? "User: " : "AI: "}
          {message.parts.map((part, i) =>
            part.type === "text" ? <span key={i}>{part.text}</span> : null,
          )}
        </div>
      ))}
      <form
        onSubmit={(e) => {
          e.preventDefault();
          if (input.trim()) {
            sendMessage({ text: input });
            setInput("");
          }
        }}
      >
        <input
          value={input}
          onChange={(e) => setInput(e.target.value)}
          disabled={status !== "ready"}
          placeholder="Say something..."
        />
        <button type="submit" disabled={status !== "ready"}>
          Send
        </button>
      </form>
    </div>
  );
}
El campo status de useChat vale ready, submitted, streaming o error. El botón Send permanece desactivado mientras no sea ready, y si la ruta lanza un error (401, 400, 404 o un corte a mitad de flujo), status pasa a error.
Lance npx next dev y luego interrogue la ruta directamente:
curl -sS -N http://localhost:3000/api/chat \
  -H "content-type: application/json" \
  -d '{"messages":[{"id":"1","role":"user","parts":[{"type":"text","text":"Reply with the exact word: pong"}]}]}'
Salida del flujo UI:
data: {"type":"start"}
data: {"type":"start-step"}
data: {"type":"text-start","id":"txt-0"}
data: {"type":"text-delta","id":"txt-0","delta":"p"}
data: {"type":"text-delta","id":"txt-0","delta":"ong"}
data: {"type":"text-end","id":"txt-0"}
data: {"type":"finish-step"}
data: {"type":"finish","finishReason":"stop"}
data: [DONE]
La palabra llega en dos deltas, p y luego ong, y useChat los concatena en message.parts.
Si no funciona
401 Unauthorized. Con OPENAI_API_KEY=cdm_invalid, el AI SDK lanza AI_APICallError: Unauthorized (código AUTH_REQUIRED). La clave está incompleta, mal copiada, o la variable no está exportada en ese shell.
400 Bad Request. carpe("deepseek-v4-1-flash-typo") devolvió el mensaje This model is no longer available upstream (código MODEL_ERROR). Compruebe el identificador en /models.
404 Not Found. baseURL no termina en /v1. Vuelva a ponerlo.
Respuesta vacía, finishReason: length. El razonamiento ha consumido el techo entero: suba maxOutputTokens.
Ensayo del 29 octubre 2026 con ai@7.0.157 y Next.js 16.4.3, una ejecución por extracto; cada script corrió tal cual. Visión, herramientas y despliegue en Vercel no probados.
Seguir
Para probar un modelo sin escribir código, el Create Hub sirve de banco de pruebas. Para pasar a algo distinto de deepseek-v4-1-flash, basta con cambiar la cadena en carpe("…"). Cree una clave, lance npx next dev y envíe su primer mensaje desde la página.