Vercel AI SDK: chat com streaming em Next.js no Carpe Diem
Tem um dashboard Next.js e quer que um utilizador faça uma pergunta e veja a resposta escrever-se na página, palavra a palavra. O Vercel AI SDK é a caixa de ferramentas TypeScript que faz isso sem escrever o HTTP nem o analisador SSE. Este tutorial aponta-o para o Carpe Diem, da primeira chamada no terminal até à página de chat.
Ilustração gerada com seedream-v5-lite no Carpe Diem.
O que o SDK lhe poupa
No servidor, generateText devolve um texto de uma só vez e streamText um fluxo token a token. No navegador, o hook useChat mantém a lista de mensagens, o estado do pedido e actualiza a bolha a cada fragmento recebido.
Na nossa app, a página chama useChat, que faz POST para uma rota /api/chat. A rota chama streamText, e createOpenAICompatible envia o pedido para https://carpe-diem.xyz/api/operator/v1. Muda de modelo ao mudar uma cadeia.
Ensaiámo-lo com deepseek-v4-1-flash. Um pong custou 0,000033 $ (1 592 tokens de entrada lidos em cache); um haiku em streaming, cerca de 0,0004 $.
O que precisa
- Uma conta Carpe Diem com créditos ou uma conta prepaid, e uma chave
cdm_(separador API Keys do painel do comprador). - Node.js 22 e
npm.
As versões exactas estão nos npm install mais abaixo. Sem Next.js, os dois scripts hello.mjs e stream.mjs chegam para um ensaio no terminal. Para um script Python, o tutorial SDK OpenAI Python faz a mesma ligação com base_url.
Passo 1: criar uma chave cdm_
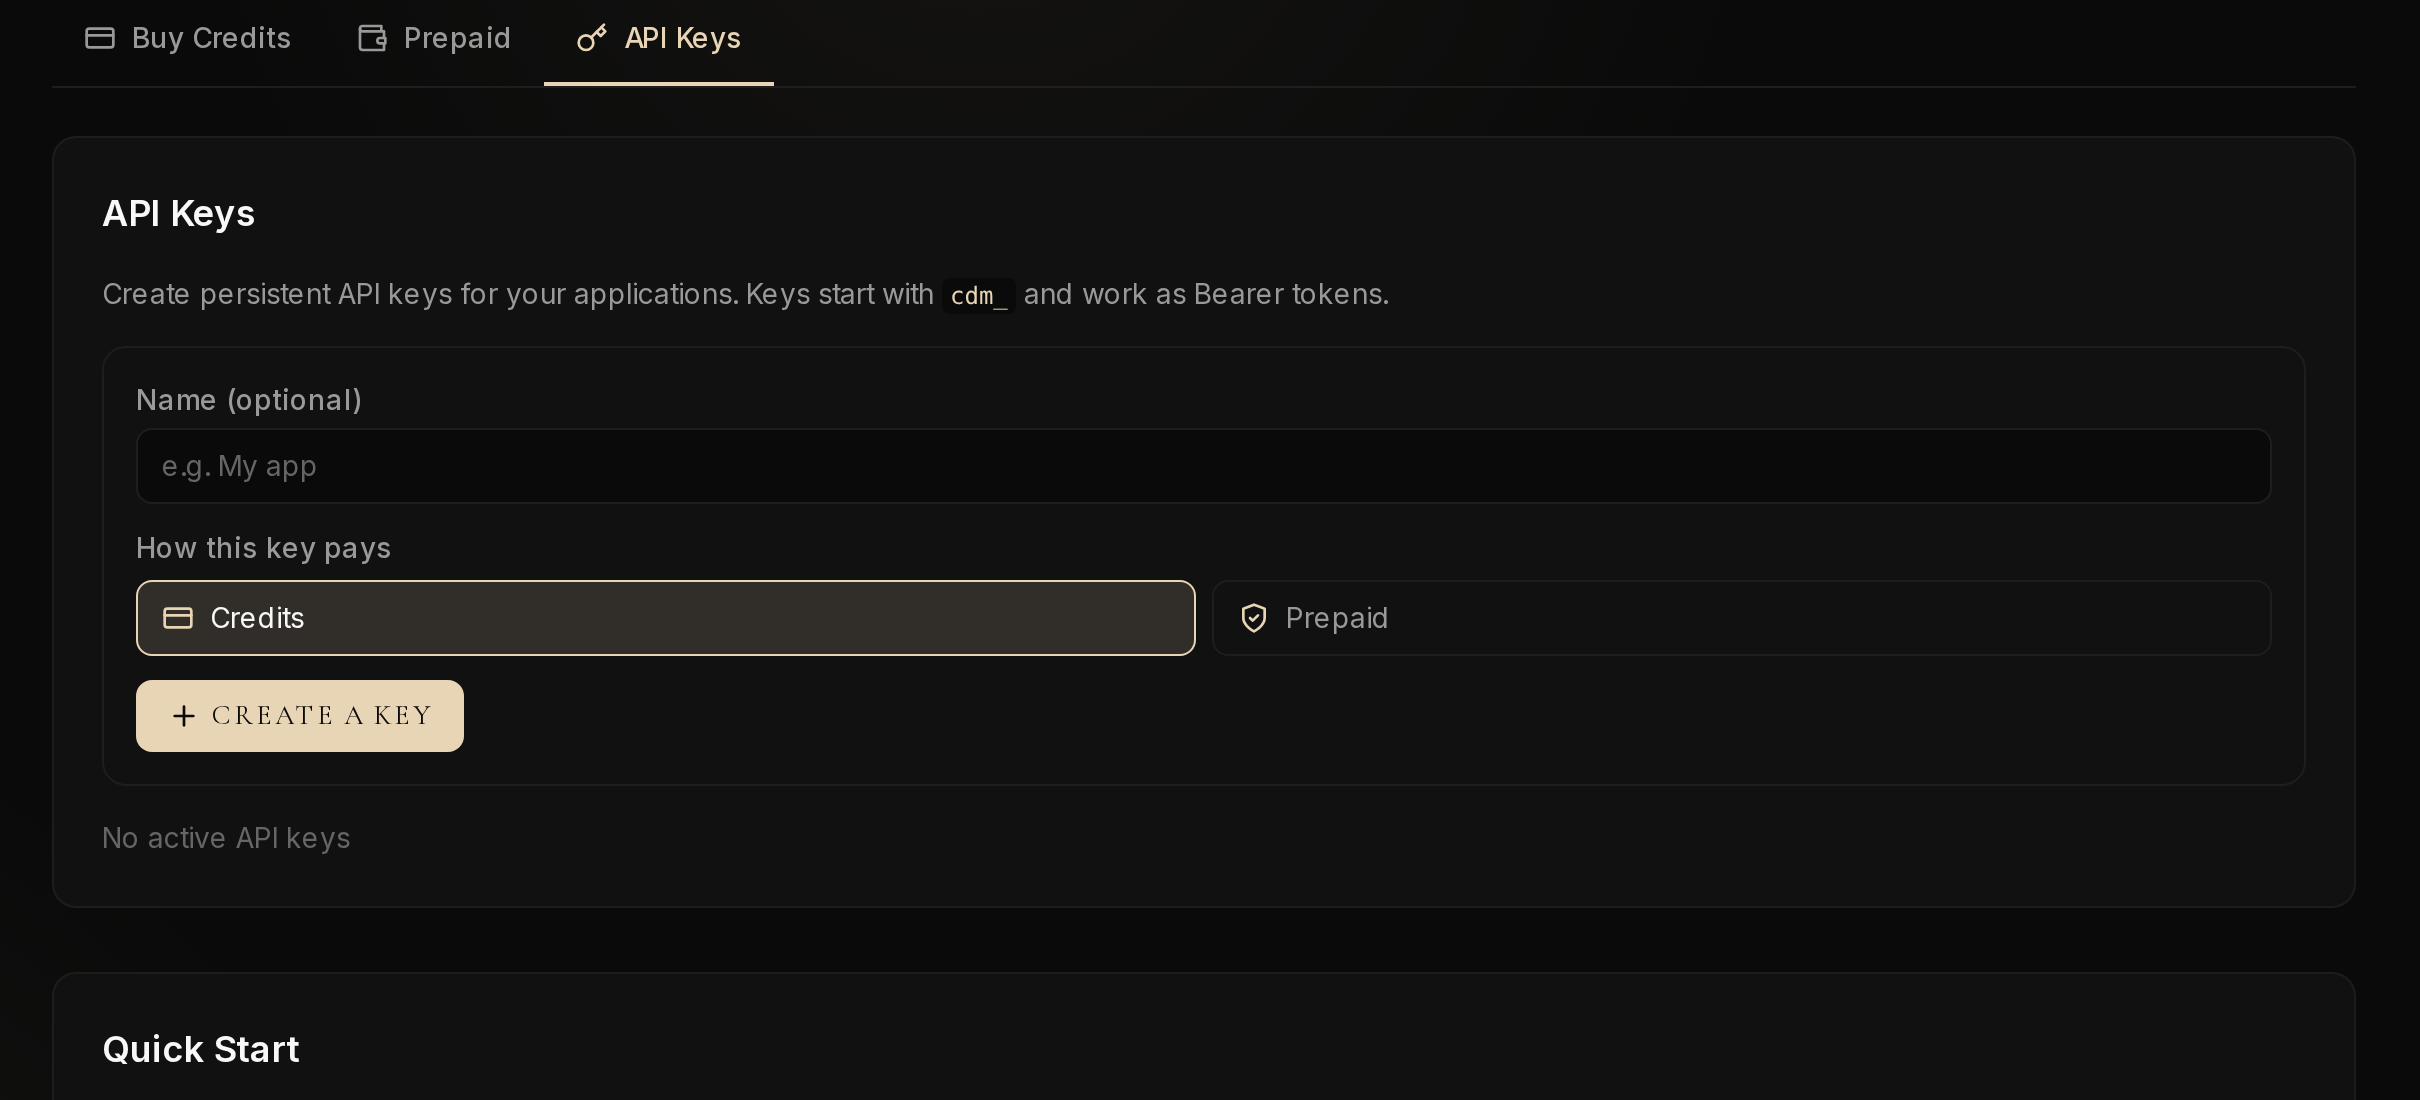
Abra Credits & keys, separador API Keys. Escolha como a chave paga (Credits ou Prepaid), dê-lhe eventualmente um nome e clique em Create a key. Credits é um saldo de uso não levantável; Prepaid é uma conta que detém e da qual pode levantar o saldo (detalhe dos pagamentos).
A chave começa por cdm_ e só se mostra uma vez: copie-a de imediato.
No shell do tutorial:
export OPENAI_API_KEY=cdm_your_key_here
Passo 2: instalar o AI SDK e o provider compatível OpenAI
npm install ai@7.0.157 @ai-sdk/openai-compatible@3.0.81
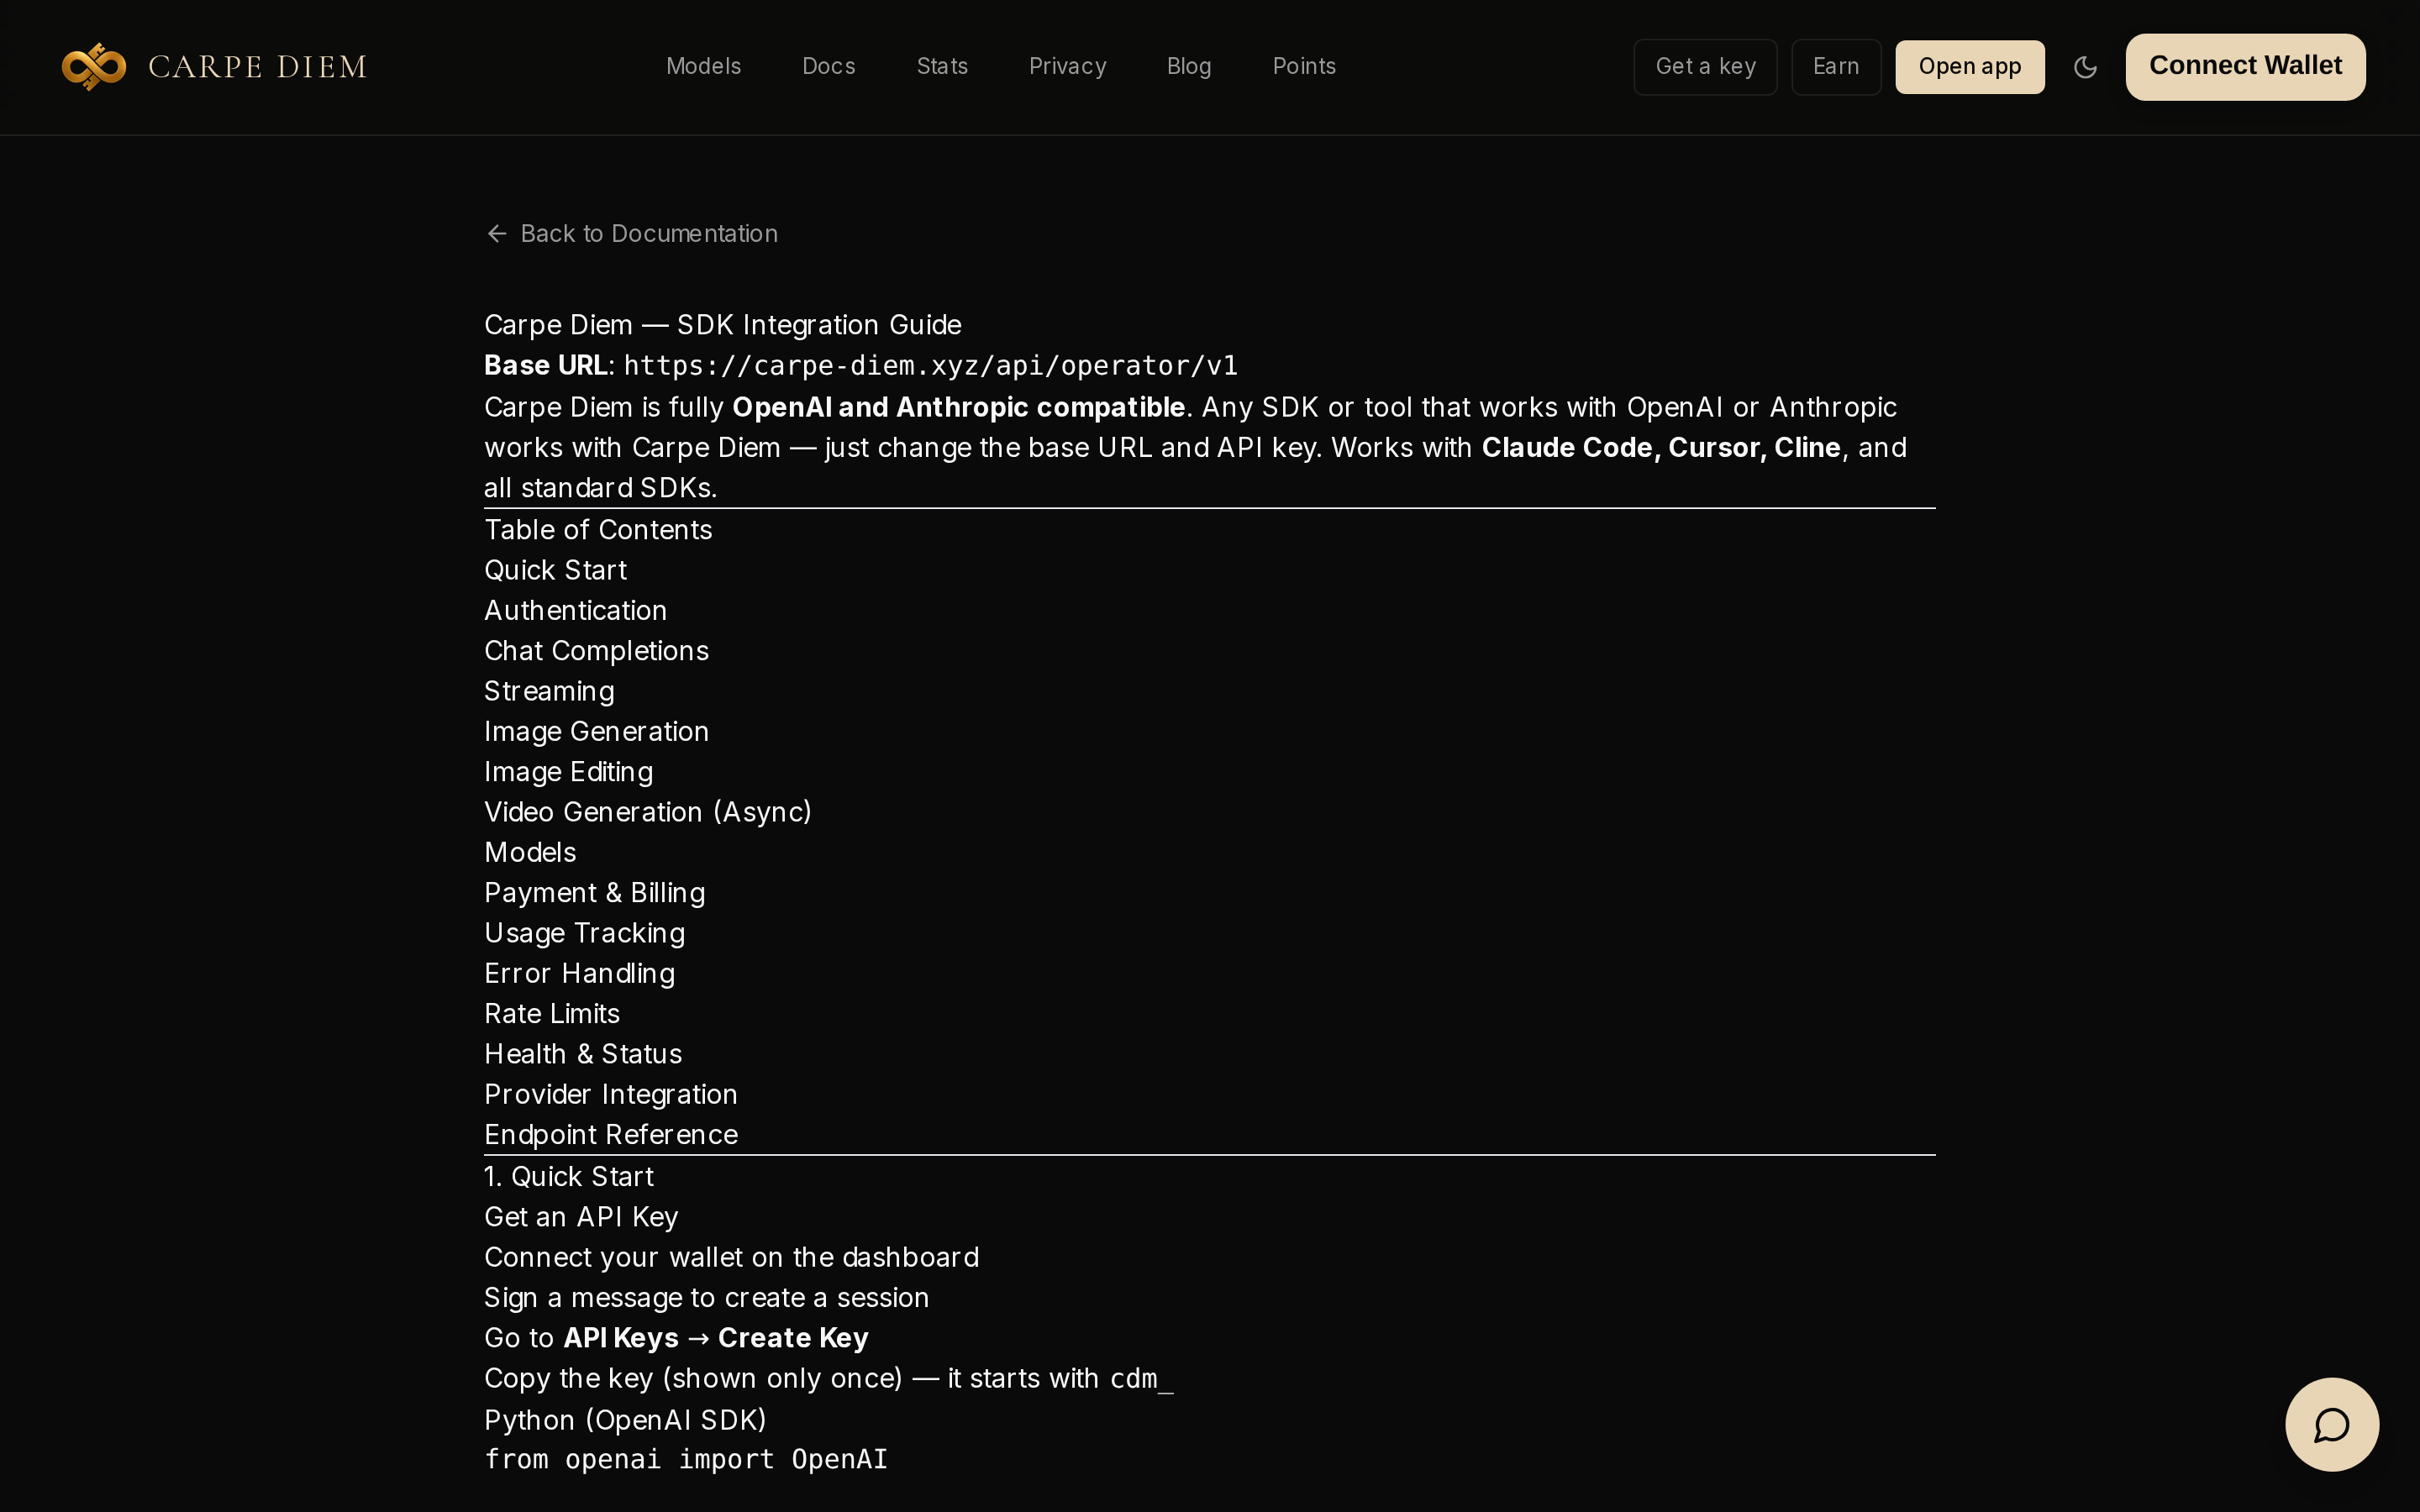
createOpenAICompatible envia POST /chat/completions sob baseURL. Para o Carpe Diem, baseURL já deve conter /v1: https://carpe-diem.xyz/api/operator/v1. Sem ele, recebemos um 404 Not Found, como recorda o guia SDK no topo da página.
Passo 3: uma primeira chamada com generateText, e o seu custo
Fora do streaming, o Carpe Diem escreve o custo nos cabeçalhos X-Carpe-*, não no usage do SDK. O fetch personalizado de hello.mjs lê-os de passagem.
O tecto maxOutputTokens: 64 chegou para pong. A 16, uma das nossas passagens só devolveu raciocínio: texto vazio, finishReason: length. Deixe margem, porque este modelo raciocina antes de responder.
import { createOpenAICompatible } from "@ai-sdk/openai-compatible";
import { generateText } from "ai";

const carpe = createOpenAICompatible({
  name: "carpe-diem",
  apiKey: process.env.OPENAI_API_KEY,
  baseURL: "https://carpe-diem.xyz/api/operator/v1",
  fetch: async (url, init) => {
    const res = await fetch(url, init);
    console.log("x-carpe-cost-usdc-micro:", res.headers.get("x-carpe-cost-usdc-micro"));
    console.log("x-carpe-input-tokens:", res.headers.get("x-carpe-input-tokens"));
    console.log("x-carpe-output-tokens:", res.headers.get("x-carpe-output-tokens"));
    return res;
  },
});

const { text, usage, finishReason } = await generateText({
  model: carpe("deepseek-v4-1-flash"),
  prompt: "Reply with the exact word: pong",
  maxOutputTokens: 64,
});

console.log("text:", text);
console.log("finishReason:", finishReason);
console.log("usage:", JSON.stringify(usage));
node hello.mjs
Saída obtida:
x-carpe-cost-usdc-micro: 33
x-carpe-input-tokens: 1722
x-carpe-output-tokens: 4
text: pong
finishReason: stop
usage: {"inputTokens":1722,...,"outputTokens":4,...,"totalTokens":1726}
O cabeçalho dá o custo em milionésimos de dólar: 33, ou seja 0,000033 $. É baixo porque 1 592 tokens de entrada foram lidos em cache. Sem leitura em cache, a mesma chamada custa mais. Esses 1 700 tokens de entrada vêm do prompt de sistema que a Venice acrescenta a cada pedido. Acrescente venice_parameters.include_venice_system_prompt: false ao corpo do pedido para não o pagar em chamadas curtas e numerosas.
Para mudar de modelo, copie um identificador em /models e substitua a cadeia passada a carpe("…"). Nem baseURL nem o fetch se mexem.
Passo 4: streamText, token a token
Com includeUsage: true, o fluxo transporta as contagens de tokens, e é isso que faz aparecer carpe_cost_usdc_micro em usage.raw. Ficheiro stream.mjs:
import { createOpenAICompatible } from "@ai-sdk/openai-compatible";
import { streamText } from "ai";

const carpe = createOpenAICompatible({
  name: "carpe-diem",
  apiKey: process.env.OPENAI_API_KEY,
  baseURL: "https://carpe-diem.xyz/api/operator/v1",
  includeUsage: true,
});

const result = streamText({
  model: carpe("deepseek-v4-1-flash"),
  prompt: "Write a haiku about the sea.",
  maxOutputTokens: 128,
});

process.stdout.write("text: ");
for await (const part of result.textStream) {
  process.stdout.write(part);
}
process.stdout.write("\n");

const usage = await result.usage;
const finishReason = await result.finishReason;
console.log("finishReason:", finishReason);
console.log("usage:", JSON.stringify(usage));
node stream.mjs
Saída obtida:
text: Salt wind on my skin,
the tide pulls its slow breathing —
moonlight drowns in foam.
finishReason: stop
usage: {"inputTokens":1723,"outputTokens":119,"raw":{"prompt_tokens":1723,"completion_tokens":119,"carpe_cost_usdc_micro":393}}
Este haiku custou cerca de 0,0004 $. Consumiu 119 tokens de saída para uma dezena de palavras: o raciocínio come uma boa parte do tecto. Note também que carpe_cost_usdc_micro está em usage.raw, não no primeiro nível de usage.
Passo 5: a rota /api/chat e a página de chat
A chave fica no servidor: route.js nunca vai para o bundle do navegador. Para next dev, ponha-a em .env.local:
OPENAI_API_KEY=cdm_your_key_here
npm install next@16.4.3 react@19.3.1 react-dom@19.3.1 @ai-sdk/react@4.0.161
O ficheiro app/layout.js (App Router):
export default function RootLayout({ children }) {
  return (
    <html lang="en">
      <body>{children}</body>
    </html>
  );
}
A rota app/api/chat/route.js recebe as mensagens da página, converte-as e devolve o fluxo. maxDuration = 30 limita a duração da função no Vercel, e 512 tokens de saída deixam sítio ao raciocínio.
import {
  convertToModelMessages,
  createUIMessageStreamResponse,
  streamText,
  toUIMessageStream,
} from "ai";
import { createOpenAICompatible } from "@ai-sdk/openai-compatible";

const carpe = createOpenAICompatible({
  name: "carpe-diem",
  apiKey: process.env.OPENAI_API_KEY,
  baseURL: "https://carpe-diem.xyz/api/operator/v1",
  includeUsage: true,
});

export const maxDuration = 30;

export async function POST(req) {
  const { messages } = await req.json();
  const result = streamText({
    model: carpe("deepseek-v4-1-flash"),
    messages: await convertToModelMessages(messages),
    maxOutputTokens: 512,
  });
  return createUIMessageStreamResponse({
    stream: toUIMessageStream({ stream: result.stream }),
  });
}
A página app/page.js: useChat envia um POST para /api/chat e mostra message.parts. Estes extractos estão em JavaScript; a versão TypeScript está no guia oficial do AI SDK.
"use client";

import { useChat } from "@ai-sdk/react";
import { DefaultChatTransport } from "ai";
import { useState } from "react";

export default function Chat() {
  const { messages, sendMessage, status } = useChat({
    transport: new DefaultChatTransport({ api: "/api/chat" }),
  });
  const [input, setInput] = useState("");

  return (
    <div>
      {messages.map((message) => (
        <div key={message.id}>
          {message.role === "user" ? "User: " : "AI: "}
          {message.parts.map((part, i) =>
            part.type === "text" ? <span key={i}>{part.text}</span> : null,
          )}
        </div>
      ))}
      <form
        onSubmit={(e) => {
          e.preventDefault();
          if (input.trim()) {
            sendMessage({ text: input });
            setInput("");
          }
        }}
      >
        <input
          value={input}
          onChange={(e) => setInput(e.target.value)}
          disabled={status !== "ready"}
          placeholder="Say something..."
        />
        <button type="submit" disabled={status !== "ready"}>
          Send
        </button>
      </form>
    </div>
  );
}
O campo status de useChat vale ready, submitted, streaming ou error. O botão Send fica desactivado enquanto não for ready, e se a rota lançar um erro (401, 400, 404 ou uma falha a meio do fluxo), status passa a error.
Lance npx next dev e depois interrogue a rota directamente:
curl -sS -N http://localhost:3000/api/chat \
  -H "content-type: application/json" \
  -d '{"messages":[{"id":"1","role":"user","parts":[{"type":"text","text":"Reply with the exact word: pong"}]}]}'
Saída do fluxo UI:
data: {"type":"start"}
data: {"type":"start-step"}
data: {"type":"text-start","id":"txt-0"}
data: {"type":"text-delta","id":"txt-0","delta":"p"}
data: {"type":"text-delta","id":"txt-0","delta":"ong"}
data: {"type":"text-end","id":"txt-0"}
data: {"type":"finish-step"}
data: {"type":"finish","finishReason":"stop"}
data: [DONE]
A palavra chega em dois deltas, p e depois ong, e useChat concatena-os em message.parts.
Se não funcionar
401 Unauthorized. Com OPENAI_API_KEY=cdm_invalid, o AI SDK lança AI_APICallError: Unauthorized (código AUTH_REQUIRED). A chave está incompleta, mal copiada, ou a variável não está exportada nesse shell.
400 Bad Request. carpe("deepseek-v4-1-flash-typo") devolveu a mensagem This model is no longer available upstream (código MODEL_ERROR). Verifique o identificador em /models.
404 Not Found. baseURL não termina em /v1. Volte a pô-lo.
Resposta vazia, finishReason: length. O raciocínio consumiu o tecto inteiro: aumente maxOutputTokens.
Ensaio de 29 outubro 2026 com ai@7.0.157 e Next.js 16.4.3, uma execução por extracto; cada script correu tal qual. Visão, ferramentas e implantação no Vercel não testados.
Ir mais longe
Para ensaiar um modelo sem escrever código, o Create Hub serve de caixa de areia. Para passar a outra coisa que não deepseek-v4-1-flash, basta mudar a cadeia em carpe("…"). Crie uma chave, lance npx next dev e envie a primeira mensagem a partir da página.