Mercury 3, LLM de difusión: 54 % bajo Venice en Carpe Diem
Inception publicó Mercury 3 el 19 de octubre de 2026. Al día siguiente, el identificador mercury-3 estaba en el catálogo de Carpe Diem. Es un LLM de difusión: los tokens se refinan en paralelo, no uno a uno. Nuestro banco de pruebas validó el razonamiento, la extracción JSON y una aguja en 2 500 palabras. En las pruebas puntuadas medimos 78 a 387 tokens/s de extremo a extremo, latencia incluida. No es comparable con los 1 068 tokens/s de decodificación pura anunciados por Inception.
Ilustración generada con seedream-v5-lite en Carpe Diem.
Qué hace Mercury 3 y qué hemos probado
Mercury 3 es un modelo de texto de Inception Labs, sin imagen ni audio de entrada, con 1 000 000 tokens de contexto. La llamada sigue siendo un chat/completions clásico: el refinamiento en paralelo ocurre en el servidor, no en el cuerpo de la petición. El catálogo le atribuye razonamiento, esfuerzo de razonamiento, llamadas a funciones, esquema de respuesta y búsqueda web. Hemos visto el razonamiento y un JSON conforme; no hemos probado las llamadas a funciones ni la búsqueda web.
La confidencialidad es anonymized: Venice, proveedor de inferencia aguas arriba, transmite el contenido al fabricante sin pegarle su identidad, a diferencia de un modelo private como Llama 3.3 70B. El detalle está en la página de privacidad.
0,0464 $ / 0,1625 $ el millón, 54 % bajo Venice
Carpe Diem revende la inferencia de Mercury 3 a través de Venice, de ahí la comparación con la tarifa pública de Venice.
| Entrada / M tokens | Salida / M tokens | |
|---|---|---|
| Carpe Diem | 0,0464 $ | 0,1625 $ |
| Venice | 0,1000 $ | 0,3500 $ |
Inception publica 0,20 $ / 0,70 $ en lista y, en el lanzamiento, 0,10 $ / 0,35 $ (un 50 % menos). Venice muestra esa tarifa de lanzamiento. Los precios Carpe Diem de la tabla son los del banco del 20 de octubre de 2026; el catálogo puede moverse. A esa tarifa, 1 000 tokens de entrada y 1 000 de salida cuestan 0,00021 $; en Venice, 0,00045 $. Mil peticiones de ese calibre: 0,21 $ frente a 0,45 $.
Llama 3.3 70B, propuesto por defecto en Chat, está a 0,3032 $ / 1,2127 $ el millón, con 128 000 tokens de contexto e inferencia private. MiniMax M3.1 Flash (minimax-m3-1-flash) está a 0,0812 $ / 0,3248 $ el millón, con visión. No lo hemos pasado por el banco. Ambos siguen siendo más caros en entrada y salida que Mercury 3.
Nuestras medidas del 20 de octubre de 2026
El banco de pruebas debitó 0,00053 $ en total. Los tokens/s de la tabla son los tokens de salida divididos por la duración total de la llamada, latencia de red incluida: sobre 83 tokens de salida, 78 tokens/s dicen principalmente que la llamada duró 1,1 s, no que la decodificación sea lenta. No hemos medido el tiempo hasta el primer token.
| Prueba | Resultado | Duración | Tokens/s | Coste |
|---|---|---|---|---|
| Razonamiento (respuesta única) | OK, 40000 | 2,4 s | 387 | 0,00018 $ |
| Extracción JSON | conforme | 1,1 s | 78 | 0,00004 $ |
| Aguja (~2 500 palabras) | encontrada | 1,5 s | 132 | 0,00008 $ |
| Redacción en francés | no puntuada (juzgada a la lectura) | 1,6 s | 228 | 0,00008 $ |
En el razonamiento pedíamos el umbral en el que una tarifa plana de 12 $ más 0,40 $ las mil peticiones resulta estrictamente más barato que 0,70 $ las mil. Con r en miles de peticiones al mes, el modelo planteó 12 + 0,40r < 0,70r, luego r > 40, y respondió 40000, la cifra esperada. Esa llamada facturó 944 tokens de salida por unas pocas líneas visibles.
La salida JSON devolvió vendor, amount_usdc 42.50, date 2026-03-03 y las dos líneas de artículos, sin campo de más.
En francés, el texto tutea al lector y sigue siendo genérico. El código no se ha puntuado.
Cuándo merece la pena Mercury 3
Lo elegiríamos para extracción JSON a bajo coste: un ensayo único fue conforme en 1,1 s, debitado 0,00004 $. Valide con sus propios documentos antes de pasar a volumen. El razonamiento corto (umbral tarifario) acertó en 2,4 s.
Evítelo si necesita un modelo private o imagen de entrada. Llama 3.3 70B sigue siendo la opción por defecto del estudio Chat, con 128 000 tokens de contexto.
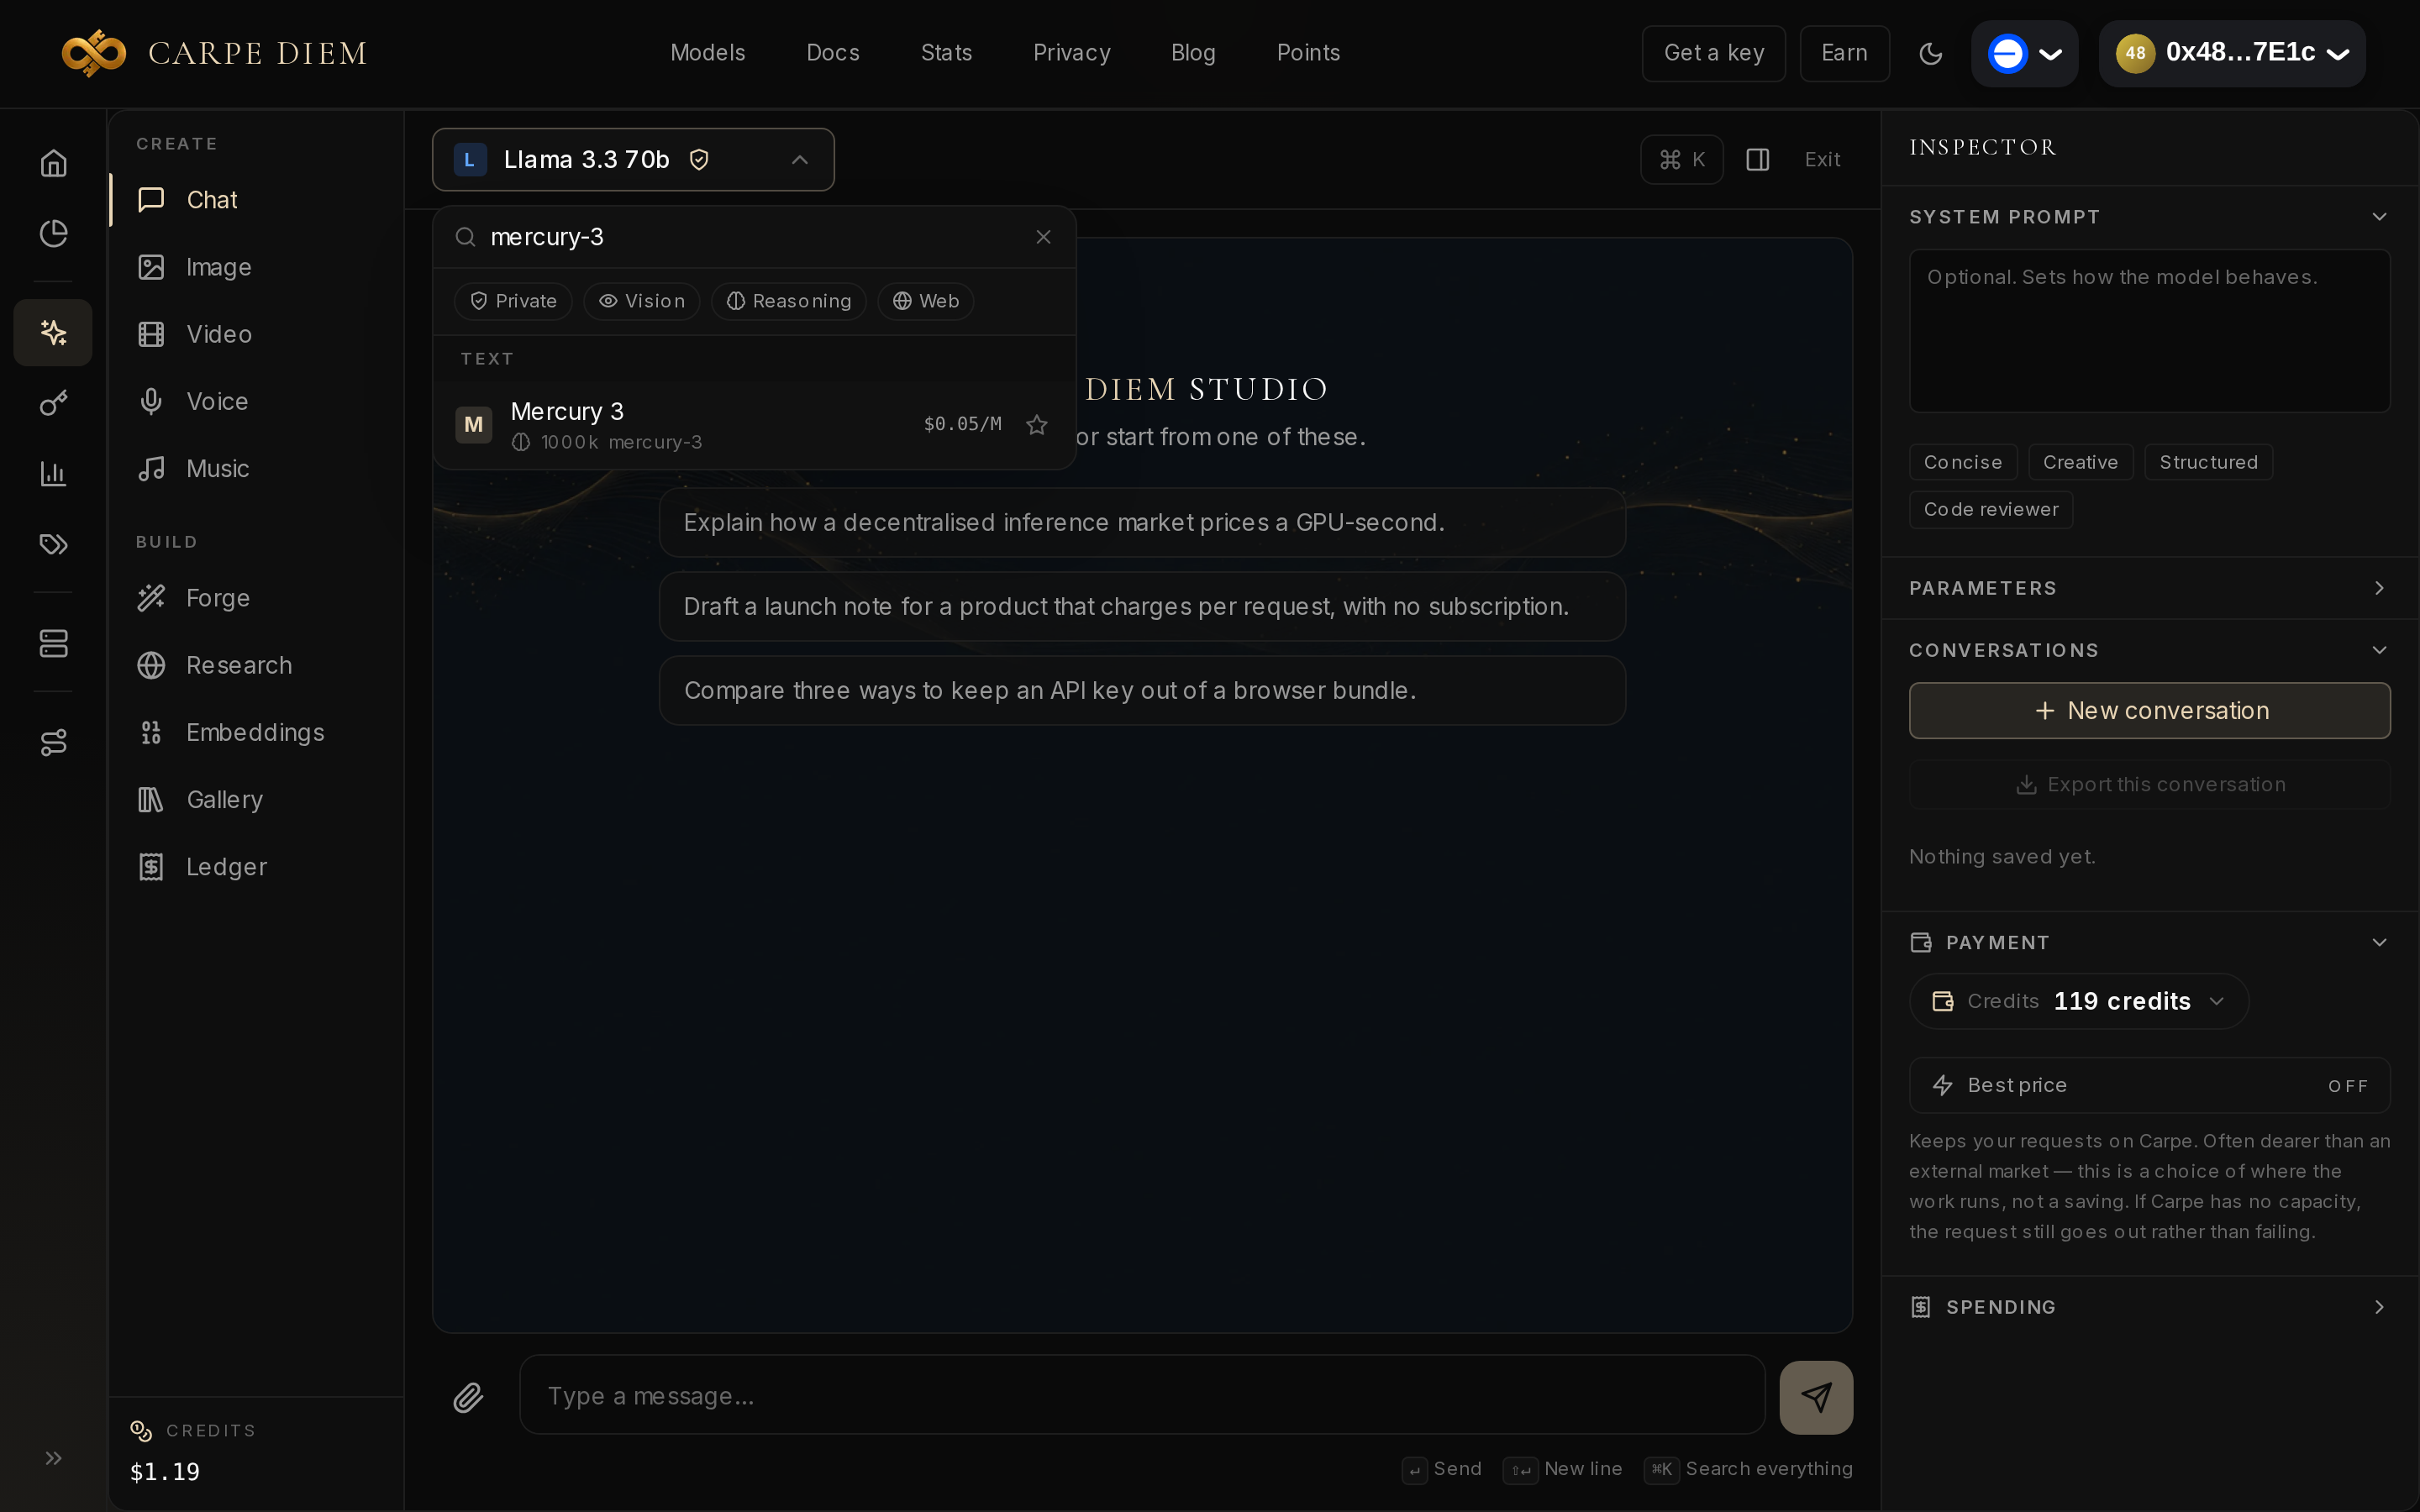
Probar Mercury 3 en el Hub o por la API
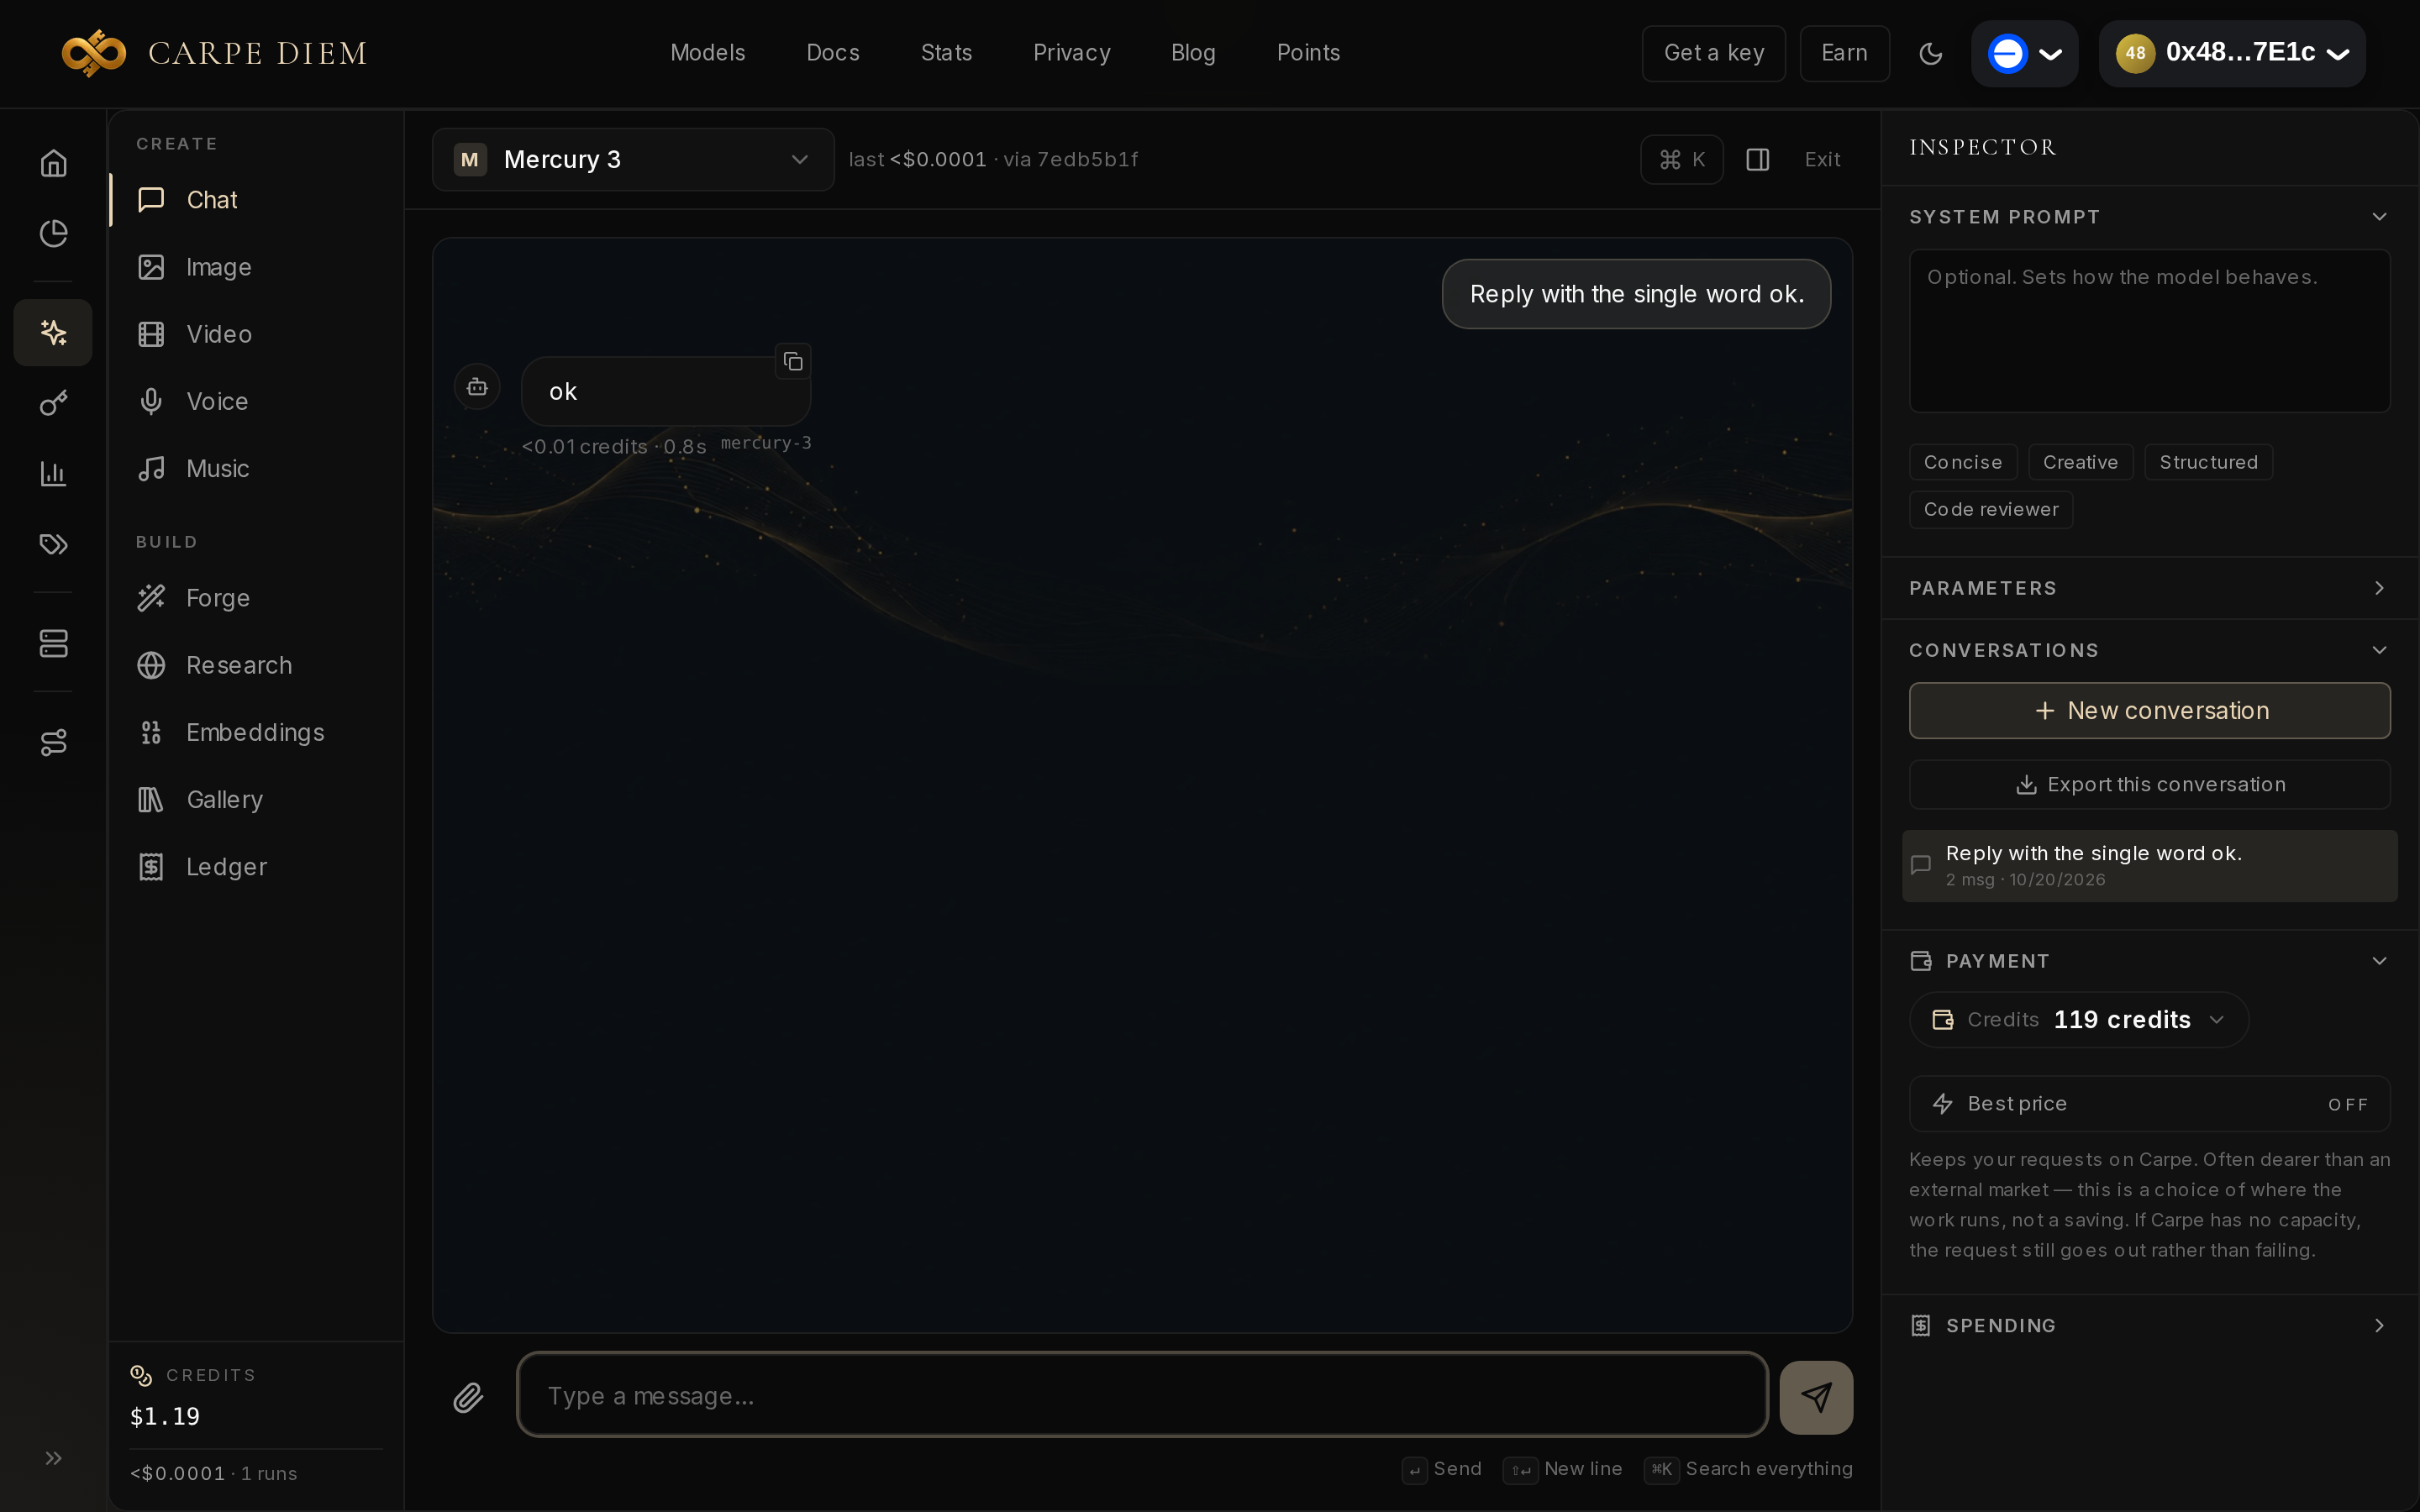
El estudio Chat de Create Hub basta: abra Chat, busque mercury-3, envíe una línea. Sin clave API, el wallet de sesión paga en créditos. Una instrucción de una palabra respondió ok en 0,8 s, por menos de 0,0001 $. Para la API, la siguiente llamada funcionó (respuesta ok, 0,9 s):
curl https://carpe-diem.xyz/api/operator/v1/chat/completions \
  -H "Authorization: Bearer cdm_your_key_here" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "mercury-3",
    "messages": [{"role": "user", "content": "Reply with the single word ok."}]
  }'
La clave se crea en el panel. La URL de base documentada para la API es https://carpe-diem.xyz/api/operator/v1 (documentación, referencia API). El playground se describe en el artículo Create Hub.