Mercury 3, LLM de difusão: 54 % abaixo da Venice na Carpe Diem
A Inception publicou o Mercury 3 a 19 de outubro de 2026. No dia seguinte, o identificador mercury-3 estava no catálogo da Carpe Diem. É um LLM de difusão: os tokens são refinados em paralelo, não um a um. O nosso banco de ensaios validou o raciocínio, a extração JSON e uma agulha em 2 500 palavras. Nas provas cotadas medimos 78 a 387 tokens/s de ponta a ponta, latência incluída. Não é comparável com os 1 068 tokens/s de descodificação pura anunciados pela Inception.
Ilustração gerada com seedream-v5-lite na Carpe Diem.
O que o Mercury 3 faz e o que testámos
O Mercury 3 é um modelo de texto da Inception Labs, sem imagem nem áudio à entrada, com 1 000 000 tokens de contexto. O pedido continua a ser um chat/completions clássico: o refinamento em paralelo corre no servidor, não no corpo do pedido. O catálogo atribui-lhe raciocínio, esforço de raciocínio, chamadas de função, esquema de resposta e pesquisa web. Vimos o raciocínio e um JSON conforme; não testámos as chamadas de função nem a pesquisa web.
A confidencialidade é anonymized: a Venice, fornecedor a montante da inferência, transmite o conteúdo ao fabricante sem lhe colar a sua identidade, ao contrário de um modelo private como o Llama 3.3 70B. O detalhe está na página de privacidade.
0,0464 $ / 0,1625 $ por milhão, 54 % abaixo da Venice
Carpe Diem revende a inferência do Mercury 3 através da Venice, daí a comparação com a tarifa pública da Venice.
| Entrada / M tokens | Saída / M tokens | |
|---|---|---|
| Carpe Diem | 0,0464 $ | 0,1625 $ |
| Venice | 0,1000 $ | 0,3500 $ |
A Inception publica 0,20 $ / 0,70 $ em lista e, no lançamento, 0,10 $ / 0,35 $ (50 % a menos). A Venice mostra esta tarifa de lançamento. Os preços Carpe Diem da tabela são os do banco de 20 de outubro de 2026; o catálogo pode mudar. A essa tarifa deste teste, 1 000 tokens de entrada e 1 000 de saída custam 0,00021 $; na Venice, 0,00045 $. Mil pedidos deste calibre: 0,21 $ contra 0,45 $.
O Llama 3.3 70B, proposto por omissão no Chat, está a 0,3032 $ / 1,2127 $ por milhão, com 128 000 tokens de contexto e inferência private. O MiniMax M3.1 Flash (minimax-m3-1-flash) está a 0,0812 $ / 0,3248 $ por milhão, com visão. Não o passámos no banco. Ambos continuam mais caros à entrada e à saída do que o Mercury 3.
As nossas medições de 20 de outubro de 2026
O banco debitou 0,00053 $ no total. Os tokens/s da tabela são os tokens de saída divididos pela duração total do pedido, latência de rede incluída: em 83 tokens de saída, 78 tokens/s dizem sobretudo que o pedido durou 1,1 s, não que a descodificação seja lenta. Não medimos o tempo até ao primeiro token.
| Prova | Resultado | Duração | Tokens/s | Custo |
|---|---|---|---|---|
| Raciocínio (resposta única) | OK, 40000 | 2,4 s | 387 | 0,00018 $ |
| Extração JSON | conforme | 1,1 s | 78 | 0,00004 $ |
| Agulha (~2 500 palavras) | encontrada | 1,5 s | 132 | 0,00008 $ |
| Redação em francês | não cotada (julgada à leitura) | 1,6 s | 228 | 0,00008 $ |
No raciocínio pedíamos o limiar em que um plano fixo de 12 $ mais 0,40 $ por mil pedidos fica estritamente mais barato do que 0,70 $ por mil. Com r em milhares de pedidos por mês, o modelo pôs 12 + 0,40r < 0,70r, depois r > 40, e respondeu 40000, o valor esperado. Este pedido faturou 944 tokens de saída por umas quantas linhas visíveis.
A saída JSON devolveu vendor, amount_usdc 42.50, date 2026-03-03 e as duas linhas de artigos, sem campo a mais.
Em francês, o texto trata o leitor por tu e permanece genérico. O código não foi cotado.
Quando o Mercury 3 vale a pena
Escolhê-lo-íamos para extração JSON a baixo custo: um ensaio único ficou conforme em 1,1 s, debitado 0,00004 $. Valide nos seus próprios documentos antes de passar a volume. O raciocínio curto (limiar tarifário) acertou em 2,4 s.
Evite-o se precisar de um modelo private ou de imagem à entrada. O Llama 3.3 70B continua a ser a opção por omissão do estúdio Chat, com 128 000 tokens de contexto.
Experimentar o Mercury 3 no Hub ou pela API
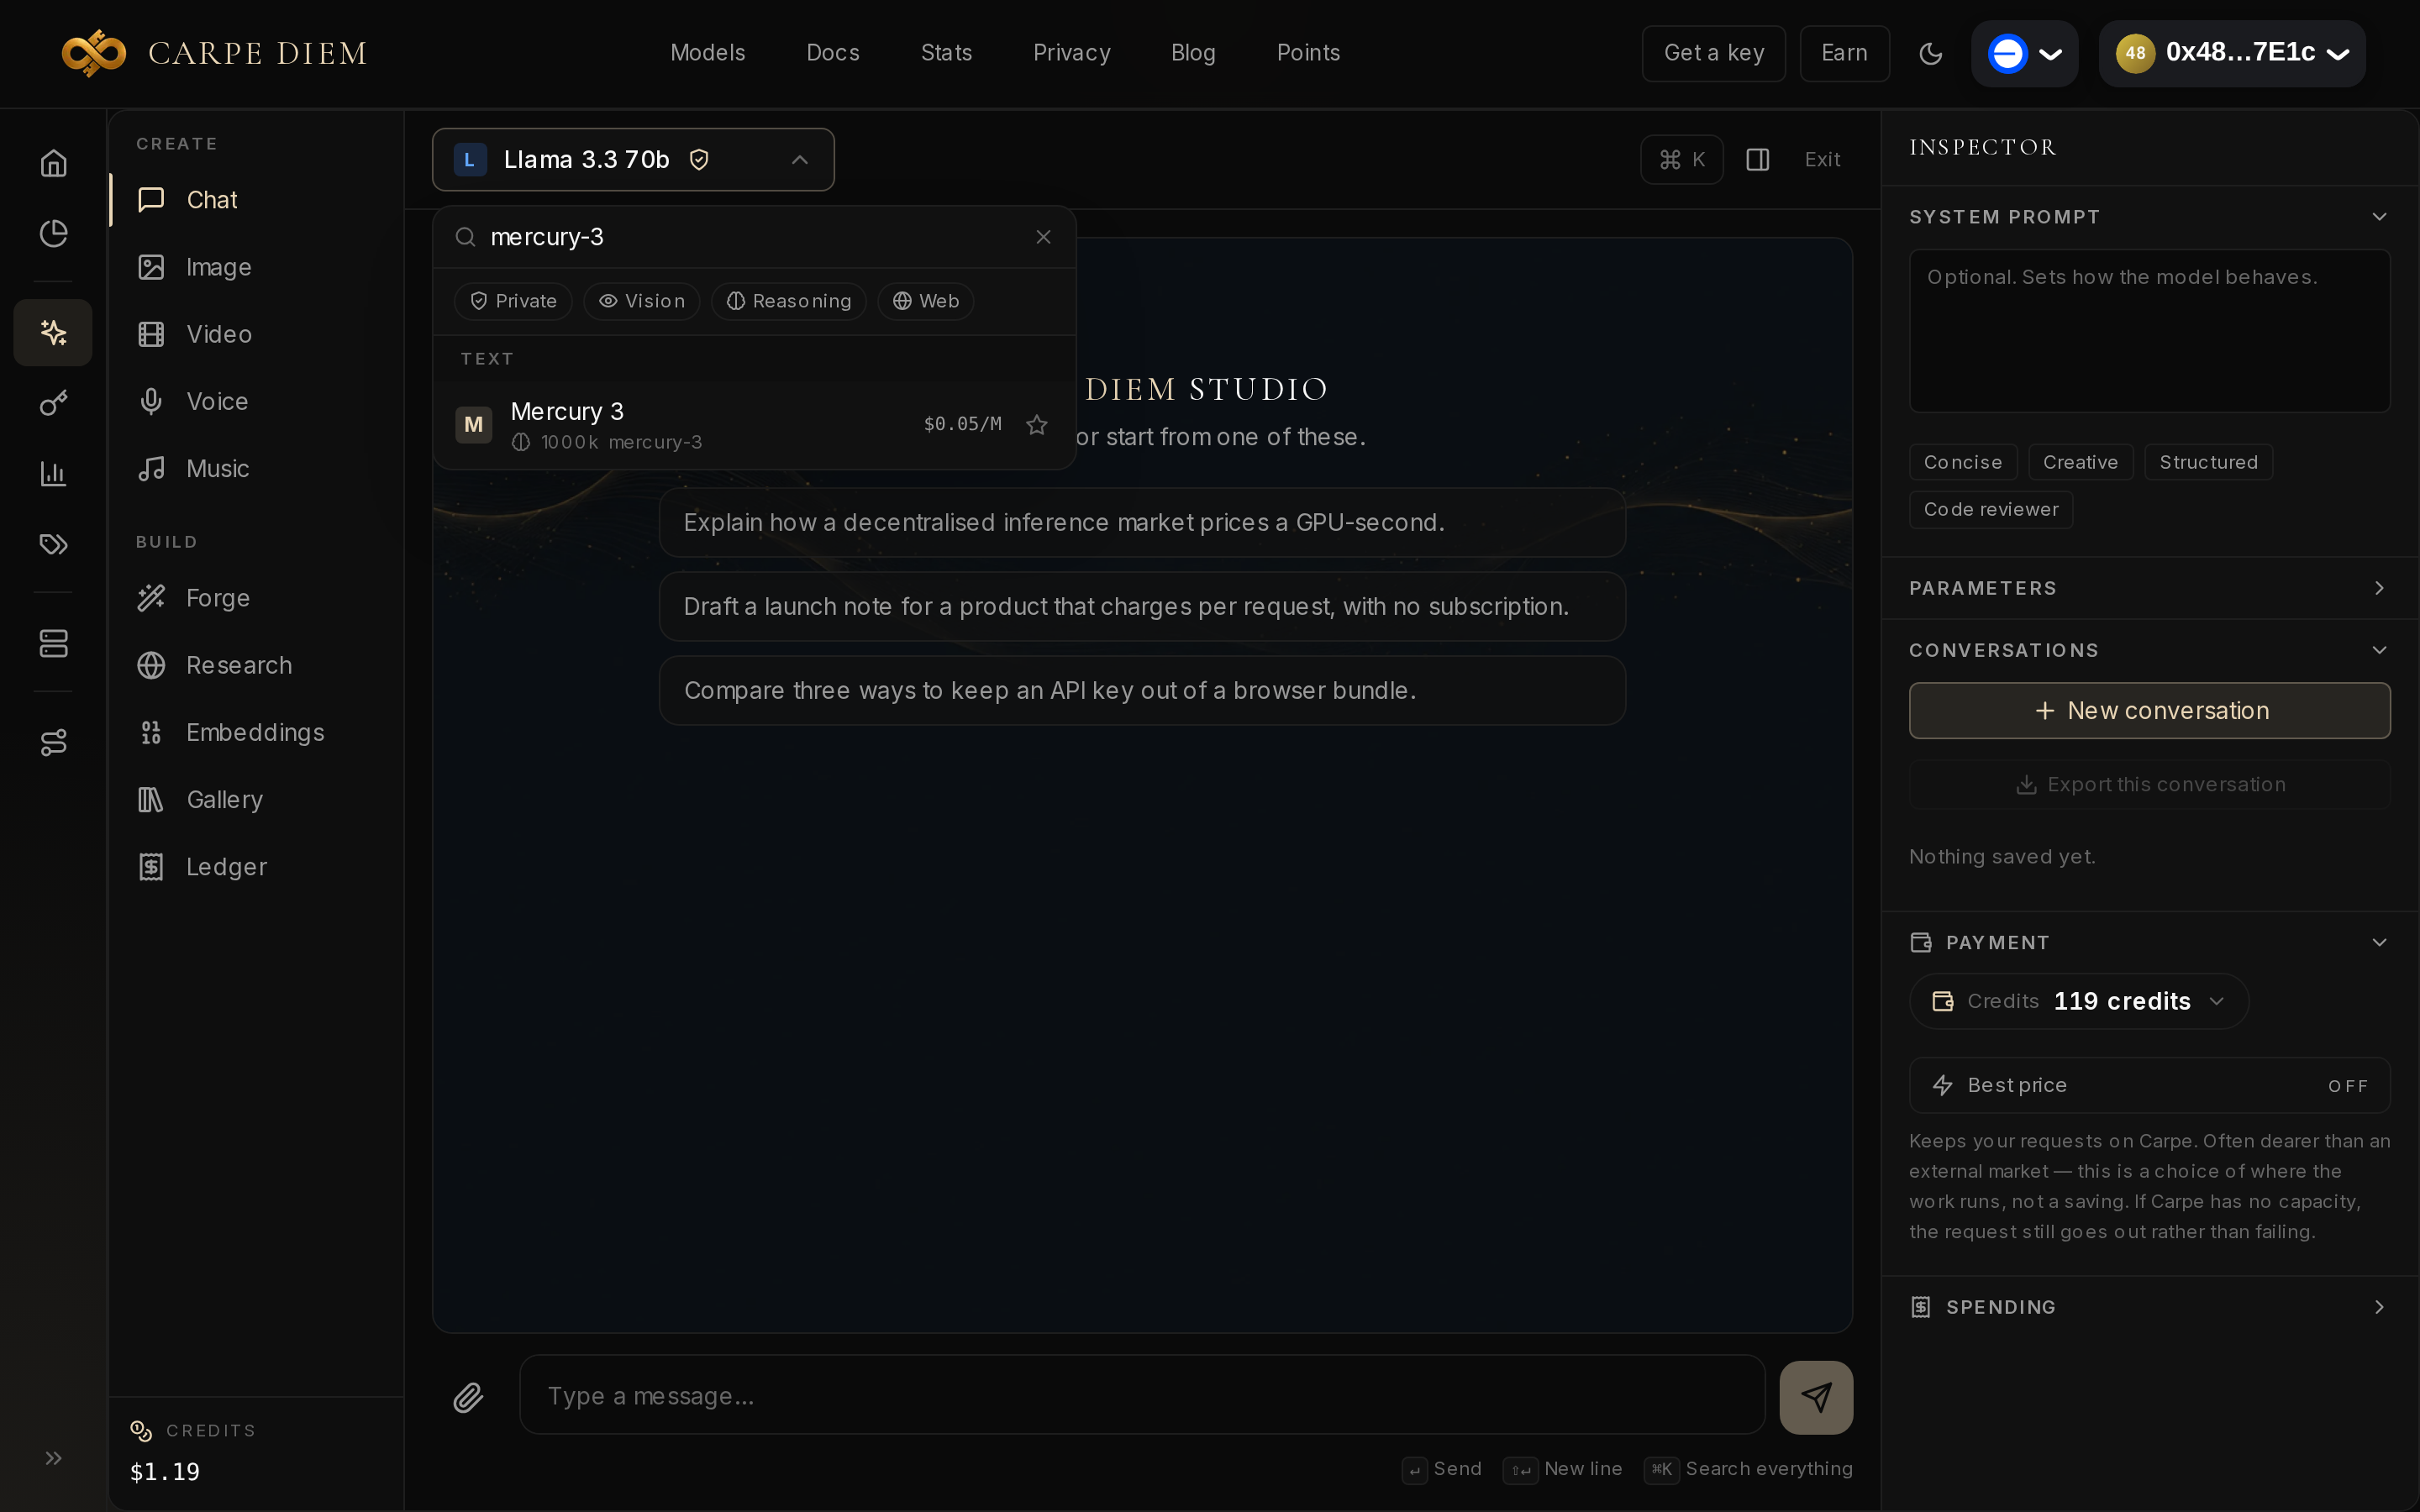
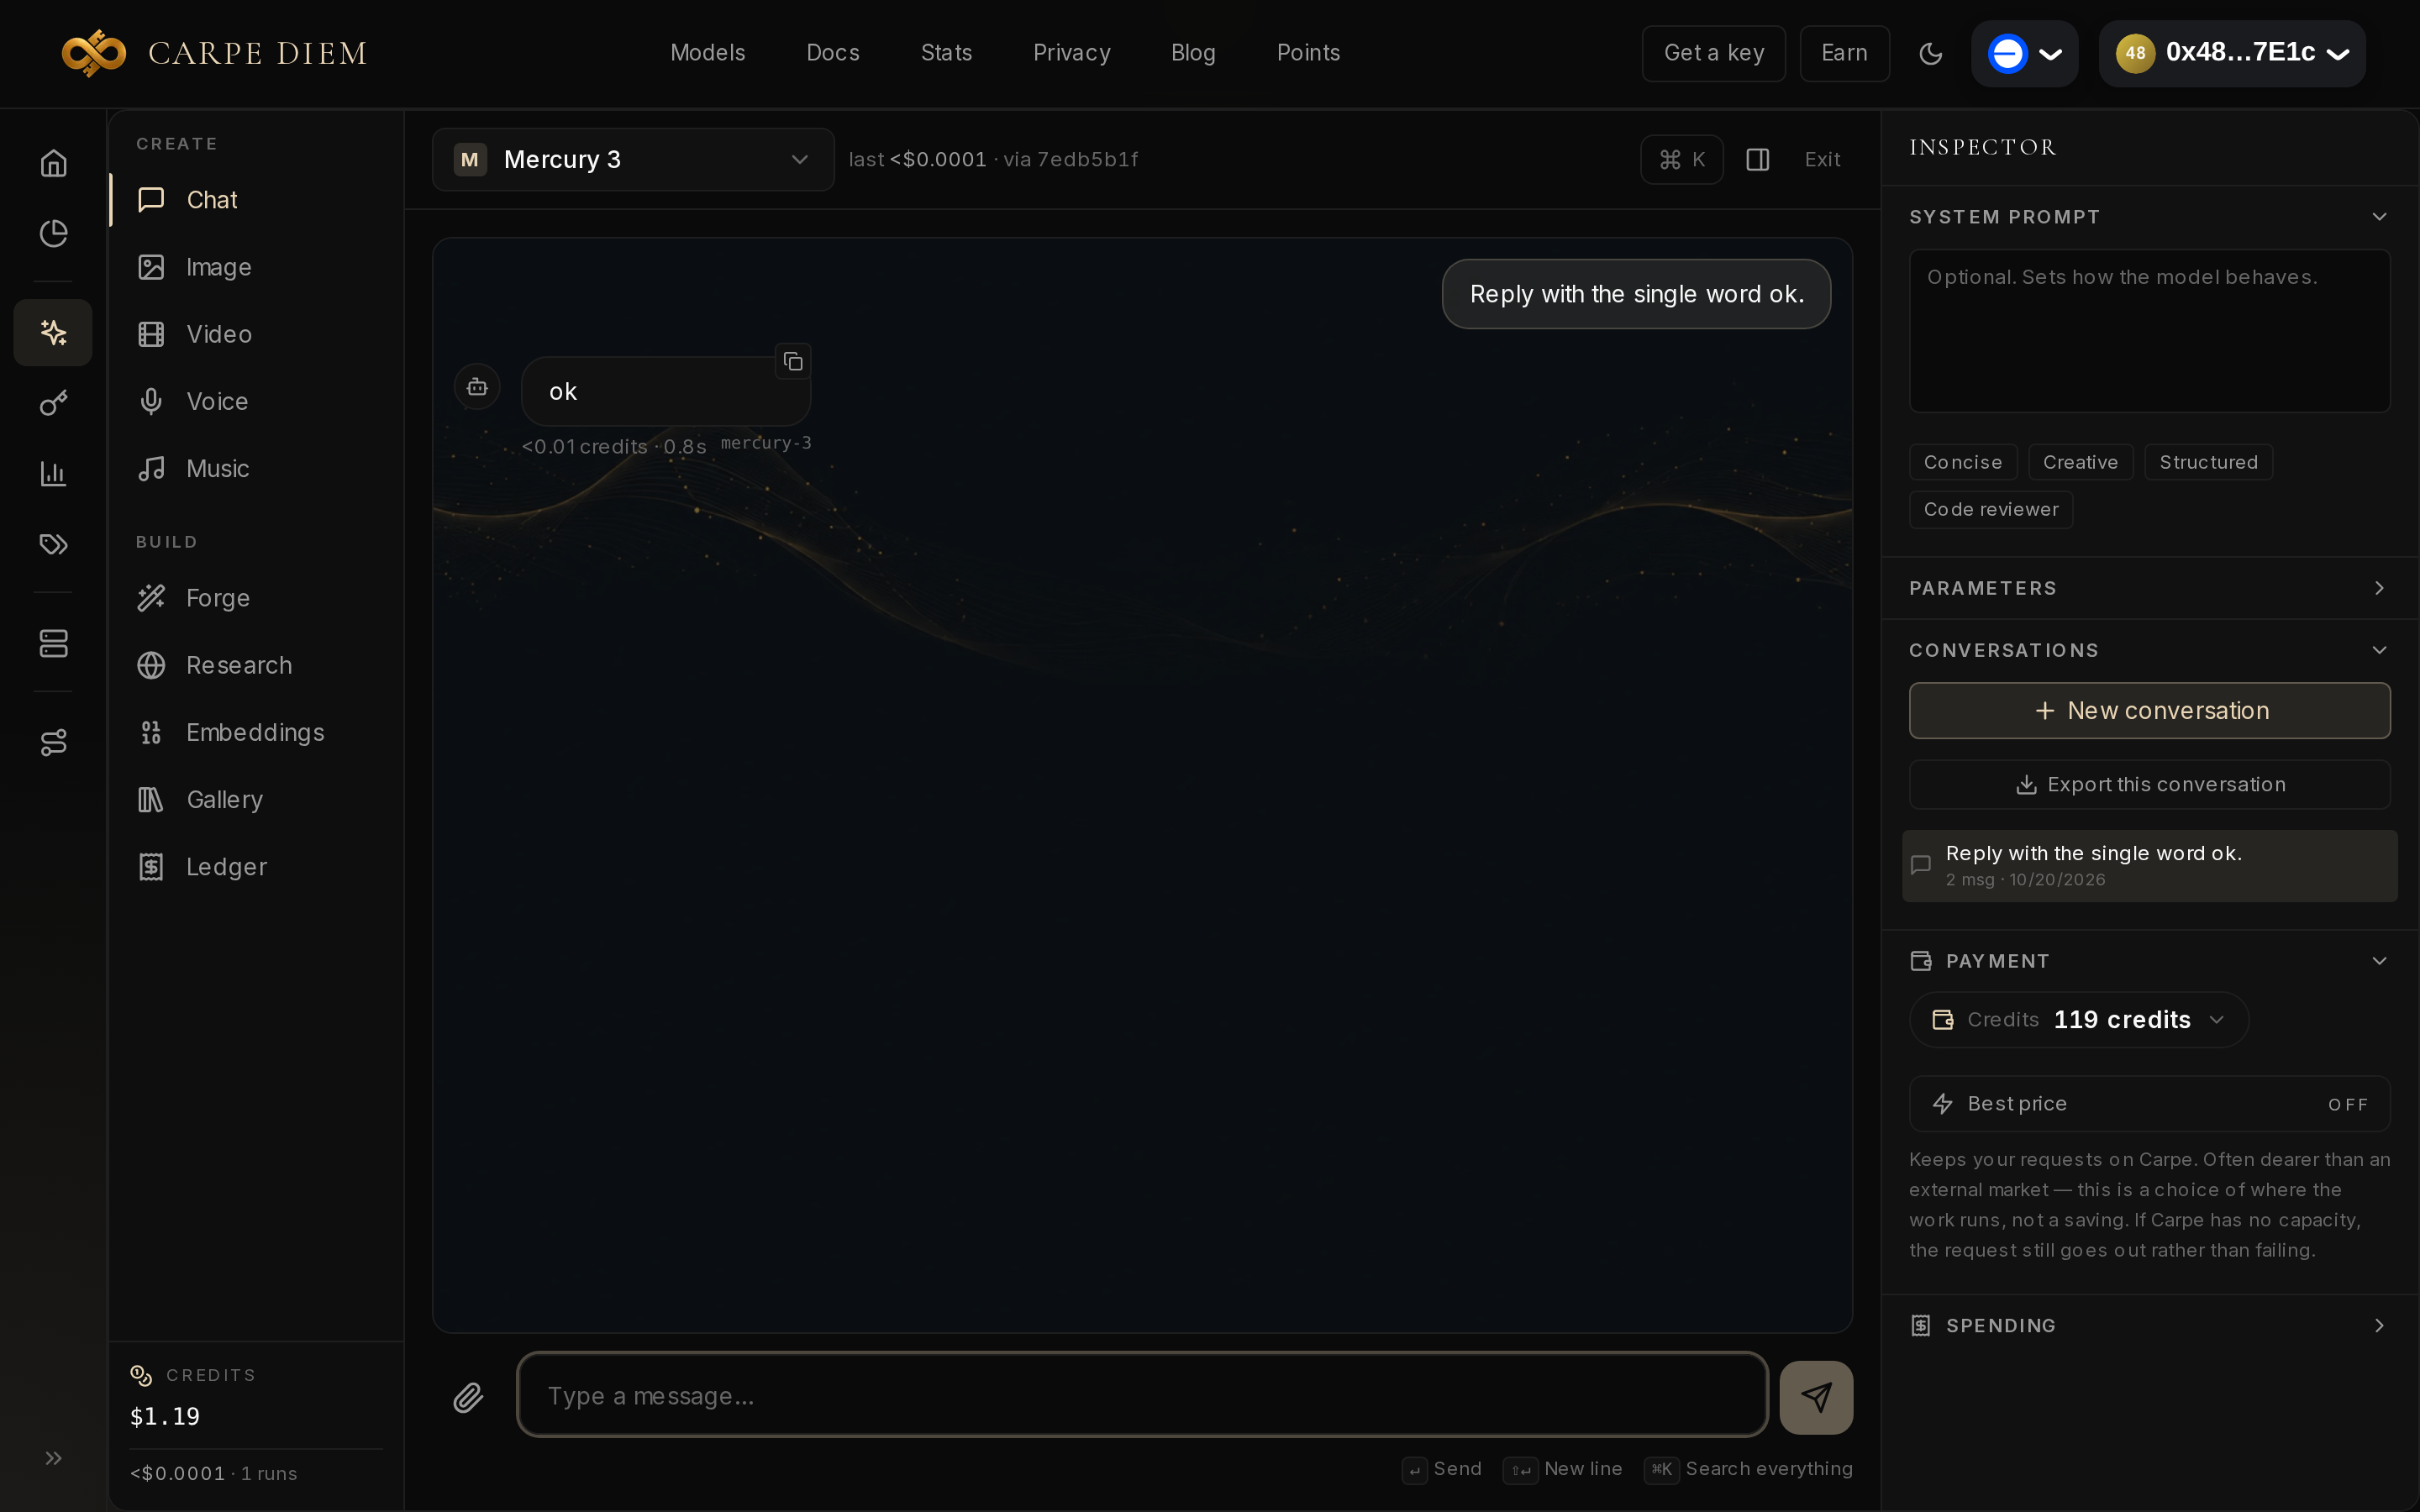
O estúdio Chat do Create Hub chega: abra Chat, procure mercury-3, envie uma linha. Sem chave API, a carteira da sessão paga em créditos. Um prompt de uma palavra respondeu ok em 0,8 s, por menos de 0,0001 $. Para a API, o seguinte pedido correu (resposta ok, 0,9 s):
curl https://carpe-diem.xyz/api/operator/v1/chat/completions \
  -H "Authorization: Bearer cdm_your_key_here" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "mercury-3",
    "messages": [{"role": "user", "content": "Reply with the single word ok."}]
  }'
A chave cria-se no painel. O URL de base documentado para a API é https://carpe-diem.xyz/api/operator/v1 (documentação, referência API). O playground está descrito no artigo Create Hub.