Mercury 3, Diffusions-LLM: 54 % unter Venice auf Carpe Diem
Inception hat Mercury 3 am 19. Oktober 2026 veröffentlicht. Am nächsten Tag lag die Kennung mercury-3 schon im Katalog von Carpe Diem. Es ist ein Diffusions-LLM: Tokens werden parallel verfeinert, und nicht einzeln. Unser Testlauf hat Reasoning, JSON Extraktion und eine Nadel in 2 500 Wörtern bestätigt. Bei den bewerteten Prüfungen haben wir 78 bis 387 Tokens/s Ende zu Ende gemessen, Latenz inklusive in dieser Zahl. Das ist nicht vergleichbar mit den 1 068 reinen Decode-Tokens/s, die Inception nennt.
Illustration erzeugt mit dem Modell seedream-v5-lite auf Carpe Diem.
Was Mercury 3 tut, und was wir getestet haben
Mercury 3 ist ein Textmodell von Inception Labs, ohne Bild-Eingang und ohne Audio-Eingang, mit 1 000 000 Tokens Kontext. Der Aufruf bleibt ein klassisches chat/completions: die parallele Verfeinerung läuft auf dem Server, nicht im Body der Anfrage. Der Katalog schreibt ihm Reasoning, Reasoning Effort, Aufrufe von Funktionen, Schema der Antwort und Suche im Web zu. Wir haben Reasoning und konformes JSON gesehen; Aufrufe von Funktionen und Suche im Web haben wir nicht getestet.
Die Vertraulichkeit ist anonymized: Venice, der Anbieter der Inferenz stromaufwärts, leitet den Inhalt an den Hersteller weiter, ohne deine Identität anzuhängen, anders als bei einem private-Modell wie Llama 3.3 70B. Details stehen auf der Seite zum Datenschutz.
0,0464 $ / 0,1625 $ je Million, 54 % unter Venice
Carpe Diem verkauft die Inferenz von Mercury 3 über Venice weiter, und deshalb vergleichen wir mit dem öffentlichen Tarif von Venice.
| Eingabe / M Tokens | Ausgabe / M Tokens | |
|---|---|---|
| Carpe Diem | 0,0464 $ | 0,1625 $ |
| Venice | 0,1000 $ | 0,3500 $ |
Inception nennt einen Listenpreis von 0,20 $ / 0,70 $ und, zum Start, einen Preis von 0,10 $ / 0,35 $ (50 % weniger). Venice zeigt diesen Starttarif. Die Preise auf Carpe Diem in der Tabelle sind die des Bench vom 20. Oktober 2026; der Katalog kann sich ändern. Zu dem Tarif dieses Bench kosten 1 000 Tokens der Eingabe und 1 000 Tokens der Ausgabe 0,00021 $; bei Venice 0,00045 $. Tausend Anfragen dieses Zuschnitts kosten 0,21 $ gegen 0,45 $.
Llama 3.3 70B, in Chat der Standard, steht bei 0,3032 $ / 1,2127 $ je Million, für 128 000 Tokens Kontext und eine Inferenz private. MiniMax M3.1 Flash (minimax-m3-1-flash) steht bei 0,0812 $ / 0,3248 $ je Million, mit Vision. Wir haben es nicht getestet. Beide bleiben bei der Eingabe und bei der Ausgabe teurer als Mercury 3.
Unsere Messungen vom 20. Oktober 2026
Der Testlauf hat insgesamt 0,00053 $ belastet. Die Tokens/s in der Tabelle sind Tokens der Ausgabe geteilt durch die Gesamtdauer des Aufrufs, Latenz im Netz inklusive: bei 83 Tokens der Ausgabe sagen 78 Tokens/s vor allem, dass der Aufruf 1,1 s dauerte, und nicht dass das Decoding langsam ist. Die Zeit bis zu dem ersten Token haben wir nicht gemessen.
| Prüfung | Ergebnis | Dauer | Tokens/s | Kosten |
|---|---|---|---|---|
| Reasoning (eine Antwort) | OK, 40000 | 2,4 s | 387 | 0,00018 $ |
| JSON-Extraktion | konform | 1,1 s | 78 | 0,00004 $ |
| Nadel (~2 500 Wörter) | gefunden | 1,5 s | 132 | 0,00008 $ |
| Französischer Text | nicht bewertet (nach dem Lesen beurteilt) | 1,6 s | 228 | 0,00008 $ |
Das Reasoning fragte nach der Schwelle, ab der ein Tarif von 12 $ plus 0,40 $ je tausend Anfragen strikt günstiger ist als 0,70 $ je tausend. Mit r in Tausend Anfragen pro Monat setzte das Modell 12 + 0,40r < 0,70r, dann r > 40, und antwortete 40000, das ist die erwartete Zahl. Dieser Aufruf hat 944 Tokens der Ausgabe für ein paar sichtbare Zeilen berechnet.
Das JSON lieferte vendor, amount_usdc 42.50, date 2026-03-03 und die zwei Positionen, und zwar ohne Extrafeld.
Der französische Text duzt den Leser und er bleibt generisch. Der Code wurde nicht bewertet.
Wann sich Mercury 3 lohnt
Wir würden es für eine günstige Extraktion von JSON nehmen: ein einzelner Lauf war in 1,1 s konform, belastet mit 0,00004 $. Prüfe das bitte an deinen eigenen Dokumenten, bevor du in die Menge gehst. Das kurze Reasoning (Schwelle des Tarifs) lag in 2,4 s richtig.
Meide es, wenn du ein private Modell oder Eingabe von Bildern brauchst. Llama 3.3 70B bleibt die Vorgabe im Studio Chat, mit 128 000 Tokens an Kontext.
Mercury 3 im Hub oder per API testen
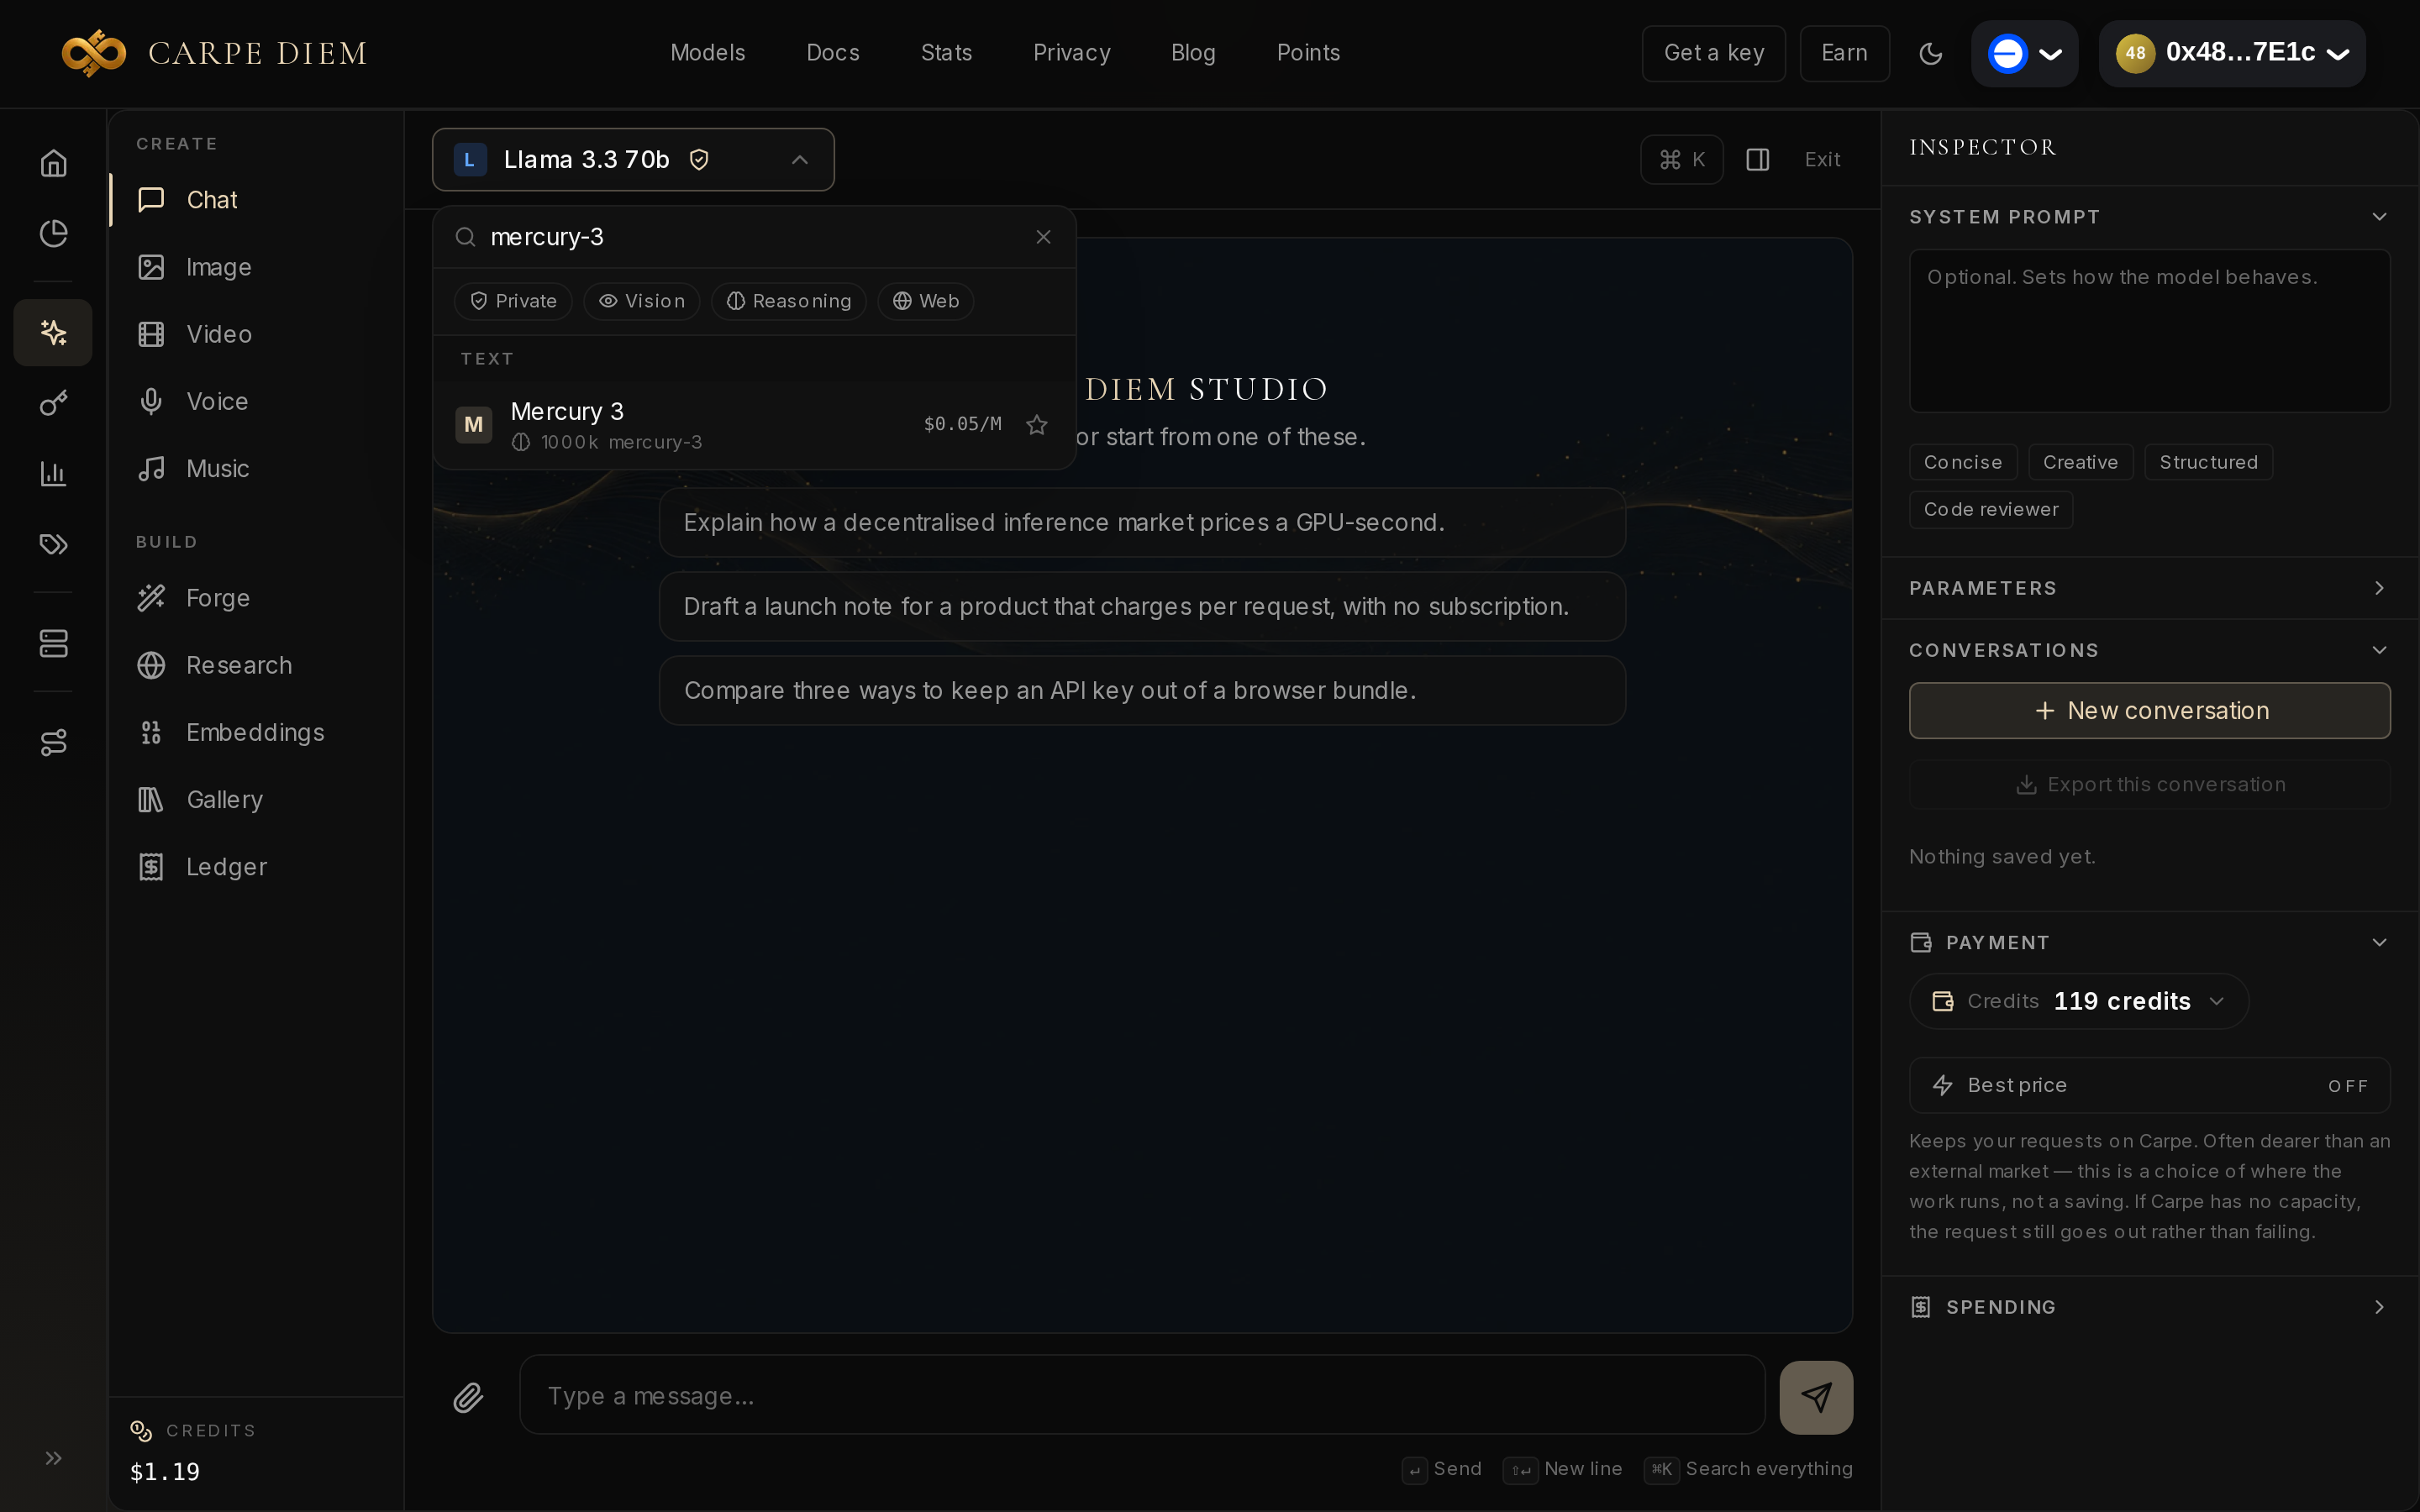
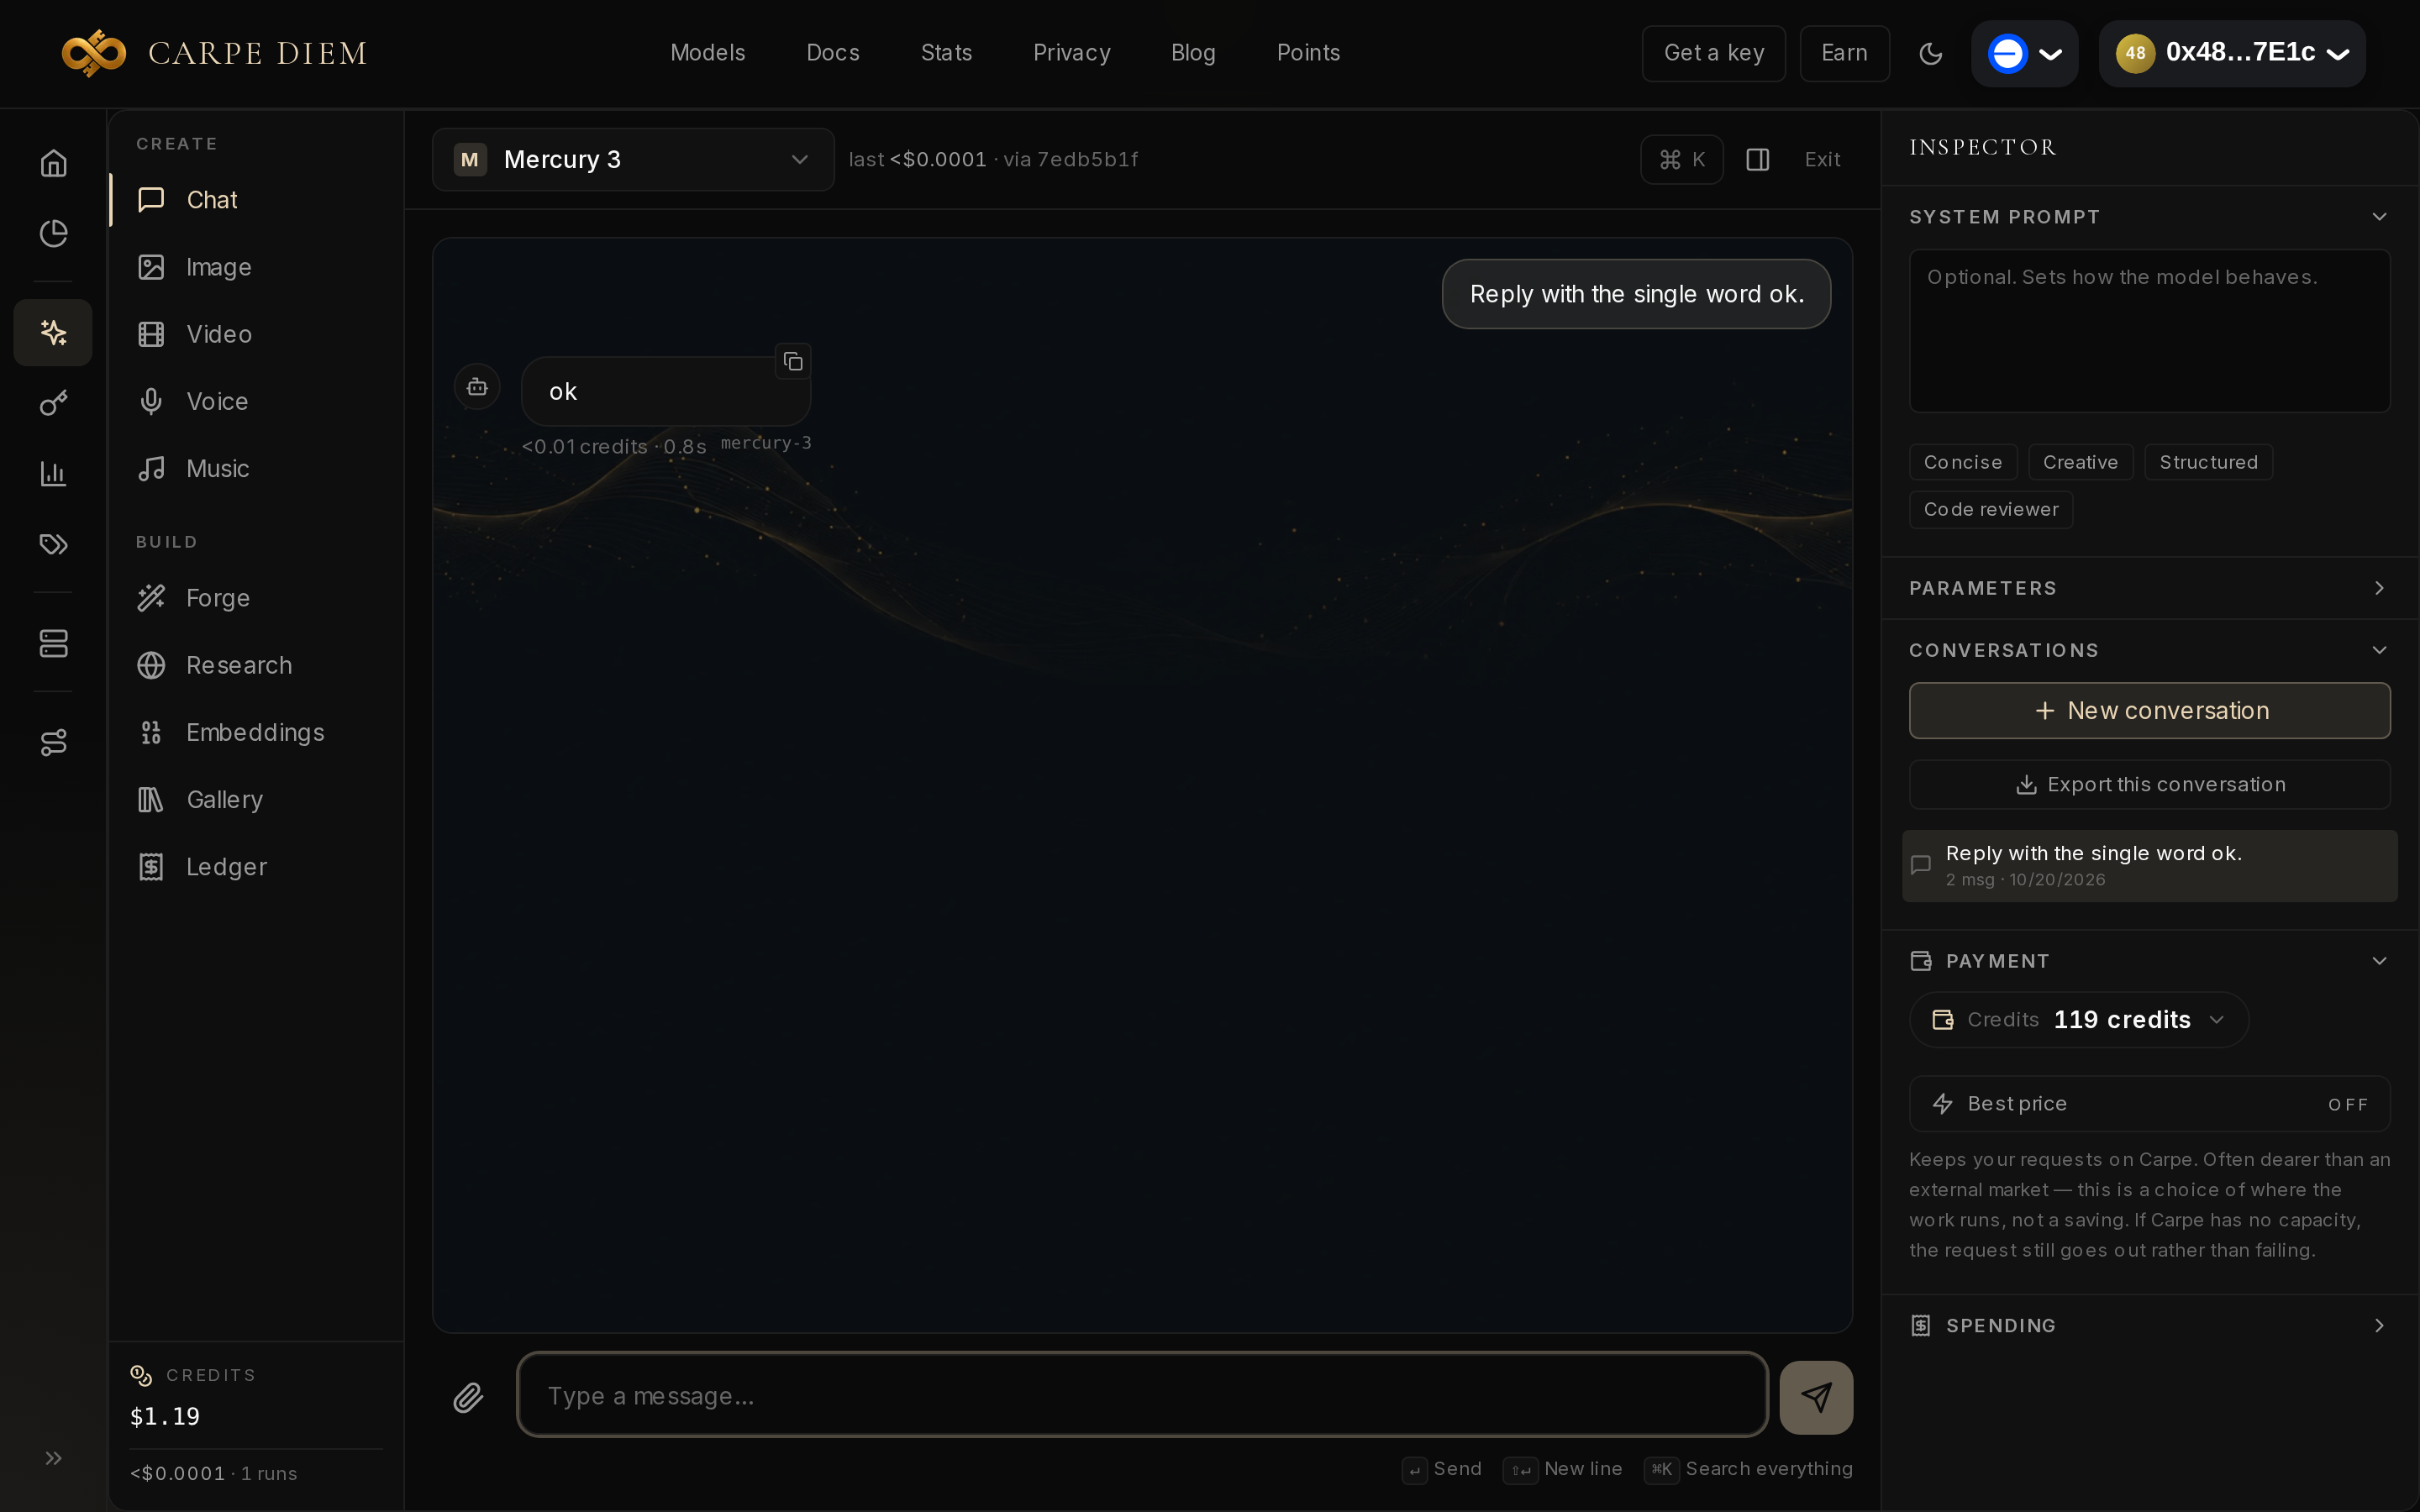
Das Chat-Studio in Create Hub reicht für sich: öffne Chat, suche mercury-3, dann schick eine Zeile. Du brauchst dafür keinen API Key; die Wallet der Sitzung zahlt in Credits. Eine Eingabe aus einem Wort hat ok in 0,8 s geliefert, für unter 0,0001 $. Für die API ist dieser Aufruf gelaufen (Antwort ok, 0,9 s):
curl https://carpe-diem.xyz/api/operator/v1/chat/completions \
  -H "Authorization: Bearer cdm_your_key_here" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "mercury-3",
    "messages": [{"role": "user", "content": "Reply with the single word ok."}]
  }'
Den Key erstellst du im Dashboard selbst. Die dokumentierte Basis URL der API ist https://carpe-diem.xyz/api/operator/v1 (Dokumentation, API-Referenz). Der Playground steht im Artikel Create Hub.